AI智能体记忆全解析:四层结构与“做梦”机制
Anthropic拆解智能体记忆的四层架构与“做梦”机制,揭示该记什么、怎么记。
本文结合Anthropic《The Components of Agent Memory》与My2Cents AI的解读,系统梳理智能体记忆。Anthropic将其定义为跨会话保留的可读上下文,排除模型权重、会话内学习与compaction。记忆分四层:transcripts、memory notes、representations、injected context,做梦机制贯穿全栈,负责修正错误笔记、搭建wiki、提升顶层注入、对准目标和填补空缺。CLBench测试显示记忆是一种预测性下注,Opus 5率先闭合“记录失败→形成理论→测试→变成规则”的循环。宝可梦实验表明,存环境不会告诉你的信息(目标、计划、验证过的规则)优于事无巨细记录。文章建议说明记忆用途而非规定做法,并指出token成本与错误扩散等未解问题。
AI智能体如何在两次会话之间记住东西?Anthropic发布的研究文章《The Components of Agent Memory》给出了一个系统性的拆解。本文结合YouTube频道My2Cents AI的解读,梳理智能体记忆的定义、四层架构、该存什么,以及一个反直觉的机制——让智能体“做梦”。
什么算记忆?三样东西不算
Anthropic把智能体记忆定义为:Claude从经验中获得、并在会话之间保留为可读取上下文的知识。
有三样东西被明确排除在外:模型权重本身、一次对话内部学到的东西,以及compaction——用摘要替换较早轮次的机制。这些都属于上下文,而非跨会话记忆。
这个界定很关键。它意味着记忆不是模型能力的延伸,而是一套外挂的、可读写、可审计的知识系统。
Compaction(上下文压缩) 是指在单次会话内,当对话历史逼近模型上下文窗口上限时,用一段摘要替换较早轮次原始内容的机制。它解决的是“这一刻还能不能继续对话”的问题,压缩后的摘要仍属于当前上下文的组成部分,会话结束即消失,不会被保留到下一次会话。因此 Anthropic 将其排除在智能体记忆之外:compaction 是上下文管理手段,跨会话记忆则是独立于模型权重、可持久读写的外部知识系统,二者在生命周期和可审计性上有本质区别。
记忆的四个层级
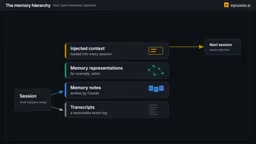
从下往上,记忆分成四层:
第一层:transcripts(工作记录)。智能体工作的可搜索日志,一切记忆的原料。
第二层:memory notes(记忆笔记)。Claude在工作过程中自己写下的笔记。
第三层:representations(表征)。类似互相链接的wiki页面,把零散笔记组织成结构。
第四层:injected context(注入上下文)。每次新会话都会自动加载的内容,位于最顶层。
“做梦”机制贯穿整个栈:它读transcripts来修正笔记、搭建wiki、并决定下次加载什么。
记忆是一种预测
Anthropic的核心观点是:记忆可以是一个预测,一次“这条笔记将来还会派上用场”的下注。
他们用CLBench基准测试这种下注能力。每道题在全新会话中运行,Claude随后看到正确答案,只有记忆文件夹在会话间传递。理想的循环是:记录失败→形成理论→测试→变成规则。
测试结果分化明显。Sonnet 4.6卡在未经验证的理论上,几乎没有进步。Opus 5是受测模型中第一个闭合这个循环的,分数从0.56跃升到0.83。
CLBench 是 Anthropic 用于评估智能体“记忆判断力”的基准测试。其设计要点在于隔离记忆变量:每道题都在全新会话中运行,模型看不到之前的对话历史,唯一在会话之间传递的是它的记忆文件夹。这样,分数的变化就只能归因于模型往记忆里写了什么、下次又读出了什么。理想的解题循环是“记录失败→形成理论→测试→沉淀为规则”,CLBench 衡量的正是模型能否闭合这一循环,而非单轮推理能力。
宝可梦实验:什么值得记下来?
《Pokemon Red》大约一万步的实验,把“判断力”变成了可观察的指标。
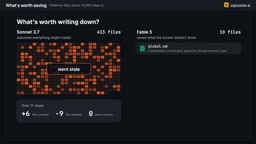
Sonnet 3.7几乎什么都存,每场战斗、每个道具、每个角色各一个文件。但游戏状态不断变化,这些文件很快过期。有一段时间,它在17步里创建了6个文件、删除了9个,却没执行任何游戏动作。
Fable 5存的是屏幕上看不到的东西:目标、计划、以及它验证过的规则——比如“连续三个精灵球失败就换时机”。
Opus 5.5同样保持小文件夹,并通关了游戏。
那要不要直接告诉模型怎么做笔记?文章的建议是:解释记忆是用来干什么的,而不是怎么用。固定规则(比如“只记录失败”)会让强模型损失大部分收益。但对老模型,引导帮助最大——让Sonnet 4.6去读记忆、测试理论,分数几乎翻倍。Sonnet 5则自己就会这么做,十次里有九次先读记忆。
《Pokemon Red》实验 是 Anthropic 用来观察记忆“判断力”的长程智能体测试环境,全程约一万步。选择这款游戏,是因为它天然具备长程目标、隐藏状态(如对手队伍、地图未探索区域)和大量易过期的局部信息,能逼出“该记什么、不该记什么”的取舍。实验对比了不同模型在相同框架下的记忆文件夹规模与内容:存得越多不等于越好,文件随游戏状态快速过期反而拖累行动;而只记录目标、计划和已验证规则的小文件夹,往往能走得更远直至通关。
做梦的五个工种
修正错误笔记。一次运行中,Claude把地标记在了月见山的错误一侧,写下“月见山,完成”。其实没有。随后它走上单向路线,从 ledge 掉回原路。做梦机制对照transcript发现了错误并重写笔记,Claude重返后抵达了华蓝市。没有修正,它三次掉下 ledge 退回尼比市;完全没有记忆,它从未到达。
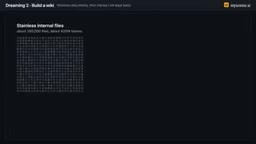
搭建新结构。Claude从Anthropic收购的Stainless约35万份内部文件中“梦”出一个wiki。在128次会话中,Opus 5智能体撰写、链接页面、合并重复、对照来源核查。测试题上,纯wiki从13%提升到48%;纯搜索保持53%;wiki加搜索达到61%,且token更少。但在法律任务中——多数答案集中在单一文档里——wiki相对纯搜索没有明显增益。还有一个wiki长得比它的来源还大,地图和疆域一样大。
把笔记提升到顶层,让它们自动加载进每次会话。代价是token,而且一条错误笔记会扩散到所有会话,指令越长越不被严格遵循。所以顶层必须保持小。Claude Code的auto-memory就遵循这个原则:只加载memory.md的前200行、25KB,作为“Claude知道什么、去哪找”的索引。
让记忆对准目标。一个法律任务中,基础指令下多个智能体同时写一张共享的合同条款表,互相擦掉对方的行,简报只拿到57个事实中的41个。Anthropic跑了一个循环:Claude反思失败,重写建wiki的指令——每份合同一页,术语逐字引用——57个全中。
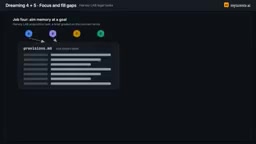
填补空缺。第二遍扫描发现九条指向不存在页面的链接,重新指向。
实践要点与未解问题
作者总结了几条原则:存环境不会告诉你的东西;保持记忆经过策展、顶层要小;说明记忆的用途;让智能体去做梦。
开放问题同样真实。任务中途写记忆会分散注意力,而做梦的成果要等到之后才出现;维持记忆的时效性需要消耗算力。正如文章所说,没有模型能真正知道未来几轮会发生什么,做梦让它回头看。
原文见Anthropic官网《The Components of Agent Memory》。
背景补充
Auto-memory 是 Claude Code 中把部分记忆自动注入每次会话的机制。它遵循“顶层要小”的原则:只加载 memory.md 的前 200 行、约 25KB,作为“Claude 知道什么、去哪里找”的索引,而非把全部记忆塞进上下文。这样做是在召回率与 token 成本之间取舍——顶层注入保证关键索引始终可见,细节则留在下层按需检索;同时限制体量也能降低单条错误笔记扩散到所有会话、以及长指令被模型忽略的风险。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
Anthropic智能体记忆架构:少即是多的记忆哲学
Anthropic通过Pokemon Red实验揭示智能体记忆的反直觉结论:保存413个文件的Claude反而不如维护简短仪表盘的Claude。本文解析四层记忆架构、Dreams离线修正机制与CLAUDE.md最佳实践。