Claude Code额度不够用?实测哪些技巧真省额度
实测显示换模型或降 effort 能省额度,四个上下文技巧在短会话中几乎无效。
文章通过控制变量实测了 Claude Code 在 20 美元套餐下的额度消耗。三个关联任务中,Opus 用掉 16% 额度,Haiku 仅用约 1%,且全部通过测试。降低 Opus 的 effort 也能让额度减半。而 /clear、/compact、plan mode 和裁剪测试输出的 hook 四个上下文技巧,在短会话中均未带来可测量的节省,/compact 反而更贵。作者指出,短会话中费用大头是模型输出,因此换模型和降 effort 最有效;长会话中重复读取对话占比升高,上下文技巧的意义可能翻转,但尚未实测。
开场:同样的任务,用量差出16倍
三个关联的编程任务,同一个 Claude Code,同样是20美元套餐。用 Opus 跑,5小时额度用掉16%;换 Haiku,只用了约1%。而且六个任务全部通过了测试和浏览器检查。
这个对比来自一个实测视频。作者用三个来自团队聊天应用、放在空文件夹里的关联任务做基准,每次只改一个变量,每个配置跑两遍,前后读取额度表。在给出结论之前,先理清额度到底花在哪。
额度消耗的真实构成
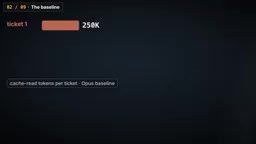
Opus 运行时,额度表的读数在三个任务后依次是 4%、10%、16%,每完成一个任务,消耗都会上升。原因很直接:每条消息都会把整段对话重新发送一遍,会话越长,重复读取的上下文越多。作者观察到,到第三个任务时,超过九成的 token 是对话被重复读取。
但缓存读取本身很便宜。按标价估算,大约一半的费用来自 Claude 自己的输出,也就是代码和解释;思考阶段约三成花在写入缓存;重复读取对话不到五分之一。这是按标价算的账,不是套餐本身的计费公式,但它能解释后面大多数现象。
还有一个重要的基准:两次 Opus 运行在完全没改动的情况下,费用相差14美分、额度表相差一个点。所以作者只把「两次运行都超过这一噪声、且额度表至少低四分之一」的结果才算作真正的节省。
上下文缓存(prompt caching) 是理解额度消耗的关键机制。当 Claude Code 发送请求时,系统会缓存对话中不变的部分(如系统提示、历史消息),后续请求只需读取缓存而非重新处理全部 token。读取缓存的成本远低于写入缓存——通常写入价格是读取的 10 倍左右。这就是为什么「重复读取对话」虽然 token 量巨大,但费用占比却不高;而每次新建会话或压缩对话时,缓存需要重建,写入成本反而成为负担。
effort 参数 是 Claude Code 中控制模型推理投入程度的设置。降低 effort 会减少模型在思考阶段生成的 token 数,从而降低输出费用和响应步骤。它不同于切换模型,是在同一模型内调整计算资源的折中方案,适合不想改变模型但希望节省额度的场景。
真正省额度的两件事:换模型与降 effort
换模型:Sonnet 和 Haiku 的差距
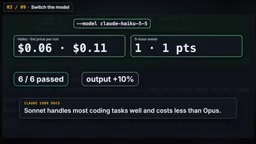
Sonnet 把标价费用压到了原来的四分之一以下,两次运行分别是53和47美分,对比 Opus 的2.12和2.26美元。需要说明的是,不同模型写出的代码不同,作者只验证了任务能通过测试和浏览器检查,没有验证代码质量是否同等。
Haiku 更进一步:6和11美分,额度表每次约1%,六个任务全部通过,输出量甚至比 Opus 还多约一成,只是每 token 便宜得多。Claude Code 官方文档的建议是 Sonnet 处理大多数编程任务,Opus 留给困难的架构和多步推理。
这三个任务规模小、描述清晰,属于简单场景。任务越难,换模型的收益越需要谨慎评估。
Claude 模型家族 目前主要包括 Opus、Sonnet 和 Haiku 三个层级,定位从高到低:Opus 面向复杂架构与多步推理,Sonnet 平衡性能与成本,Haiku 则主打轻量快速。三者的 API 定价差异显著,Haiku 的每 token 价格通常仅为 Opus 的几十分之一。在 Claude Code 中,用户可以通过 /model 命令切换模型,套餐额度按实际消耗的 token 和模型单价折算,因此换用低价模型能大幅延长套餐使用时间。但需注意,模型能力差异可能影响代码质量,简单任务下差异不明显,复杂任务则需谨慎评估。
降 effort:留在 Opus 的折中方案
不想换模型的话,可以把 Opus 的 effort 调低。同样三个任务只用了8%和9%的额度,大约减半,六次全部通过。输出量几乎减半,标价费用两次都是1.11美元。Opus 的回答步骤也更少,大约20次响应而非40次左右。
模型和 effort 确实能直接推动额度表。但流传更广的那些 token 技巧,针对的不是模型,而是上下文管理——而这正是数字开始反转的地方。
四个上下文技巧:实测几乎没有可测量的节省
/clear:没有明显差异
思路是每个任务开新会话,让 Claude 不再发送旧对话,代码仍留在磁盘上。实测用了19%和16%,对照组的16%和17%,差距在噪声范围内,无法判定。原因是每个新会话都要重建缓存,而写缓存比读缓存贵得多。
作者也承认,官方文档说的是在切换到无关工作时使用 /clear,而这组任务彼此关联,属于文档没有承诺的场景。
缓存重建成本 是理解 /clear 效果的关键。每次执行 /clear 开启新会话后,Claude 需要重新建立上下文缓存,包括系统提示和初始对话。写入缓存的价格远高于读取缓存,因此即使旧对话不再被重复发送,新建缓存的开销也可能抵消甚至超过节省的读取费用。在短会话中,这种抵消效应尤为明显;只有当会话极长、重复读取成本累积到很高时,/clear 的节省才可能显现。
/compact:反而更贵
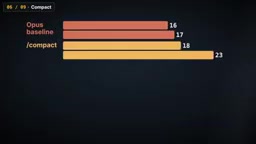
不重开会话,而是让 Claude 总结对话后继续。第一个任务后,它把大约三万六千 token 压缩到五千。结果更贵:额度表18%和23%,标价费用高出约四分之一。每次压缩本身就是一次请求,花7到10美分,而且压缩之后 Claude 完成任务需要更多步骤。文档也提示了这一点:compact 需要读取整段被总结的对话,建议在任务之间的自然断点使用。作者的会话很短,远没碰到上下文上限,所以这个技巧没有发挥空间。
Plan mode:略高,且未能验证完成度
先规划、再批准、再执行。作者用无键盘方式运行:一次调用只做规划,然后在同一会话里让它执行。额度表17%和20%,两次都略高于不用 plan mode。
这次测试还暴露了一个问题:它的浏览器检查无法驱动这些运行所构建的登录页。测试全部通过,手工验证应用也能用,但作者不对 plan mode 是否真正完成任务下结论。Plan mode 的价值在于避免走错方向后的昂贵返工,而这组任务描述清晰,几乎没有返工空间。
裁剪测试输出的 hook:一次都没触发
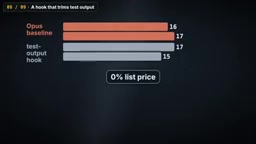
这是官方文档同一页上的 hook,用来改写测试命令,让 Claude 只看到失败、而不是满屏通过的测试。实测17%和15%,标价费用与不用时相同,差距在噪声范围内。
进一步排查发现了原因:对 NPM 测试,这个 hook 只改以 npm test 开头的命令,而 Claude 从没这样跑过——它总是在类型检查或切换目录之后、在更长的命令里执行测试,而且已经自己用 tail 和 grep 裁剪了输出。在63条 shell 命令里,hook 一条都没改到。所以这个技巧不是失效,而是在这个项目里根本没有机会生效。在你的项目里它可能有用,但要先确认你的测试命令是否真的以那种形式出现。
Claude Code 的 hook 机制 允许用户在特定事件(如执行 shell 命令前后)插入自定义脚本,用于修改命令、过滤输出或执行额外操作。裁剪测试输出的 hook 通常通过匹配命令前缀(如 npm test)来重写命令,使 Claude 只看到失败用例。但如果实际执行的命令包含管道、cd 切换或类型检查前缀,hook 的匹配模式就无法命中,导致其完全不生效。因此,使用此类 hook 前需确认自己的测试命令是否严格符合匹配规则,或调整 hook 的正则表达式以覆盖实际调用形式。
结论与适用边界
在这组实测里,能拉伸20美元套餐的只有两件事:换模型(Sonnet 或 Haiku)或降低 effort,同样的三个任务费用降了一半以上,而且每个任务都通过了检查。四个上下文技巧——/clear、/compact、plan mode、裁剪 hook——没有可测量的节省,其中 /compact 反而更贵。
作者反复强调边界:三个任务是很短的工作,短会话里账单大头是 Claude 自己的输出,所以模型和 effort 影响最大。长会话会翻转这个结论。在早前的一次测试里,Claude Code 处理一个12个任务的 app,到第7个任务时套餐把它拦下了;到第6个任务时,约七成费用已经是重复读取对话。那种场景下 /clear 可能才有意义,而这一点尚未测量。
如果你正卡在额度上,优先考虑换模型或降 effort;上下文技巧要按自己的会话长度和命令形式判断,不要照搬。
相关推荐
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
AI智能体记忆全解析:四层结构与“做梦”机制
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。
Anthropic智能体记忆架构:少即是多的记忆哲学
Anthropic通过Pokemon Red实验揭示智能体记忆的反直觉结论:保存413个文件的Claude反而不如维护简短仪表盘的Claude。本文解析四层记忆架构、Dreams离线修正机制与CLAUDE.md最佳实践。