按任务定价:AI竞争力的关键指标解读
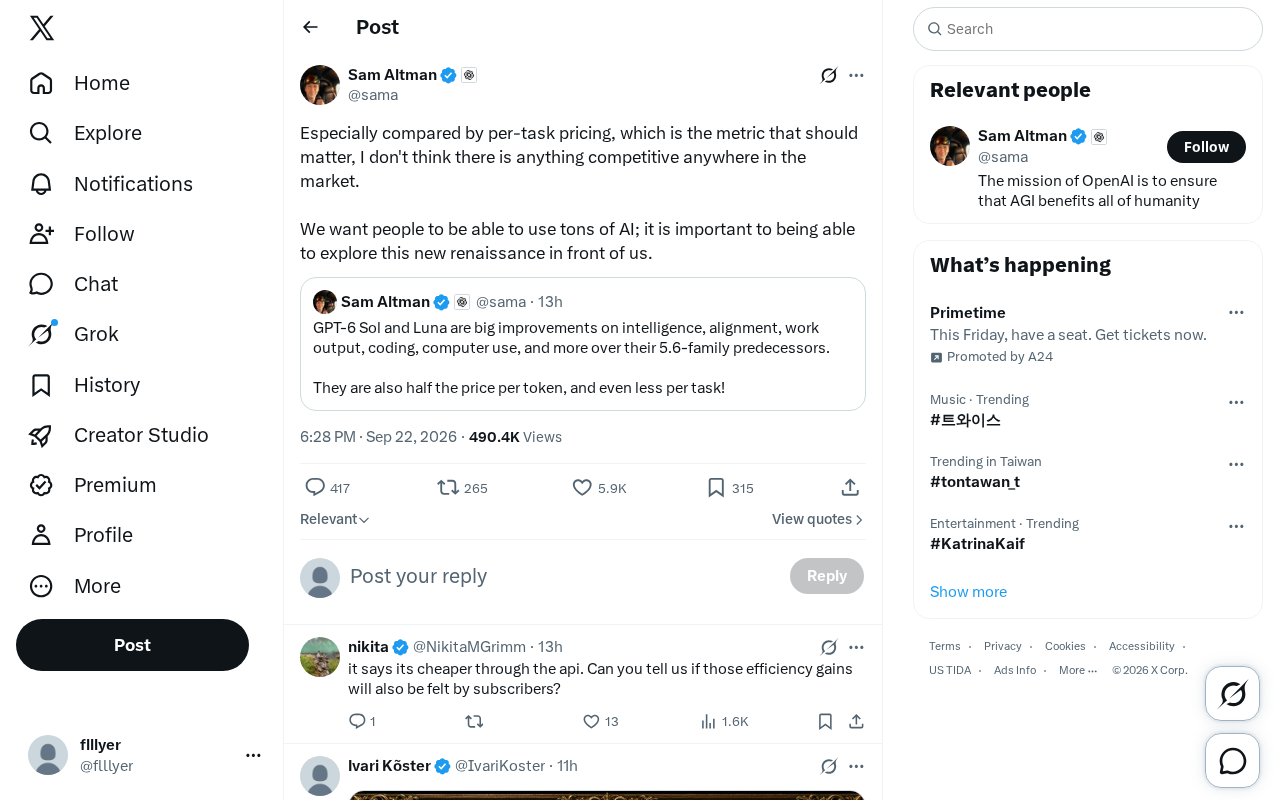
一条推文主张AI服务应以「按任务定价」取代token或订阅计费,将成本与实际产出价值直接挂钩。
一条科技领域推文引发关于AI定价模式的讨论,核心观点是:衡量AI产品竞争力的关键指标应是「按任务定价」,而非按token用量或月订阅收费。文章分析指出,用户真正关心的是「完成一件具体的事要花多少钱」,按任务定价将成本与实际产出价值直接挂钩,让企业做采购决策时更为直观。推文同时传递出一种产品哲学:降低使用门槛、鼓励高频使用,是释放AI潜力、推动这场「新文艺复兴」的关键杠杆。文章最后指出,主动倡导以任务为定价单位,本身也是一种重新定义行业竞争规则的策略表态,折射出AI商业化进程中「技术用量」与「用户价值」之间的深层张力。
一条推文引发的定价思考
近日一条来自科技领域的推文引发了关于AI服务定价方式的讨论。发言者提出了一个颇具启发性的观点:衡量AI产品竞争力的关键指标,应当是「按任务定价」(per-task pricing),而非其他常见的计费方式。
原文表述直接而自信:「尤其是从按任务定价来比较——这才是真正应该关注的指标——我认为市场上目前没有任何产品能与之竞争。」这番话背后,透露出对当前AI服务商业模式的重新审视。
为什么「按任务定价」值得关注
当前AI服务的计费方式五花八门:有按月订阅的固定费用,有按token(词元)用量计费的,也有按API调用次数收费的。这些方式各有局限——订阅制难以反映实际使用强度,token计费则让用户难以预估单次任务的真实成本。
「按任务定价」提供了另一种视角:用户关心的往往不是消耗了多少token,而是「完成一件具体的事情要花多少钱」。无论是生成一份报告、修复一段代码,还是完成一次数据分析,按任务定价把成本与实际产出的价值直接挂钩,让性价比的比较变得更加直观。
从商业逻辑看,这也是一个更贴近用户心智的定价维度。当企业评估是否引入AI工具时,「每完成一个任务花多少钱」远比抽象的技术用量指标更容易做决策。
从行业实践来看,按任务定价并非全新概念,但在AI领域落地面临独特挑战。传统软件服务中,任务边界相对清晰(如一次翻译、一次图片处理),定价逻辑容易标准化。然而AI任务的复杂度差异极大——修复一行代码与重构整个模块都可能被视为「一个任务」,如何合理切分任务粒度、避免用户拆单套利,是定价设计中的核心难题。此外,对于平台而言,按任务定价要求后台能准确追踪每个任务消耗的实际算力,并建立合理的成本模型,这在技术实现上比单纯统计token更为复杂。目前已有部分AI编码工具(如某些Agent产品)开始尝试按「成功完成的PR数」或「解决的Issue数」计费,这类实践为行业提供了早期参照,但大规模普及仍在探索中。
「让人们大量使用AI」的产品哲学
推文中另一句话同样值得玩味:「我们希望人们能够大量使用AI;这对于探索我们眼前这场新的文艺复兴至关重要。」
这里传递出一种明确的产品理念——降低使用门槛、鼓励高频使用。将当下的AI浪潮比作「文艺复兴」(renaissance),暗示着发言者相信AI正在开启一个创造力和生产力大爆发的时代,而低廉且透明的定价是推动普及的关键杠杆。
这种思路与部分AI公司「用规模化降低单位成本、再用低价刺激更大规模使用」的飞轮策略一致。当单次任务成本足够低,用户会更愿意尝试、探索,从而释放AI的应用潜力。
定价策略背后的行业竞争
值得思考的是,将定价指标从「用量」切换到「任务」,本身就是一种竞争策略的表态。它试图把竞争焦点从技术参数拉回到用户实际获得的价值上。
如果一家公司确信自己在「每任务成本」上具备明显优势,主动倡导以此为衡量标准,既是自信的展现,也是重新定义竞争规则的尝试。这对整个行业或许是个提醒:AI服务的比拼,最终要回归到「用户花的每一分钱能换来多少实际产出」这一朴素命题上。
Token计费模式目前仍是大模型API层面的主流方案,其背后有深刻的技术与商业原因。Token是大语言模型处理文本的最小单位(大致对应半个到一个英文单词,或半个中文字),模型的推理成本与输入输出的token总量高度正相关,因此以token为单位计费能最直接地反映供给侧的边际成本。对于OpenAI、Anthropic、Google等模型提供商而言,token定价便于在不同用量规模下维持可预期的毛利率。然而,对于在模型之上构建应用的开发者和企业用户来说,token用量与业务产出之间的映射并不直观,这正是「按任务定价」叙事能够打动用户的根本原因——它将供给侧的技术成本结构,翻译成了需求侧更易理解的价值语言。
小结
受限于原始素材仅为一条简短推文,本文更多是对其观点的解读与延展。但这条推文点出的核心问题——AI定价应以任务价值而非技术用量为标尺——确实触及了AI商业化进程中的一个关键议题。随着AI应用的深入,定价模式的创新,或许会成为决定产品普及速度的重要变量。
相关推荐
肠道健康与减重全解析:从纤维到GLP-1的科学工具
哈佛教授Dr. Chris Thompson在Huberman Lab解析肠道健康与减重科学:纤维与微生物组的关键作用、GLP-1药物的利弊、内镜手术与基因治疗前沿,以及代谢失调的早筛查思路。
Qwen Flash Next IQ4量化实测:低量化真的不如FP8吗?
Reddit 用户实测 Qwen Flash Next IQ4_XS 与 Qwen3 27B FP8 的跑分对比,涵盖 MMLU-Pro、GPQA、GSM8K 等基准。结果显示低量化 Flash Next 精度反超 FP8,但 FP8 并发速度快约 4 倍。
GitHub Copilot 的效率与产出鸿沟:AI 编程工具的真实生产力困境
GitHub Copilot 提升了编码效率,却未必带来整体产出提升。本文解析 AI 编程工具的"效率-吞吐量鸿沟",探讨为何局部加速难以转化为真实生产力,以及团队应如何科学衡量其价值。