Qwen Flash Next IQ4量化实测:低量化真的不如FP8吗?
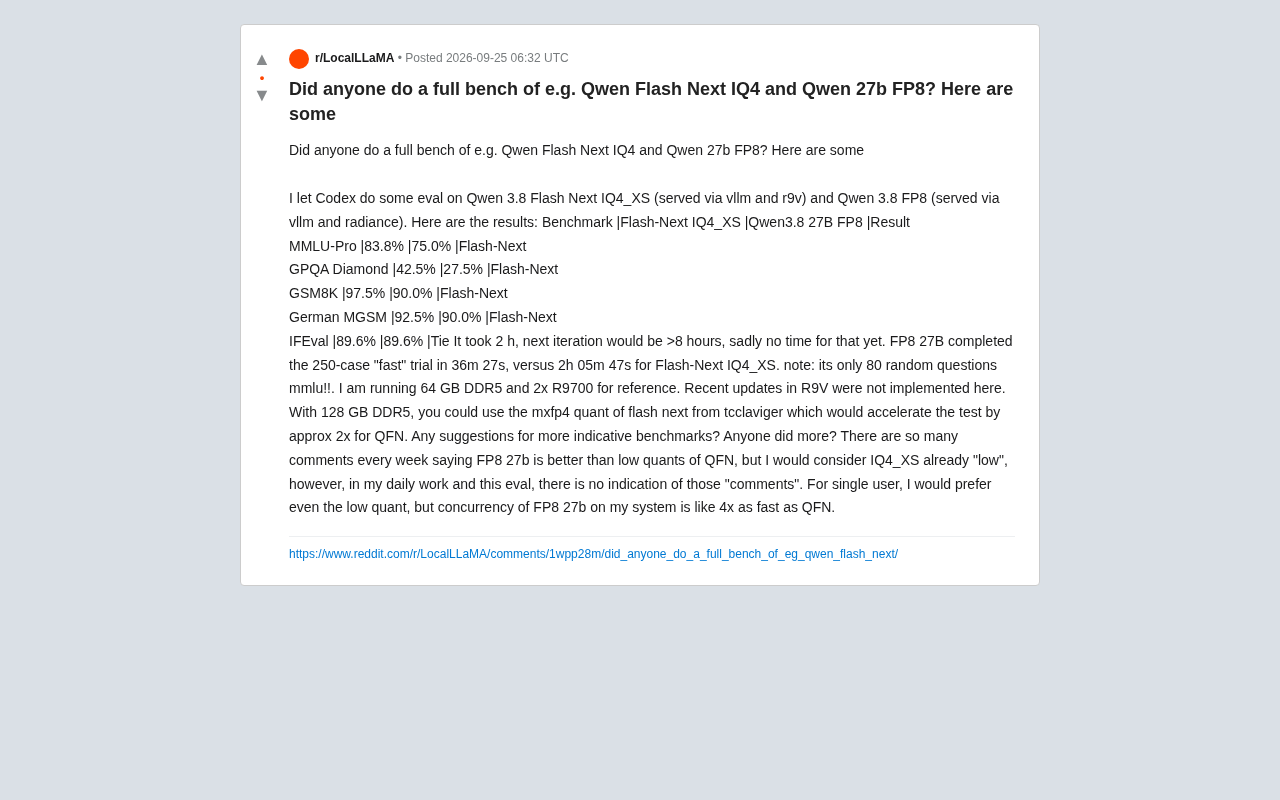
实测显示低比特量化的 Qwen Flash Next 在多项基准上精度反超更大的 Qwen3 27B FP8,但后者速度快约 3.5 倍。
一位用户通过 Codex 对 Qwen Flash Next IQ4_XS 与 Qwen3 27B FP8 进行了小规模横向评测,结果颠覆了社区"FP8 27B 优于低量化 QFN"的普遍印象。在 MMLU-Pro、GPQA Diamond、GSM8K 等多项基准上,IQ4_XS 版 Flash Next 均以较大优势领先,仅在指令遵循(IFEval)上两者持平。代价是速度:FP8 27B 完成相同测试仅需约 36 分钟,而 QFN 耗时逾 2 小时,差距约 3.5 倍。作者由此建议:单用户场景优先选精度更高的低量化 Flash Next,需要并发或批量处理则选 FP8 27B。评测样本量偏小(MMLU 仅 80 题),结论更多指示趋势,不宜过度解读。
本地大模型玩家群体中,关于量化方案的争论从未停止。一个流传甚广的说法是:Qwen3 27B 的 FP8 版本表现要优于 Qwen Flash Next 的低比特量化(如 IQ4)。一位 Reddit 用户借助 Codex 完成了一轮实测,得出的结论却与社区的普遍印象相反。
实测配置与方法
这次评测对比的是两个模型:Qwen Flash Next 的 IQ4_XS 量化版本(通过 vllm 与 r9v 部署)和 Qwen3 27B 的 FP8 版本(通过 vllm 与 radiance 部署)。
硬件方面,测试者使用 64GB DDR5 内存搭配 2 张 R9700 显卡。评测流程由 Codex 自动执行,覆盖了 MMLU-Pro、GPQA Diamond、GSM8K、德语 MGSM 以及 IFEval 五个基准。
需要强调的是,这并非严格意义上的"完整跑分"。测试者明确指出 MMLU 仅抽取了 80 道随机题目,整个"快速"试验也只是 250 个案例的子集。因此结果更多反映趋势而非精确排名。作者本人也在原帖中征询是否有人做过更全面的评测。
IQ4_XS 是 llama.cpp 生态中的一种非均匀量化格式,属于"importance matrix"系列(前缀 IQ 即来源于此)。与传统的 Q4_K_M 等均匀量化不同,IQ 系列会根据每个权重对模型输出的重要程度分配不同的精度,对关键权重保留更多比特,对次要权重压缩更激进,从而在相近文件体积下取得更好的精度保留。IQ4_XS 的平均量化位宽约为 4.25 bit,通常被认为是"接近 4-bit 的相对高质量量化",但仍属于低比特范畴。FP8 则是一种直接以 8 位浮点数存储权重和/或激活的格式,精度损失极小,更接近原始 FP16/BF16 模型,但显存与内存占用约为 4-bit 量化的两倍。两者的核心取舍在于:FP8 精度更高但体积更大、速度受内存带宽限制;IQ4_XS 体积更小、可在较低带宽硬件上跑得更快,但理论上存在更多精度损失。
跑分结果:Flash Next 全面领先
从五项基准的成绩看,Flash Next IQ4_XS 在绝大多数项目上都超过了 FP8 的 27B 模型:
| 基准 | Flash-Next IQ4_XS | Qwen3 27B FP8 | 胜出方 |
|---|---|---|---|
| MMLU-Pro | 83.8% | 75.0% | Flash-Next |
| GPQA Diamond | 42.5% | 27.5% | Flash-Next |
| GSM8K | 97.5% | 90.0% | Flash-Next |
| 德语 MGSM | 92.5% | 90.0% | Flash-Next |
| IFEval | 89.6% | 89.6% | 平手 |
差距最悬殊的是 GPQA Diamond,Flash-Next 以 42.5% 对 27.5% 拉开 15 个百分点;MMLU-Pro 也有近 9 个百分点的优势。只有指令遵循能力(IFEval)两者打成平手。
这个结果直接挑战了社区里"FP8 27B 优于 QFN 低量化"的常见说法。测试者坦言,IQ4_XS 已经算得上是"低量化"了,但无论是这次评测还是他自己的日常工作,都看不到那些评论所描述的劣势。
GPQA Diamond 是一个专为测试研究生级别科学推理能力设计的基准,题目由真实领域专家(物理、化学、生物等)撰写,并经过筛选以确保非专业人士难以通过搜索引擎作答。"Diamond"子集是其中难度最高的子集,普通人类表现约在 35% 左右,顶级闭源模型也仅在 60-75% 区间。因此该基准对模型的深度推理能力极为敏感,小样本下的方差也相对较大——本次仅 40 题的抽样意味着每道题的误差权重约为 2.5 个百分点,15 分的差距约等于 6 道题的差异,统计显著性需谨慎对待。MMLU-Pro 是原版 MMLU 的加强版,增加了选项数量(10 选 1 而非 4 选 1)并引入更多需要推理而非记忆的题目,被认为比原版 MMLU 更难以通过猜测或表面模式匹配刷高分。
速度与并发的权衡
精度不是唯一的考量。在推理速度上,FP8 的 27B 模型展现出明显优势。
完成 250 案例的"快速"测试,FP8 27B 只用了 36 分 27 秒,而 Flash-Next IQ4_XS 花了 2 小时 05 分 47 秒——相差约 3.5 倍。整轮评测耗时 2 小时,作者估计更完整的下一轮迭代需要超过 8 小时,因此暂时搁置。
测试者给出的实际建议颇有参考价值:对单用户场景,即便是低量化的 Flash Next 也更值得选择,因为精度更高;但如果需要并发处理,FP8 27B 在他的系统上速度大约是 QFN 的 4 倍,更适合多用户或批量任务。
结果的局限与优化空间
这次评测存在几个需要注意的限制。样本量偏小(MMLU 仅 80 题)意味着统计波动可能较大,单项差距不宜过度解读。测试环境也未纳入 R9V 的近期更新,这可能影响 Flash Next 的实际表现。
硬件配置同样是变量。作者提到,如果换成 128GB DDR5,可以使用来自 tcclaviger 的 mxfp4 量化版 Flash Next,这将使 QFN 的测试速度提升约 2 倍——说明当前 IQ4_XS 的速度劣势部分源于内存与量化格式的选择,而非模型本身的固有短板。
mxfp4 是一种基于 MX(Microscaling)规范的 4 位浮点量化格式,由 AMD、Intel、Microsoft 等厂商联合推动标准化。与传统整数 4-bit 量化(如 Q4、IQ4)相比,MX 格式在每个小块权重组内共享一个缩放因子,理论上能在相近比特数下取得更接近浮点精度的表现。AMD 的 RX 9700 系列 GPU 对 mxfp4 有硬件级加速支持,这意味着在搭载该显卡的系统上,mxfp4 量化模型可以充分发挥硬件指令集优势,而非仅依赖软件模拟——这正是作者提到升级至 128GB 内存后 QFN 速度可提升约 2 倍的底层原因。
给本地部署用户的启示
这份非正式评测提供了一个反直觉的数据点:低比特量化并不必然意味着能力大幅退化,模型架构与规模的差异有时比量化精度的影响更大。Flash Next 作为更新的架构,即便在 IQ4_XS 下依然能压制规模更大的 27B FP8。
对本地部署者而言,选择哪种方案取决于使用模式:追求单次质量选低量化的 Flash Next,追求吞吐量与并发选 FP8 27B。至于社区里流传的经验之谈,最好还是在自己的硬件和真实工作负载上验证,而不是照单全收。
作者也向社区发出了邀请:是否有更具代表性的基准推荐,或者谁做过更全面的对比测试。这类由用户自发进行的横向评测,正是本地大模型社区最宝贵的实践积累。
相关推荐
肠道健康与减重全解析:从纤维到GLP-1的科学工具
哈佛教授Dr. Chris Thompson在Huberman Lab解析肠道健康与减重科学:纤维与微生物组的关键作用、GLP-1药物的利弊、内镜手术与基因治疗前沿,以及代谢失调的早筛查思路。
GitHub Copilot 的效率与产出鸿沟:AI 编程工具的真实生产力困境
GitHub Copilot 提升了编码效率,却未必带来整体产出提升。本文解析 AI 编程工具的"效率-吞吐量鸿沟",探讨为何局部加速难以转化为真实生产力,以及团队应如何科学衡量其价值。
机器学习开源社区去哪找?盘点值得加入的技术Discord
盘点值得加入的开源机器学习 Discord 社区,包括 GPU MODE、Flash Linear Attention、Marin 等,解析各社区的技术侧重与选择方法,帮助 AI 从业者高效获取前沿知识。