机器学习开源社区去哪找?盘点值得加入的技术Discord
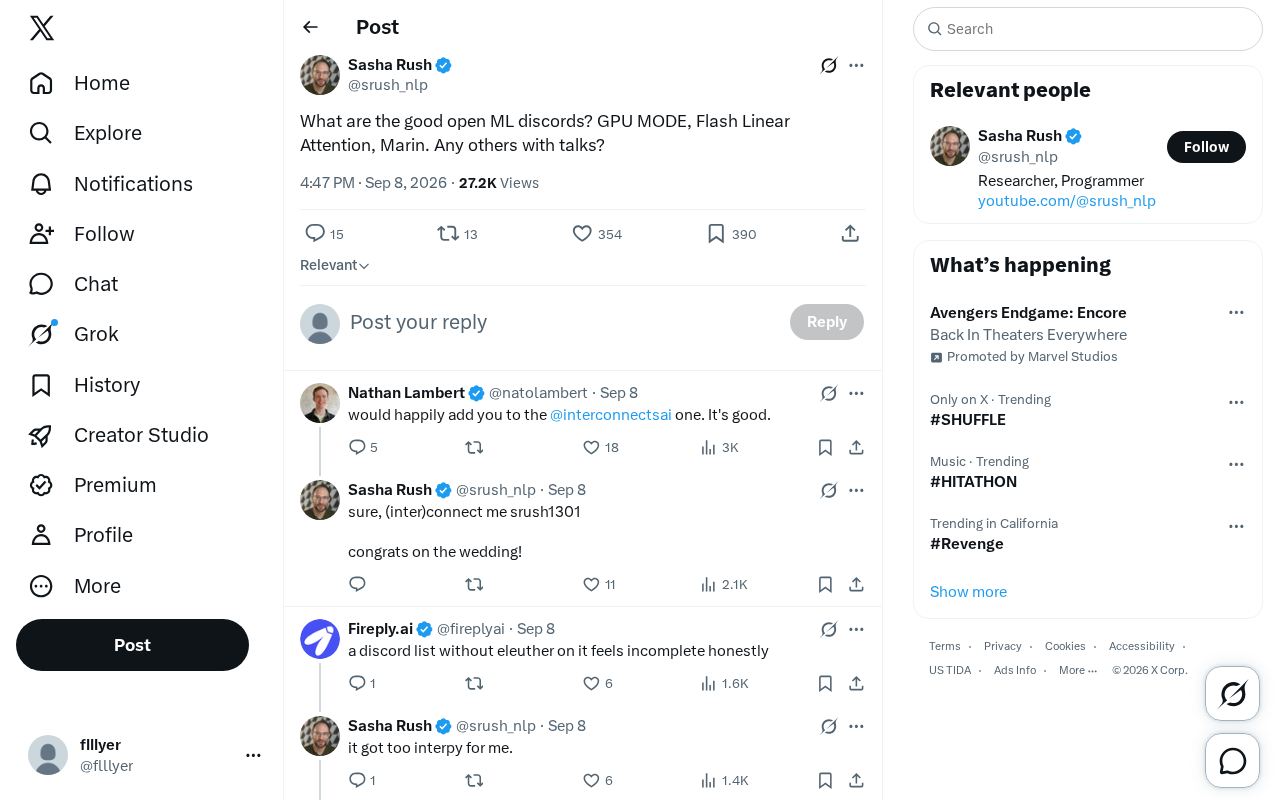
一篇解析开源ML Discord社区价值的文章,推荐GPU MODE等三个技术社群并探讨其学习意义。
一位开发者在社交平台询问值得加入的开源机器学习Discord社区,并点名GPU MODE(GPU编程与性能优化)、Flash Linear Attention(线性注意力前沿算法)、Marin(开源协作训练)三个方向各异的社群,尤其强调需有定期技术分享活动。文章借此切入一个更深层的现象:在AI技术快速迭代的背景下,论文和官方文档往往跟不上最前沿的工程实践,Discord社区已成为从业者获取实时知识、参与深度讨论的重要渠道。对希望寻找类似社区的读者,文章建议优先关注有持续技术分享、讨论深度足够的小而精社群,而非单纯以规模作为判断标准。
一个看似简单的问题,背后是社区学习的价值
在机器学习技术快速迭代的当下,官方文档和论文往往滞后于最前沿的实践。一位开发者在社交平台上抛出了一个很实际的问题:有哪些值得加入的开源机器学习 Discord 社区?他列举了自己已知的几个——GPU MODE、Flash Linear Attention、Marin,并特别强调希望找到那些「有技术分享(talks)」的社区。
这个问题看似琐碎,实则触及了当代 AI 从业者获取知识的一个核心痛点:真正的前沿讨论、工程细节和实战经验,很多时候并不在论文里,而是在这些活跃的技术社群中流动。
被点名的三个社区各有侧重
原帖提到的三个 Discord 社区,代表了机器学习领域三个不同的技术方向。
GPU MODE:底层性能优化的聚集地
GPU MODE 是围绕 GPU 编程与深度学习性能优化的社区,聚集了大量关注 CUDA、Triton、内核优化的工程师。对于想深入理解模型如何在硬件层面高效运行的人来说,这里是难得的交流场所。社区内常有关于算子优化、显存管理、推理加速的深度讨论,也不乏定期的技术分享活动。
CUDA 是 NVIDIA 推出的并行计算平台与编程模型,是目前深度学习硬件加速的事实标准;Triton 则是 OpenAI 开源的 Python 式 GPU 编程语言,目标是让研究者无需深入掌握 CUDA 也能编写高性能算子。GPU MODE 社区之所以受到关注,部分原因在于大模型时代「算子级优化」的价值被重新放大——在模型架构趋同的背景下,谁能把矩阵乘法、注意力计算、归一化层等核心算子跑得更快、更省显存,往往直接决定训练与推理的经济成本。这类底层优化知识的学习曲线陡峭,难以从论文中直接获取,社区内的代码走读和实操分享因此尤为珍贵。
Flash Linear Attention:注意力机制的前沿探索
Flash Linear Attention 顾名思义,聚焦于线性注意力机制及其高效实现。随着 Transformer 架构在长序列处理上的成本问题日益突出,线性注意力、状态空间模型等替代方案成为研究热点。这类社区往往连接着学术研究者与工程实现者,讨论内容偏向前沿算法。
标准 Transformer 的自注意力机制计算复杂度为 O(n²),意味着序列长度翻倍时,计算量增长四倍,这在处理长文档、长视频或长代码文件时代价极高。线性注意力通过核函数近似将复杂度降至 O(n),而 Flash Attention 则是另一条路径——它并不改变数学等价性,而是通过分块计算和 IO 感知的显存访问模式,大幅降低 GPU 显存带宽瓶颈,从而实现数倍加速。Flash Linear Attention 社区的名字将两者结合,暗示其关注的正是「线性复杂度」与「高效硬件实现」的交叉地带。与此同时,Mamba、RWKV 等状态空间模型(SSM)作为 Transformer 的竞争性替代方案也在此类社区中被频繁讨论,代表了序列建模架构演化的主流方向之一。
Marin:更偏向实践的开源协作
Marin 相对而言是一个更侧重开源模型训练与协作的社区。这类社区的价值在于让分散的个人开发者能够协同参与到大规模模型的构建中,共享算力、数据与经验。
为什么开发者越来越依赖 Discord 社区
原帖强调「with talks」(有技术分享)这一诉求,反映出一个趋势:Discord 已经从单纯的聊天工具,演变为机器学习知识传播的重要渠道。
相比传统的论坛或邮件列表,Discord 的实时性和低门槛让技术交流更加高效。许多社区会定期组织论文解读、代码走读、专家答疑等活动,这些内容的即时性和互动性是静态文档无法替代的。对于身处 AI 领域快速变化中的从业者,能够第一时间接触到最新的工程实践和研究动态,本身就是一种竞争优势。
值得关注的是,这类优质社区往往是自发形成的,围绕某个具体技术方向或开源项目聚集起一群高质量的贡献者。它们的存在填补了官方渠道与个人学习之间的空白。
如何找到适合自己的技术社区
如果你也在寻找类似的开源机器学习社区,可以从几个角度入手:一是关注你正在使用的开源项目,很多项目都有自己的官方 Discord;二是留意研究者和工程师在社交平台上的推荐,这类口碑往往比广告更可靠;三是优先选择那些有定期技术分享的社区,因为「有 talks」意味着社区有持续的知识产出和活跃的核心成员。
需要提醒的是,社区质量参差不齐,规模大不等于质量高。真正有价值的是那些讨论深度足够、成员愿意分享干货的小而精的社群。
小结
这条简短的求助帖,实际上折射出机器学习学习方式的变迁——从孤立地啃论文、读文档,转向融入活跃的技术社群,在实时交流中获取前沿知识。GPU MODE、Flash Linear Attention、Marin 只是其中的代表,围绕硬件优化、算法前沿、开源协作等不同方向,还有更多值得探索的社区等待被发现。对于每一位 AI 从业者而言,找到并深度参与一个高质量的技术社区,可能比读完十篇论文更有收获。
相关推荐
肠道健康与减重全解析:从纤维到GLP-1的科学工具
哈佛教授Dr. Chris Thompson在Huberman Lab解析肠道健康与减重科学:纤维与微生物组的关键作用、GLP-1药物的利弊、内镜手术与基因治疗前沿,以及代谢失调的早筛查思路。
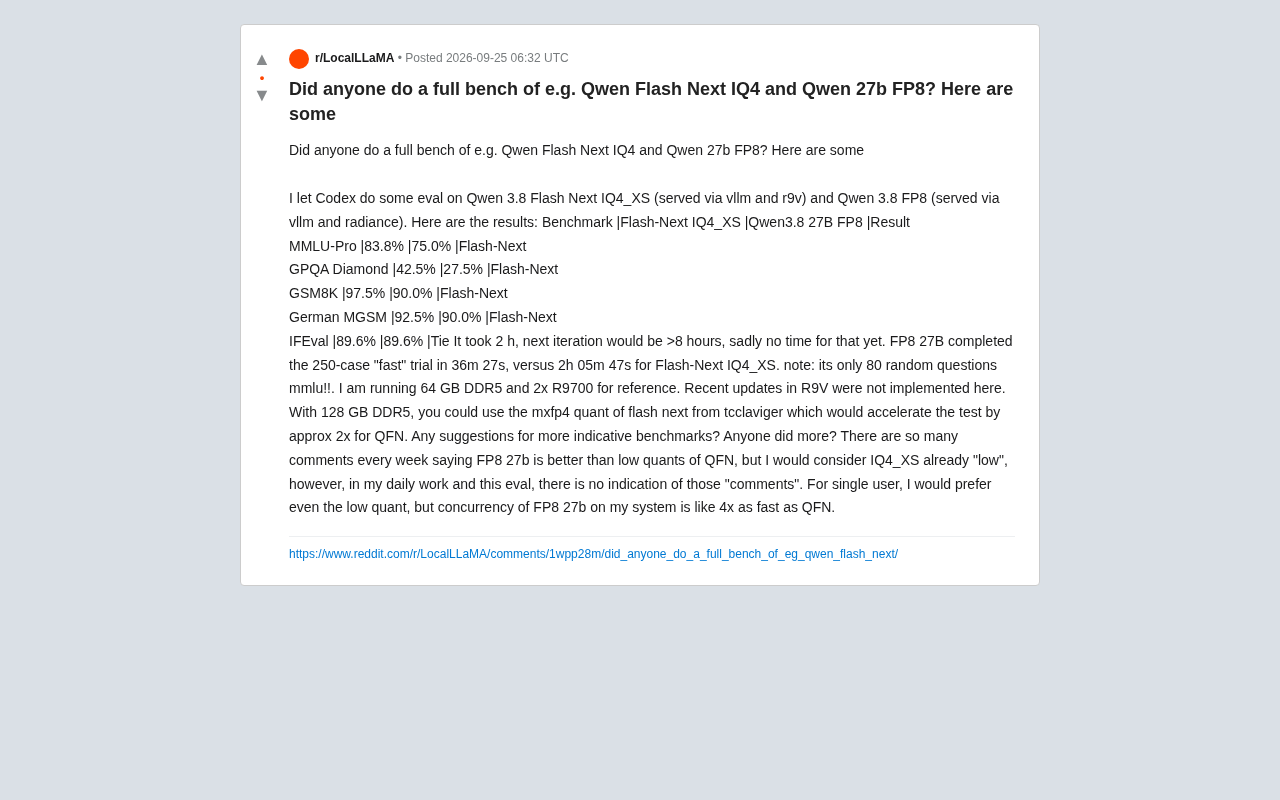
Qwen Flash Next IQ4量化实测:低量化真的不如FP8吗?
Reddit 用户实测 Qwen Flash Next IQ4_XS 与 Qwen3 27B FP8 的跑分对比,涵盖 MMLU-Pro、GPQA、GSM8K 等基准。结果显示低量化 Flash Next 精度反超 FP8,但 FP8 并发速度快约 4 倍。
GitHub Copilot 的效率与产出鸿沟:AI 编程工具的真实生产力困境
GitHub Copilot 提升了编码效率,却未必带来整体产出提升。本文解析 AI 编程工具的"效率-吞吐量鸿沟",探讨为何局部加速难以转化为真实生产力,以及团队应如何科学衡量其价值。