Appwrite 2.0:面向AI智能体与开发者的开源云平台
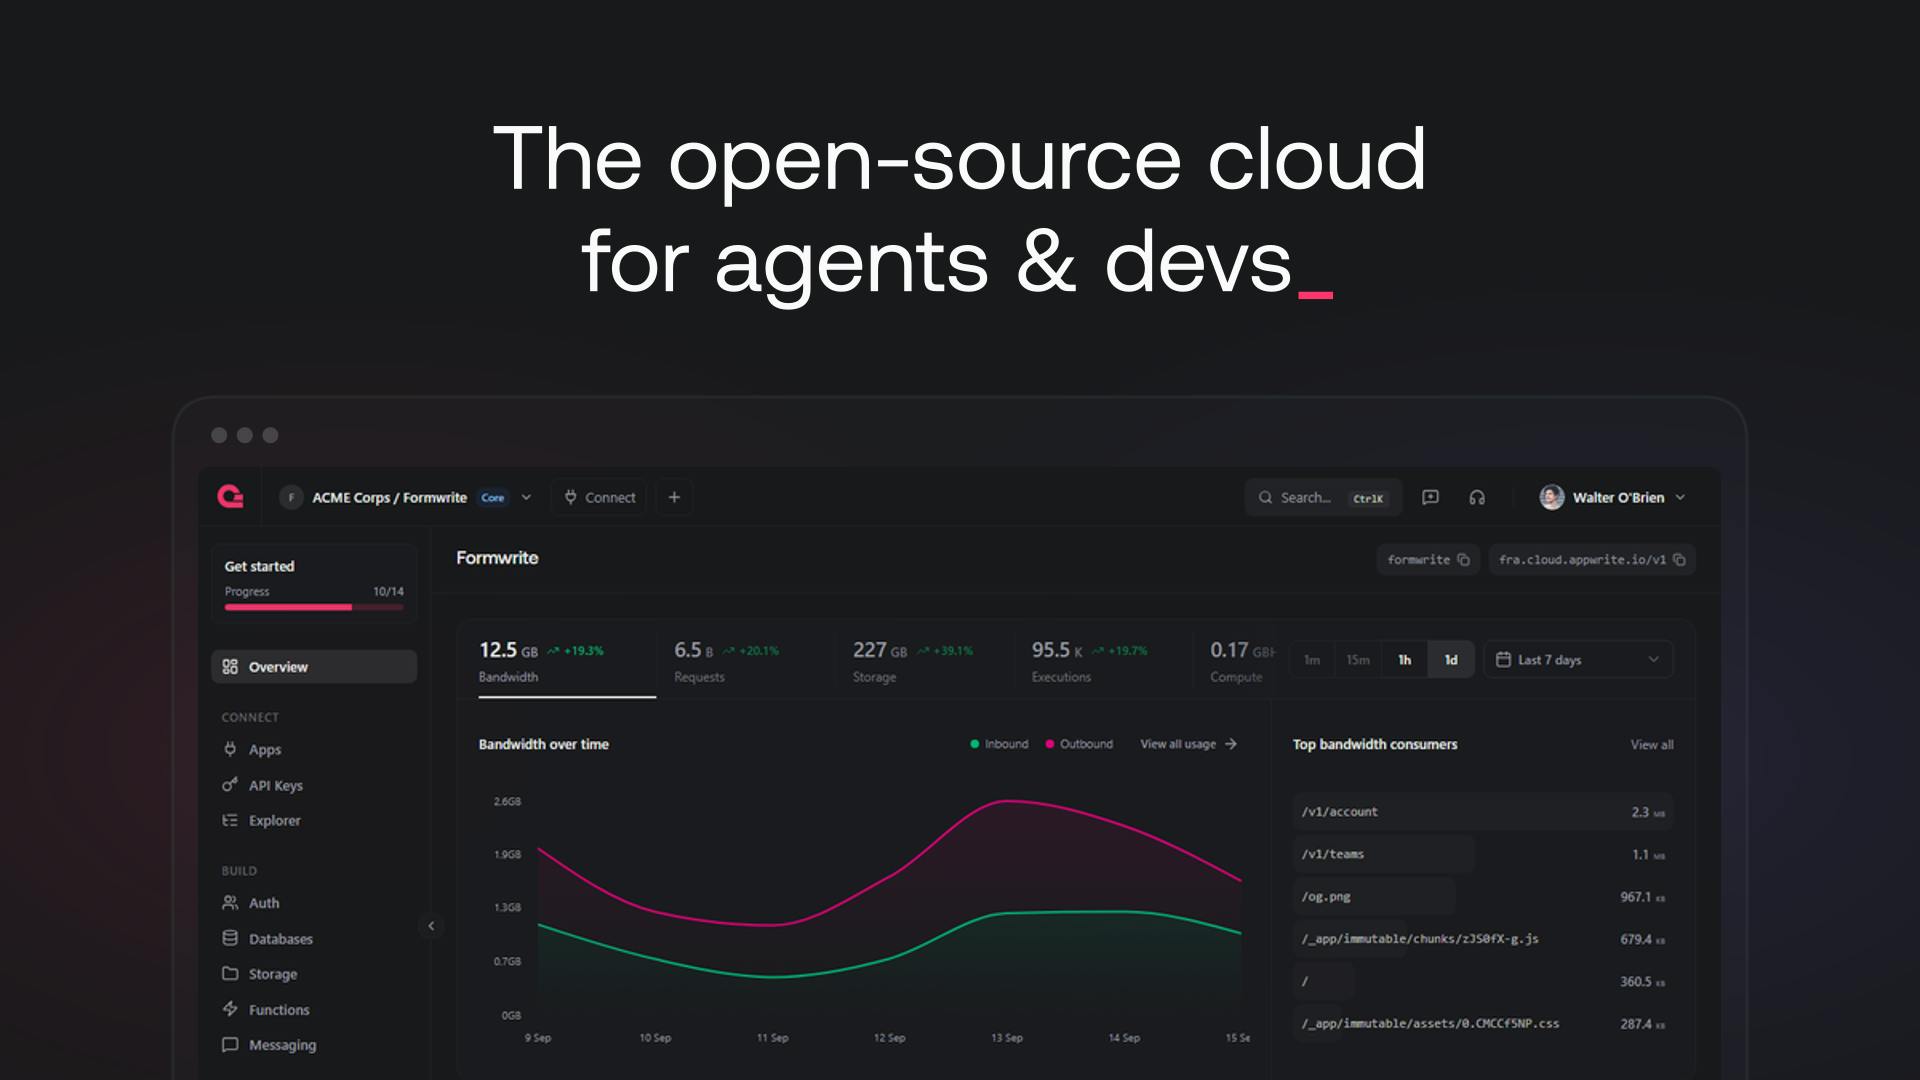
Appwrite 2.0 重写底层引擎,集成向量数据与标准化身份能力,转型为面向AI智能体的开源云平台。
Appwrite 2.0 是这一开源后端即服务平台的第二代重大升级,核心变化是从底层引擎到控制台的彻底重构,而非界面翻新。在数据层,2.0 同时支持关系型、无模式与向量三种数据形态,其中向量数据的原生支持直接对接 RAG、语义搜索和智能体记忆等 AI 应用需求,降低了架构复杂度。数据库引擎层面引入了原生 PostgreSQL 和 MySQL 支持,提升了生产环境的可用性与数据可控性。此外,S3 可寻址存储、OAuth 2.1/OIDC 合规的身份提供方以及统一网络层的加入,使平台具备了数据、存储、身份、网络四大后端支柱。Appwrite 由此将自身定位从"开发者后端"扩展为"面向 AI 智能体与开发者的开源云",为希望构建 AI 原生应用又不愿被闭源云厂商锁定的团队提供了一个值得评估的选项。
开源后端即服务(BaaS)平台 Appwrite 迎来了第二代重大更新。Appwrite 2.0 并非简单的功能叠加,而是从底层引擎到控制台的一次彻底重构,并将平台定位从传统的"开发者后端"扩展到"面向 AI 智能体(agents)与开发者的开源云"。这款产品在 Product Hunt 上获得 125 票、位列当日排名第 2,属于 Open Source、Developer Tools 和 Artificial Intelligence 交叉领域的热门项目。
从底层重构说起
与许多产品的"大版本"仅停留在界面翻新不同,Appwrite 2.0 的更新触及了平台最核心的部分。官方描述明确指出,2.0 "替换了底层引擎,在其上重建了控制台(Console)"。这意味着开发者所熟悉的操作界面之下,是一套全新的运行时基础。
这种"换心"式的升级通常伴随着更高的性能上限和更清晰的架构边界。对于一个开源项目而言,重写引擎是一项风险不小的决策——它可能影响向后兼容性,但也为后续的能力扩展打开了空间。Appwrite 选择在第二代做这件事,显然是为了给"智能体时代"的需求预留架构弹性。
数据层:关系型、无模式与向量数据的统一
2.0 版本最值得关注的变化之一,是它扩展了"一个项目能承载的数据类型"。根据官方说明,Appwrite 2.0 支持关系型(relational)、无模式(schemaless)以及向量(vector)数据三种形态。
为什么向量数据是关键
向量数据的原生支持,是这次更新与"AI 智能体"定位直接呼应的信号。向量存储是构建 RAG(检索增强生成)、语义搜索和智能体记忆的基础设施。过去,开发者往往需要额外引入专门的向量数据库(如 Pinecone、Weaviate 等)来完成这类工作。Appwrite 将向量能力内置到平台中,理论上可以降低 AI 应用的架构复杂度。
同时提供关系型与无模式两种范式,意味着开发者既可以处理结构严谨的业务数据,也能灵活存储非结构化内容,无需在多个后端之间切换。
RAG(Retrieval-Augmented Generation,检索增强生成)是目前主流的 AI 应用架构模式:系统在调用大语言模型生成回答之前,先从向量数据库中检索与问题语义最相近的文档片段,将其作为上下文注入提示词,从而让模型能够引用私有知识库或最新数据,而不仅依赖训练时的静态知识。实现这一流程的核心步骤是将文本、图片等内容通过嵌入模型(embedding model)转换为高维浮点数向量,再通过近似最近邻(ANN)算法进行相似度检索。向量数据库的专门价值就在于高效地完成这一检索过程。将向量存储能力内置到 BaaS 平台,意味着开发者无需单独部署和维护一套向量数据库服务,可以在同一平台内完成从用户认证、业务数据到 AI 记忆的全部后端需求。
数据库引擎:原生 PostgreSQL 与 MySQL
Appwrite 2.0 引入了原生的 PostgreSQL 和 MySQL 引擎。这是一个面向生产环境的重要信号——支持业界最主流的两大关系型数据库,意味着企业可以基于自己熟悉且成熟的技术栈来运行 Appwrite,而不必被绑定在某个专有存储方案上。
对于开源自托管用户来说,能够对接标准数据库引擎,也让数据迁移、备份和运维有了更多可控空间。这与 Appwrite 一贯强调的"开放"理念保持一致。
存储、身份与网络层
除了数据与引擎,2.0 还在多个基础能力上做了扩展:
- 存储:提供 S3 可寻址(S3-addressable)的存储能力,兼容业界事实标准的对象存储协议,便于与现有云存储生态整合。
- 身份认证:内置符合 OAuth 2.1 与 OIDC 规范的身份提供方(identity provider)。这不仅是登录功能,而是一个标准化的 IdP,可用于统一管理用户与智能体的身份和授权。
- 网络层:官方特别提到"位于所有这些能力之前的网络层",暗示 2.0 在流量入口、路由与访问控制层面做了统一处理。
这套组合拳勾勒出一个完整的后端全景:数据、存储、身份、网络四大支柱同时到位。
OAuth 2.1 是对 OAuth 2.0 授权框架的安全加固版本,合并并废弃了原有规范中多个存在安全隐患的授权模式(如隐式流程),强制要求使用 PKCE(Proof Key for Code Exchange)防止授权码拦截攻击。OIDC(OpenID Connect)则是构建在 OAuth 2.0/2.1 之上的身份认证层,通过 ID Token(通常为 JWT 格式)标准化了"用户是谁"这一问题的回答。当 Appwrite 将自己定位为 identity provider(IdP)时,意味着它不仅能管理人类用户的登录,还可以为 AI 智能体签发机器身份凭证(service account token),使智能体在访问 API、数据库或外部服务时具备可审计、可撤销的标准化权限。这对于多智能体协作场景中的权限隔离与安全治理尤为重要。
定位"智能体云"意味着什么
Appwrite 将自己重新定义为"面向智能体与开发者的开源云",这个 tagline 值得玩味。在 AI 智能体逐渐从演示走向生产的当下,智能体需要的不只是模型 API,还需要持久化记忆(向量数据)、身份与权限(OAuth 2.1/OIDC)、可靠的数据与存储后端。Appwrite 2.0 恰好把这些能力打包进一个开源、可自托管的平台里。
对于希望构建 AI 原生应用、又不愿被闭源云厂商锁定的团队来说,这是一个值得评估的选项。当然,作为刚发布的第二代平台,其在生产环境中的稳定性、性能表现以及向后兼容的迁移体验,仍需在实际使用中检验。
小结
Appwrite 2.0 通过底层引擎重写、控制台重建,以及在数据类型、数据库引擎、存储、身份和网络层的全面扩展,完成了一次从"开发者后端"到"智能体云"的定位跃迁。向量数据的原生支持和标准化身份能力,是它拥抱 AI 时代最明确的两个抓手。对开源生态与 AI 开发者而言,这是一次方向清晰的重大迭代。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。