把NES搬进CUDA:Mario强化学习训练提速20倍实战
当强化学习的瓶颈不是学习,而是模拟器
在强化学习(RL)的实践中,我们通常关注策略网络的设计、超参数的调优,或者算法本身的收敛性。但对于游戏类环境,一个常被忽视却致命的瓶颈往往是:环境模拟器本身的吞吐量。
强化学习的训练过程本质上是一个紧密耦合的系统工程。在典型的on-policy算法(如PPO)中,训练效率取决于三个关键环节的平衡:环境模拟(生成状态转移)、数据传输(在CPU/GPU间移动张量)和策略学习(神经网络的前向/反向传播)。传统架构中,这三个环节往往运行在不同的硬件上——CPU负责模拟、GPU负责训练,数据通过PCIe总线往返。根据Amdahl定律,系统的整体性能由最慢的组件决定。当单个环境的模拟速度仅为百Hz量级时,即使并行数千个环境,累计吞吐仍可能不及神经网络推理速度的十分之一。这种不平衡导致昂贵的GPU资源大部分时间处于空闲状态,等待CPU产生下一批数据。识别并消除这类瓶颈,需要对整个训练管线进行端到端的性能剖析,而非仅关注算法层面的改进。
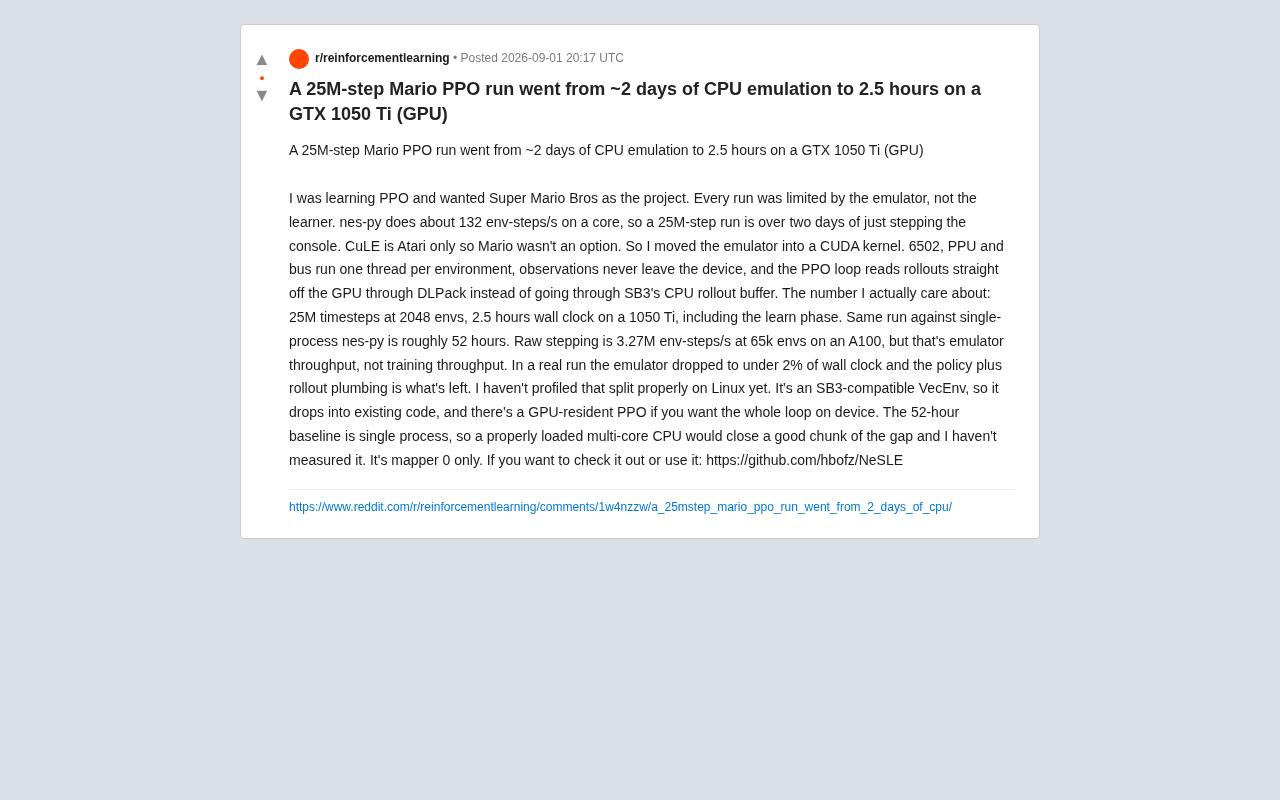
一位开发者近期在 Reddit 上分享了他的实践经历。他在学习 PPO(Proximal Policy Optimization)算法时,选择了经典的《超级马里奥兄弟》作为项目载体。PPO 是 OpenAI 在 2017 年提出的一种策略梯度算法,因其实现简单、调参容易且性能稳健而成为强化学习领域最广泛使用的算法之一。PPO 的核心思想是在策略更新时引入裁剪机制(clipping),限制新旧策略之间的差距,从而在保证训练稳定性的同时实现高效的策略改进。一个典型的 PPO 训练循环包含两个交替阶段:首先是「rollout 阶段」,智能体在环境中按当前策略执行动作、收集状态-动作-奖励轨迹数据;然后是「学习阶段」,利用收集到的轨迹数据更新策略网络和价值网络。这两个阶段的耗时比例直接决定了整体训练效率——如果 rollout 阶段因模拟器速度而成为瓶颈,再优秀的学习算法也无法发挥作用。
然而他很快发现,每次训练的速度限制并不来自学习器(learner),而是来自负责运行 NES 游戏的模拟器。
具体数据触目惊心:常用的 Python NES 模拟器 nes-py 在单核 CPU 上仅能达到约 132 env-steps/s 的速度。这意味着一次 2500 万步(25M-step)的训练,光是「按手柄推进游戏画面」这一件事,就需要花费超过两天时间——学习环节还没算进去。
为什么现有GPU模拟方案不够用
面对模拟器瓶颈,业界其实已有成熟思路——把模拟器搬到 GPU 上并行运行。NVIDIA 的 CuLE(CUDA Learning Environment)就是这样一个项目,它能在 GPU 上并行运行成千上万个游戏环境,把观测数据留在显存里,避免昂贵的 CPU-GPU 数据往返。
CuLE 是 NVIDIA 在 2019 年发布的研究项目,其核心贡献是将 Atari 2600 模拟器(基于 Stella)完整移植到 CUDA 上运行。Atari 2600 的硬件架构比 NES 更为简单——仅有 128 字节 RAM 和相对简单的图形硬件(TIA 芯片),这使得 GPU 移植的工程难度相对可控。CuLE 的关键设计理念是:在 GPU 上同时运行数千个独立的游戏实例,每个实例占用一个或少量 GPU 线程,所有环境状态和观测数据都保留在 GPU 显存中。这种设计消除了传统方案中 CPU 与 GPU 之间的数据传输瓶颈——PCIe 带宽通常为 12-32 GB/s,而 GPU 显存带宽可达数百 GB/s 甚至 TB/s 级别。CuLE 在论文中展示了在单张 V100 上实现每秒数十万帧吞吐的能力,证明了 GPU 原生模拟器对 RL 训练效率的变革性影响。
问题在于,CuLE 只支持 Atari 游戏,并不覆盖 NES 平台的《超级马里奥兄弟》。这就把开发者逼到了一个选择:要么放弃 Mario 换成 Atari 游戏,要么自己动手,把 NES 模拟器整个塞进 CUDA 内核。
他选择了后者。这也正是这个名为 NeSLE 项目的由来。
技术核心:让整台NES游戏机跑在GPU线程里
这个项目最硬核的地方,在于它把 NES 的核心组件——6502 CPU、PPU(图形处理单元)和总线(bus)——全部实现为 CUDA 内核,并采用「一个线程对应一个环境」的并行模式。
NES(Nintendo Entertainment System)是任天堂于 1983 年推出的 8 位家用游戏机,其核心架构由三个主要组件构成:一颗基于 MOS 6502 的定制 CPU(Ricoh 2A03),负责运行游戏逻辑和音频处理;一颗 PPU(Picture Processing Unit),负责渲染背景图块、精灵和生成视频信号;以及连接两者的总线系统,负责地址映射和数据传输。模拟器需要在指令级别精确还原这些组件的行为和时序关系——6502 CPU 的每条指令消耗特定数量的时钟周期,PPU 与 CPU 以 3:1 的时钟比同步运行,每一帧需要精确模拟数万个时钟周期。将这套逻辑从传统的串行 C/Python 实现移植为 CUDA 并行内核,意味着每个 GPU 线程都要独立维护一整套完整的 NES 硬件状态,包括 CPU 寄存器、内存映射和 PPU 渲染状态,这是一项非平凡的工程挑战。
将串行模拟器移植为GPU并行实现远非简单的代码翻译。GPU的SIMT(Single Instruction Multiple Threads)执行模型要求数千个线程以相同的指令序列运行,而游戏模拟器的逻辑充满分支和条件判断——不同游戏状态会执行不同的代码路径。这种控制流分歧(warp divergence)会导致性能急剧下降。NeSLE的设计采用「每线程一个完整环境」的粗粒度并行策略,使每个线程独立执行完整的CPU指令模拟和PPU渲染,避免了线程间的同步开销,但代价是每个线程需要维护约8KB的寄存器和内存状态。此外,NES模拟器依赖大量的内存读写操作(如访问卡带ROM、WRAM、调色板),这些访问模式在GPU上必须通过全局内存完成,延迟远高于CPU的L1/L2缓存。优化策略包括使用共享内存缓存频繁访问的数据、合并内存访问以提高带宽利用率,以及通过调整线程块大小来平衡占用率与寄存器压力。
观测数据永不离开显存
传统 RL 训练流程中,模拟器在 CPU 上产生观测,再拷贝到 GPU 供神经网络推理,训练完的动作又拷回 CPU 执行——这个来回搬运的开销在高并行度下会成为新的瓶颈。
NeSLE 的做法是让观测数据始终驻留在 GPU 上。更进一步,PPO 训练循环通过 DLPack 直接从 GPU 读取 rollout 数据,而不是走 Stable-Baselines3(SB3)默认的 CPU rollout buffer。
消除CPU-GPU数据传输的关键在于构建一条端到端的GPU驻留数据管线。在传统方案中,即使环境观测在GPU上生成,也会先拷贝到CPU的numpy数组,再由训练代码转换为PyTorch张量并传回GPU——这个往返过程在每个训练步都会发生数千次。NeSLE通过三个技术手段消除这一开销:首先,CUDA内核直接将观测帧写入预分配的GPU显存buffer;其次,通过DLPack协议将这块显存封装为PyTorch可直接使用的张量,避免任何内存复制;最后,改写PPO的rollout buffer,使其直接在GPU上存储和索引轨迹数据,而非SB3默认的CPU端numpy数组。这种设计要求仔细管理GPU内存的生命周期——buffer必须在多个训练迭代间复用,同时避免CUDA流同步导致的流水线停顿。实现零拷贝的收益是显著的:在高并行度下,数据传输原本占训练时间的30-50%,消除后这部分开销降至可忽略不计。
DLPack 是一个开放的内存张量结构标准,旨在让不同的深度学习框架(如 PyTorch、TensorFlow、JAX、CuPy 等)之间实现零拷贝(zero-copy)的张量数据共享。其核心思想是定义一个与框架无关的 C 级别数据结构(DLTensor),描述张量的数据指针、形状、步长、数据类型和设备信息,任何框架只要能解析这个结构,就可以直接访问底层数据而无需复制。在 NeSLE 的场景中,CUDA 内核产生的观测数据以 GPU 显存中的原始指针形式存在,通过 DLPack 封装后,PyTorch 可以直接将其作为张量使用,完全避免了数据在 CPU 和 GPU 之间的不必要往返。这意味着从模拟、采样到学习,整条数据链路都尽可能留在设备端。
无缝兼容Stable-Baselines3生态
值得称道的工程细节是,这套实现被封装成了一个 SB3 兼容的 VecEnv。Stable-Baselines3(SB3)是目前 Python 社区中最主流的强化学习算法库之一,它提供了 PPO、A2C、SAC、TD3 等经典算法的高质量 PyTorch 实现。SB3 的一个核心设计是 VecEnv(Vectorized Environment)抽象层——它将多个环境实例封装为一个统一接口,支持批量 step 和 reset 操作。SB3 内置了 SubprocVecEnv(通过多进程实现并行)和 DummyVecEnv(串行模拟)等实现。
NeSLE 将自己封装为一个自定义的 VecEnv,这意味着用户只需替换环境创建的一行代码,就能将底层从 CPU 多进程模拟切换为 GPU 并行模拟,而上层的 PPO 训练代码完全不需要改动。这种对既有生态的兼容性大大降低了 GPU 模拟器的采用门槛。此外,项目还提供了一个「GPU 常驻的 PPO」实现,让整个训练循环都在显存中完成。
性能数据:20倍加速的真实含义
作者给出的核心指标非常直接:在一块入门级的 GTX 1050 Ti 上,以 2048 个并行环境跑 2500 万步,包含学习阶段在内,墙钟时间仅 2.5 小时。
作为对比,同样的任务用单进程 nes-py 需要约 52 小时——加速比接近 20 倍,而且是在一张多年前的低端显卡上实现的。
区分「模拟吞吐」与「训练吞吐」
作者在这里保持了难得的严谨。他特别指出,在 A100 上纯粹跑模拟器(65536 个环境)能达到 327 万 env-steps/s 的惊人吞吐,但这只是模拟器吞吐量,并非训练吞吐量。
在真实训练中,模拟器占用的墙钟时间下降到了不足 2%,剩下的时间主要花在策略网络计算和 rollout 数据管理上。换句话说,一旦把模拟器搬上 GPU,瓶颈就从「跑游戏」转移到了「训练本身」——这恰恰是我们希望看到的健康状态。这也是系统优化中经典的 Amdahl 定律的生动体现:当系统中某个组件不再是瓶颈时,整体性能的天花板就由剩余最慢的组件决定。
当前局限性与注意事项
作者对项目的局限性也毫不回避,这种诚实值得在技术传播中如实呈现:
- 52 小时基线是单进程的。一个充分利用多核的 CPU 方案会缩小相当一部分差距,但作者尚未实测这个数字,因此 20 倍的加速比在多核对比下会有所收敛。
- 性能拆分尚未在 Linux 上完整 profiling。策略计算与 rollout 管道各占多少时间,还没有精确测量。
- 仅支持 Mapper 0。NES 卡带通过不同的「Mapper」芯片扩展寻址能力,目前 NeSLE 只支持最基础的 Mapper 0,这限制了它能运行的游戏范围。
NES的Mapper系统是其软件生态繁荣的基石,也是模拟器工程中最复杂的部分之一。不同的Mapper不仅改变内存映射方式,还可能引入额外的硬件功能:MMC3(Mapper 4)提供扫描线计数器用于分屏滚动效果,MMC5(Mapper 5)支持额外的声音通道和更大的精灵分辨率,VRC6(Mapper 24/26)集成了额外的音频合成芯片。在CUDA实现中,每种Mapper需要独立的内核逻辑来处理地址译码、bank切换和特殊寄存器写入。更棘手的是,某些Mapper的行为依赖精确的时序模拟——例如MMC3的IRQ计数器必须在PPU的特定扫描线触发,这要求GPU内核维护更细粒度的时钟同步。NeSLE当前仅支持Mapper 0的局限性意味着它只能运行约占全部NES游戏库5%的早期简单游戏。扩展Mapper支持是一个渐进的工程任务:每个新Mapper需要数百到上千行CUDA代码,并且必须通过与已知ROM的精确逐帧对比来验证正确性。
NES 的 Mapper(内存映射器)是理解其游戏卡带技术多样性的关键概念。NES 的 CPU 仅有 16 位地址空间(64KB),而 PPU 的地址空间也非常有限。随着游戏容量和复杂度的增长,开发者通过在卡带上集成额外的芯片来实现存储体切换(bank switching),突破地址空间限制。iNES 格式定义了超过 250 种不同的 Mapper 编号,但实际常用的约有二三十种。Mapper 0(即 NROM)是最基础的映射方式,不包含任何存储体切换逻辑,支持最多 32KB 程序 ROM 和 8KB 图形 ROM。经典的《超级马里奥兄弟》初代恰好使用 Mapper 0,所以 NeSLE 可以运行它;但《超级马里奥兄弟 3》使用的是 Mapper 4(MMC3),更复杂的游戏使用其他 Mapper 类型。每种 Mapper 都有独特的寄存器映射和切换逻辑,在 CUDA 中实现它们需要逐一编写相应的内核代码,这解释了为什么 Mapper 支持的扩展是一个渐进式的工程任务。
对强化学习工程实践的启示
这个个人项目虽小,却清晰地揭示了强化学习工程中的一条重要原则:在盯着算法优化之前,先搞清楚系统真正的瓶颈在哪里。
很多时候,制约实验迭代速度的并不是模型或算法,而是环境交互的吞吐能力。当模拟器成为瓶颈时,把它 GPU 化、消除数据往返、让整条链路留在设备端,能带来数量级的效率提升——即便是一张 GTX 1050 Ti 这样的老卡,也能把两天的实验压缩到一个下午。
这一思路并非 NeSLE 的独创。近年来,RL 社区中越来越多的项目走上了「环境 GPU 化」的路线:Google DeepMind 的 Brax 将物理模拟搬到了 JAX 上运行,NVIDIA 的 Isaac Gym 将机器人仿真环境原生部署在 GPU 上,Pgx 项目则在 JAX 中实现了多种棋盘游戏环境。这些项目共同指向一个趋势——将整个 RL 训练管线(环境模拟 + 策略学习)统一到同一个加速设备上,消除异构计算带来的数据搬运开销。NeSLE 在这条路线上为经典游戏模拟器提供了一个具体而精致的案例。
对于希望复现或研究的开发者,项目已在 GitHub 开源(hbofz/NeSLE),既可作为 SB3 的即插即用环境,也提供了完整的 GPU 常驻 PPO 实现。
核心要点
- 强化学习训练的瓶颈往往不在算法本身,而在环境模拟器的吞吐量
- 传统CPU模拟器(如nes-py)在单核上仅132 steps/s,25M步训练需超过52小时
- GPU并行模拟通过消除CPU-GPU数据往返,可实现数量级加速
- NeSLE将完整的NES模拟器(6502 CPU + PPU + 总线)实现为CUDA内核
- 采用「每线程一个环境」的并行模式,观测数据通过DLPack零拷贝传递
- 在GTX 1050 Ti上实现20倍加速(2.5小时 vs 52小时)
- 项目封装为SB3兼容的VecEnv,可无缝集成现有训练代码
- 当前仅支持Mapper 0,限制了可运行的游戏范围
- 体现了系统优化的关键原则:先定位真正的瓶颈,再针对性优化
相关推荐
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。
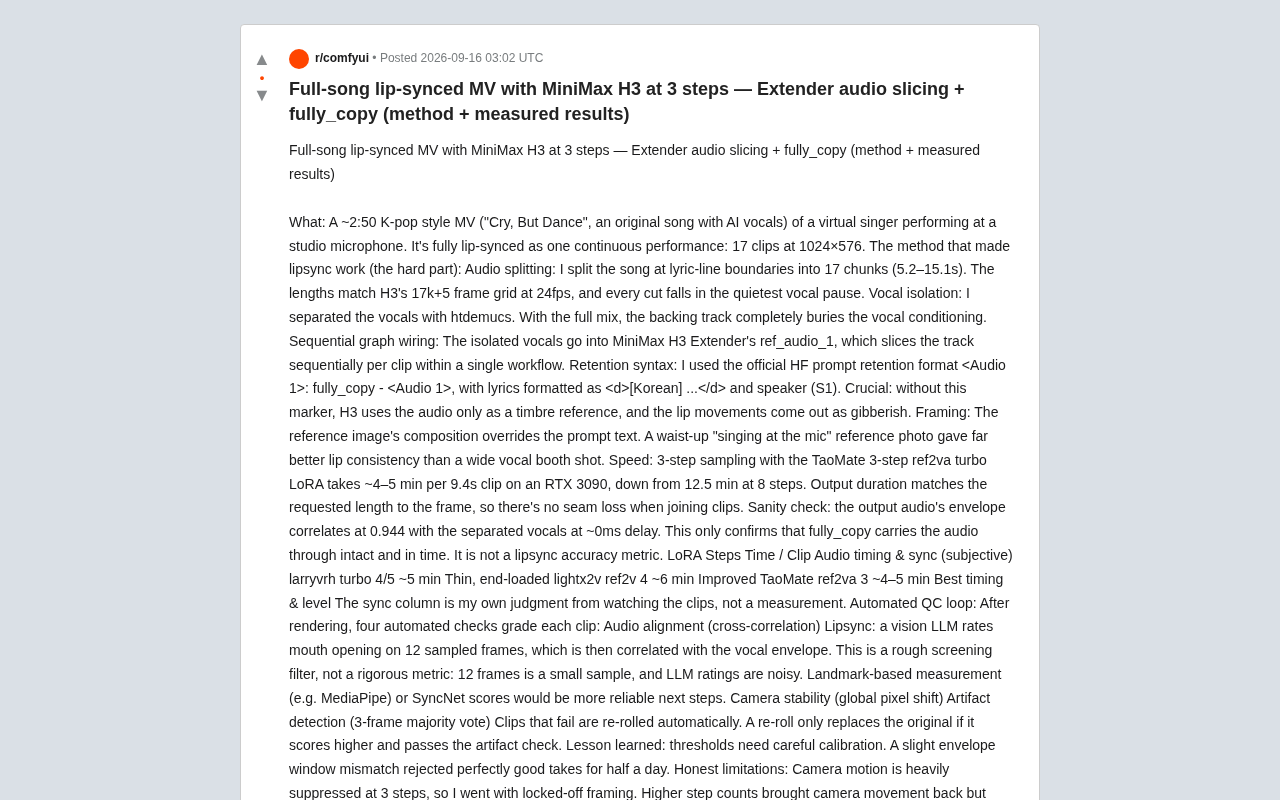
MiniMax H3实测:3步采样打造整首歌口型同步MV
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。