把网络交给AI Agent:Cloud Run托管远程MCP服务器实战
将 MCP 服务器容器化部署到 Cloud Run,再通过 CrewAI + Nemotron 实现自然语言驱动网络设备运维的完整落地方案。
本文介绍了一套将本地 MCP 服务器迁移至云端并接入 AI Agent 的完整实战方案。核心路径是:用三个文件(Dockerfile、server.py、requirements.txt)将思科 Catalyst Center MCP 服务器打包成容器,部署到 Google Cloud Run 并暴露为 Streamable HTTP 端点;在 CrewAI 中创建 Skill 和 Agent,通过 MCP 连接自动发现工具;配合 Nemotron 大模型和 Crew Studio 生成路由工作流,将用户请求分流至只读、排障和变更三类操作。实测用一句自然语言成功列出网络中四台交换机的完整信息。方案中密码通过 Secret Manager 管理、容器分配 2GB 内存、分支名使用 master 等细节均为避坑关键。这一架构可推广至任何需要将企业内部工具通过 MCP 接入 AI Agent 的场景。
为什么要把 MCP 服务器搬上云
本地运行的 MCP(Model Context Protocol)服务器有一个天然的局限:它被“困”在你的笔记本电脑上。想要让语言模型从任何地方访问这个工具,你就得面对基础设施管理、防火墙规则配置等一系列繁琐问题,暴露难、扩展难、共享更难。
这期来自 YouTube 的实战教程给出了一条更轻量的路径——把 MCP 服务器托管到 Google Cloud Run 上,并通过 CrewAI 将其接入 AI Agent,最终实现用自然语言操作思科 Catalyst Center 网络设备。整个流程把“云端部署 + Agent 编排 + 网络自动化”串成了一条完整链路,值得想做企业级 AI Agent 的开发者参考。
MCP(Model Context Protocol)是 Anthropic 于 2024 年底发布的开放标准协议,旨在为 AI 模型与外部工具、数据源之间建立统一的通信接口。在 MCP 出现之前,每个 AI Agent 框架都需要单独为每种工具编写适配层,维护成本极高。MCP 将这一关系标准化:工具提供方只需实现一次 MCP 服务器,任何支持 MCP 协议的 Agent 框架(如 CrewAI、Claude Desktop 等)都可以直接发现并调用其中暴露的工具,实现真正意义上的即插即用。思科 Catalyst Center(原 DNA Center)是思科的网络管理与自动化平台,提供 REST API 用于设备发现、配置下发、故障排查等操作,将其封装为 MCP 服务器后,AI Agent 便能以自然语言驱动网络运维,而无需手动调用 API。
构建容器:Docker 与 server.py
要把 MCP 服务器容器化,核心只有三个文件:Dockerfile、server.py 和 requirements.txt。
Dockerfile 的逻辑相当精简:基于官方轻量级的 Python 3.13 Slim 镜像构建,更新系统包并安装 Git,把工作目录设为 /app,再复制 requirements 文件并用 pip 安装依赖,最后复制 server.py、设置环境变量、暴露 8080 端口,并指定容器启动时直接运行 server.py。
server.py 同样简单,它的全部作用就是把 Catalyst Center MCP 服务器包装成一个 streamable HTTP 端点。这一点至关重要——因为 CrewAI 只支持 streamable HTTP 类型的 MCP 服务器,这是整个方案能跑通的前提。服务器会在 8080 端口、所有网络接口上监听。
requirements.txt 里的依赖其实只有一个:直接来自 GitHub release 的 Catalyst Center MCP 包。
准备好这些文件后,通过 git init、git add 暂存全部内容,再创建一个公开仓库(公开是为了让 Cloud Build 能直接拉取代码)。这里有个容易被忽略的细节:GitHub 创建的默认分支名是 master 而非 main,这个值在后续 Cloud Build 配置里会再次用到。
Streamable HTTP 是 MCP 协议在 2025 年引入的传输层规范,用于取代早期基于 SSE(Server-Sent Events)的方案。它允许客户端通过标准 HTTP POST 请求发送调用,服务器可以选择以流式或非流式方式返回结果,兼顾了实时性与兼容性。这一传输方式天然适合云端部署:容器只需暴露一个普通的 HTTP 端口,无需维护长连接,负载均衡器和反向代理可以透明地处理流量。相比之下,早期的 stdio(标准输入输出)传输方式要求客户端与服务器进程在同一台机器上运行,这正是本地 MCP 服务器无法被远程访问的根本原因。CrewAI 目前仅支持 Streamable HTTP,因此 server.py 做的这层包装是整个云端方案得以成立的技术基础。
部署到 Cloud Run:分支、内存与密钥
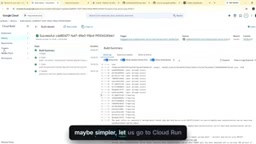
进入 Cloud Run,使用 Cloud Build 把它与刚才的仓库连接起来,这样每一次 push 都会自动构建成容器镜像。
配置过程中有几个关键点:
- 分支必须设为 master,这正是很多人翻车的地方;
- 允许公开访问(public access);
- 在容器配置里给足 2GB 内存,因为 MCP 服务器在启动时会把大量内容加载进变量中。
环境变量方面,作者使用了一个运行中的 Catalyst Center 沙盒,需要把主机名、用户名、密码等按照官方 MCP 文档要求的变量名逐一填入。值得学习的是密码的处理方式:不把密码以明文形式放进环境变量,而是通过 Secret Manager 以密钥(secret)形式引用,并选择最新版本。这样敏感信息永远不会落在环境变量里,是一个符合生产实践的安全习惯。
配置完成后创建服务,可以实时查看构建日志,看到它从 Dockerfile 开始逐步构建镜像。
在 CrewAI 中创建 Skill 与 Agent
趁着云端构建的间隙,教程转向 CrewAI 侧的准备工作。
第一步是创建 Skill。在 CrewAI 目录下执行 crewai create skill,命名为 catalyst center network operations,工具会生成一个 skill.md 文件——这个文件正是存放实际指令的地方。作者把事先准备好的指令文本粘贴进去保存,并在确认当前 org 正确、目录正确后发布这个 Skill。
当 Cloud Run 构建完成后,复制生成的服务 URL,回到 CrewAI 的 Tools and Integration,新增一个连接,命名为 catalyst MCP server,URL 填入时需要补上 /v1/mcp 路径,选择无需认证并创建。连接成功后,CrewAI 会自动发现大量工具(tools),这就是 MCP 协议带来的即插即用能力。
接着创建 Agent:选择 crew agent,填入 role、goal、backstory 三项核心定义,选中前面创建的 Skill,开启 reasoning 和 memory,并在 integration apps 里关键性地选中刚连接好的 catalyst MCP server。至此 Agent 创建完成。
接入 LLM 与 Crew Studio 编排工作流
最后一块拼图是 LLM 连接。教程使用了 Nemotron 模型,通过 OpenRouter 获取 API key(作者还贴心地给 key 设置了 1 小时过期)。在 CrewAI 的 LLM Connections 中新增连接,provider 选择 Custom OpenAI Compatible,填入 API key,并从 OpenRouter 的模型页面(如 Nemotron Ultra)复制对应的 base URL 粘贴进去,随后 fetch models、添加模型并创建。
进入 Crew Studio 后,粘贴事先写好的 prompt,系统便开始自动在画布上构建工作流。生成的流程包含一个 Router(路由器),它会把用户请求分流到 Catalyst Center 自动化工程师的三类操作:只读(read only)、排障(troubleshoot)、变更(change),最后返回结果。
这里有个必须手动调整的点:默认生成的 LLM 是 GPT 模型,需要把每个节点都改成 Nemotron,并把最大执行时间设为无限制(unlimited),避免长任务被中途截断。
Nemotron 是 NVIDIA 基于 Llama 架构开发的大语言模型系列,其中 Nemotron Ultra(约 253B 参数)在推理、代码生成和工具调用任务上表现突出,尤其适合需要多步骤规划的 Agent 场景。OpenRouter 是一个聚合多家模型提供商 API 的中间层服务,开发者只需注册一个账号即可通过统一的 OpenAI 兼容接口访问包括 Nemotron、Claude、Gemini 在内的数十种模型,并可按需设置消费限额或密钥过期时间,非常适合在生产环境中管理 API 访问风险。教程中选择"Custom OpenAI Compatible"作为 provider 类型,是因为大多数非 OpenAI 模型现在都对外暴露与 OpenAI Chat Completions API 格式兼容的接口,CrewAI 等框架因此可以用同一套代码路径调用任意兼容模型。
实测:用一句话列出全部网络设备
一切就绪后,作者输入了一个真实任务:“list all the network devices in catalyst center”。
从追踪(traces)面板可以清晰看到 Agent 的完整决策链:它先分析请求,正确地判断这是一个只读操作,随后在 metrics and log 区域发起 MCP 调用,发现设备并返回结果。
最终输出是结构化的设备清单——四台交换机,包含各自的 IP 地址、品牌型号以及 iOS 版本信息。整个过程从自然语言输入到精准的网络数据输出,验证了方案的可行性。
这套方案的价值与启示
这期教程最大的意义不在于某个具体步骤,而在于它示范了一条可复用的生产级架构模式:用 Docker + Cloud Run 把任何 MCP 工具变成可随处访问的 HTTP 服务,再用 CrewAI 把它编排进具备路由、推理和记忆能力的多 Agent 工作流。
几个技术选择尤其值得借鉴:Secret Manager 管理敏感凭证、Router 对读/写/排障操作分级处理(在真实网络运维中,变更操作的隔离极为重要)、以及通过 OpenRouter 灵活切换非 OpenAI 模型。对于想把 AI Agent 真正接入企业基础设施的团队,这是一份信息密度很高的落地蓝本。
相关推荐
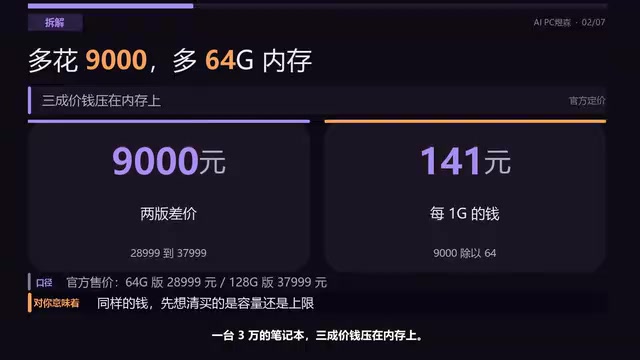
64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。
Ollama零基础教程:本地部署大模型入门指南
Ollama零基础入门教程:了解Ollama是什么、核心特点与本地部署大模型的价值。涵盖开源免费、跨平台、CPU/GPU调度、API集成等关键信息,助你快速上手本地大模型管理工具。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。