本地AI推理引擎选型指南:五层架构拆解与场景匹配

系统拆解本地AI推理栈五层架构,厘清llama.cpp、Ollama、vLLM等工具的本质定位与适用场景。
本文指出将llama.cpp、Ollama、vLLM和LM Studio相互比较是「范畴错误」——它们分属推理栈的不同层次:底层执行运行时、模型生命周期管理器、生产级服务调度器和桌面应用工作台。文章系统梳理了从模型格式量化到应用界面的五层架构,分析了各工具的核心设计取舍:llama.cpp提供最大硬件控制权,适合消费级混合卸载;Ollama以简洁管理换取底层可见性;LM Studio是专有桌面工作台;vLLM与SGLang凭借PagedAttention和RadixAttention主导高并发生产环境。文章还前瞻了FreeToken和Colibri两个针对边缘MoE推理的实验性引擎,结论是选型的核心逻辑在于「哪一层最匹配你的场景」,而非追逐benchmark截图。
把 Ollama、llama.cpp、vLLM 和 LM Studio 当作同一工具的四个版本来比较,本身就是一个「范畴错误」。它们分别是应用程序、API 管理器、底层执行运行时和数据中心服务调度器。如果你仅凭社交媒体上一张「每秒 token 数」的截图来选择推理引擎,那你测量的根本就是错误的瓶颈。
本文基于 B站UP主 RepoChad 的深度梳理,系统性地拆解本地 AI 推理栈的五个层次,并给出面向不同场景的选型建议。
本地AI推理栈的五个层次
要搞清楚本地模型为什么跑得慢,首先要把推理栈拆分为五个截然不同的层次:
- Layer 1 — 模型格式与量化算法:如 GGUF、EXL3、FP8 或原始 safetensors。
- Layer 2 — 执行运行时与计算内核:真正在硬件上执行矩阵乘法的底层引擎。
- Layer 3 — 服务引擎与调度器:负责连续批处理、内存分配以及并发请求下的 KV 缓存分页。
- Layer 4 — 本地守护进程与模型生命周期管理:负责下载权重、配置端点、管理显存驻留。
- Layer 5 — 应用工作台:提供图形界面、本地文档检索和工具配置。
关键在于:当有人声称「A 工具比 B 工具强」时,他们往往是在比较推理栈中完全不同的两层。理解这一点,是理性选型的前提。
理解这五层的独立性至关重要。Layer 1 的格式决定了权重如何被编码和压缩——GGUF 是 llama.cpp 生态的统一容器格式,支持多种量化精度(Q4_K_M、Q8_0 等);EXL3 是 ExLlamaV2 引擎专用的高效量化格式;FP8 则是面向数据中心 GPU 的低精度浮点标准。量化本质上是用精度换内存:一个 70B 参数的模型以 FP16 存储需约 140GB,量化至 4-bit 后可压缩至约 35GB,但会引入不同程度的精度损失。Layer 2 的计算内核则决定矩阵乘法在特定硬件上的实际吞吐——同一模型格式在不同内核实现下,速度可能相差数倍。这也是为什么「每秒 token 数」的截图必须注明硬件环境、量化等级和运行时版本,才具备任何比较意义。
llama.cpp:底层控制的基准运行时
llama.cpp 是一个 MIT 许可的 C/C++ 参考运行时,以 GGUF 格式为核心。它的主要优势是可移植性和细粒度的硬件控制:可以通过 Metal 在 Apple Silicon 上运行,也支持现代 x86 处理器,以及运行 CUDA、ROCm 或 Vulkan 的显卡。
更重要的是,llama.cpp 是部分卸载(partial offloading)的标准。如果你只有一块 RTX 3060 12GB,你可以把模型的 20 层加载进显存,剩余层溢出到系统内存。它的 server 二进制文件现在也支持连续批处理、推测解码和 OpenAI 兼容端点。
但需要注意的是,它的连续批处理是为轻负载设计的,适合单用户大工作负载而非高并发多用户饱和场景,分页 KV 缓存实现仍在持续开发中。如果你想在消费级硬件上对线程分配、tensor split 拥有最大程度的底层控制,llama.cpp 就是你的基准线。
Ollama:简洁高效的模型生命周期管理器
开发者论坛里一个常见误解是:Ollama 只是 llama.cpp 的一层封装。这个描述早已过时。虽然它起步于此并保留了 GGUF 兼容运行器,但如今 Ollama 已经构建了自己的第一方多模态引擎用于视觉模型,并在 Apple Silicon 上通过原生 MLX 路径运行。
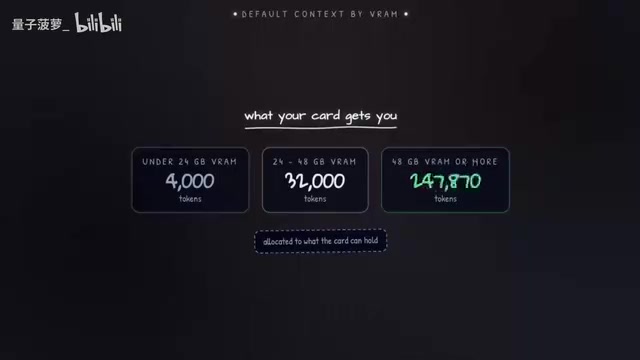
Ollama 本质上是一个模型生命周期管理器,提供简洁的命令行界面、托管的 manifest,以及监听 11434 端口的 API。在当前版本中,其默认上下文窗口会根据硬件自动扩展:
- 显存低于 24GB:默认 4000 tokens
- 显存 24–48GB:扩展至 32,000 tokens
- 显存 48GB 以上:最高分配至 256,000 tokens
Ollama 的取舍在于底层可见性降低——你无法获得 llama.cpp 那样的直接参数旋钮,而且并行请求的内存占用会随并发数乘以活动上下文长度线性增长。
LM Studio:功能丰富的桌面工作台
LM Studio 工作在 Layer 5,是一个带可视化界面的桌面工作台,内置模型搜索、本地文档检索和 MCP(模型上下文协议),还包含一个名为 LMStudio 的无头守护进程。
底层上,LM Studio 采用可热插拔的运行时——为 GGUF 执行打包了 llama.cpp,为 Apple Silicon 打包了 MLX。因此在消费级硬件上,它的推理速度基本追随底层运行时的表现,并行请求引擎在 llama.cpp 上默认为 4 路预测。
这里最关键的区别是许可证:虽然捆绑的运行时是开源的,但 LM Studio 桌面应用本身是专有软件。它允许本地开发和内部业务使用,但条款限制再分发和 SaaS 用途。
vLLM 与 SGLang:生产级服务的两大支柱
vLLM 处在光谱的另一端,是一个 Apache 2.0 的生产级服务引擎,专为跨多个并发流最大化吞吐量而生。它的核心创新是 PagedAttention,将 KV 缓存当作操作系统里的虚拟内存页来管理,消除物理内存碎片。它支持分块预填充、前缀缓存、张量并行和多节点 GPU 集群。
需要强调的是,vLLM 并非为桌面卸载而设计。虽然技术上可以通过外部插件运行 GGUF 模型,但官方文档将 GGUF 支持视为「实验性且未优化」。如果你在 RTX 3070 上用 GGUF 单用户测试 vLLM,会比 llama.cpp 慢得多——因为你绕过了它优化的路径,却仍要支付调度器的内存税。
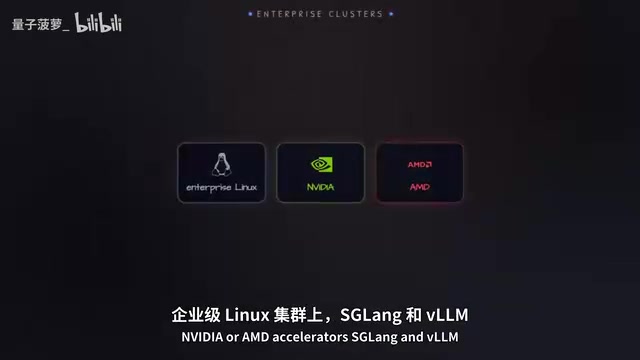
在生产领域,vLLM 直接面临 SGLang 的竞争。SGLang 使用 RadixAttention,跨请求维护一棵 KV 缓存的基数树,实现自动前缀缓存,因此在多轮 agent 对话、复杂工具调用循环和结构化 JSON 生成上尤其快。在配备现代 NVIDIA 或 AMD 加速器的企业 Linux 集群上,SGLang 和 vLLM 共同构成了真正的生产前沿。
此外,在能够固定驱动和 CUDA 版本的 NVIDIA 硬件上,TensorRT-LLM 提供定制内核优化和 in-flight batching,但它需要僵硬的构建矩阵,缺乏开源框架的即插即用体验。
PagedAttention 的核心洞见来自操作系统的虚拟内存设计。传统推理框架在请求到来时为 KV 缓存预分配连续的最大长度显存块,即便实际序列远短于上限,这些显存也无法被其他请求复用,导致严重的内碎片化。PagedAttention 将 KV 缓存切分为固定大小的非连续内存页,由调度器动态分配,理论上可将显存利用率从不足 40% 提升至 90% 以上,直接放大同等硬件下可服务的并发用户数量。SGLang 的 RadixAttention 则更进一步:它将共享前缀(如系统提示、few-shot 示例)的 KV 缓存以基数树形式跨请求复用,当多个用户共享同一系统提示时,该部分只需计算一次并永久缓存,显著降低首 token 延迟。这两项技术在单用户本地测试中几乎感知不到优势,但在数十到数千并发请求的生产环境下,差异会被急剧放大。
MoE 时代的边缘推理:FreeToken 与 Colibri
近期最大的架构进展,集中在如何在消费级硬件上运行超大规模 MoE(混合专家)模型。当一个 MoE 模型拥有数千亿总参数时,把整个权重矩阵塞进消费级显存是不可能的。
FreeToken 是一个 Apache 2.0 许可的边缘原生 MoE 服务引擎。它的设计将非专家权重保留在 GPU 上,将完整的专家权重池存储在系统主机 RAM 中,并将剩余显存作为动态 LRU 专家缓存。当发生专家缓存未命中时,FreeToken 会实时测量 PCIe 总线带宽并拆分计算——一部分缺失专家流量走总线到 GPU,其余则直接在 CPU 上执行。
据其技术论文,在 RTX 5090 系统上,Qwen3-235B-A3B 可达 77–83 tokens/s,DeepSeek广告 相关模型在 agent 轨迹上可达 22–25 tokens/s;甚至在 8GB RTX 4060 笔记本上运行 35B 参数模型也有可观表现。不过当前 CLI 需要 Linux x86_64、NVIDIA GPU 和 CUDA 13,支持模型列表也较为受限。
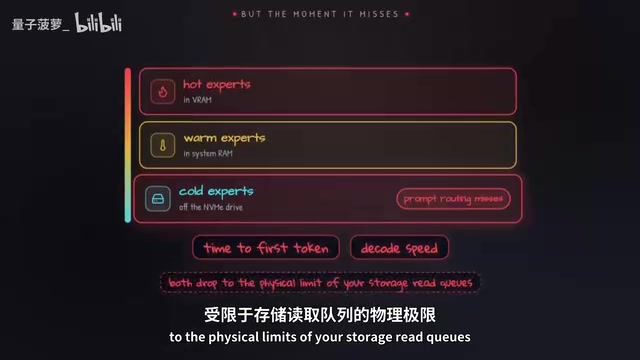
另一个实验性项目 Colibri 用纯 C 编写、零运行时依赖,引入三级内存模型:热专家驻留显存、温专家驻留系统内存、冷专家直接从 NVMe SSD 流式读取。它能在仅 25GB 内存下加载 GLM 这类超大模型——但必须区分物理容量与交互延迟。一旦提示路由未命中缓存,首 token 时间和解码速度就会跌到存储读队列的物理极限。这是出色的内存分层工程演示,但绝非「零延迟的魔法」。
MoE(Mixture of Experts,混合专家)架构的关键特性是稀疏激活:模型拥有大量并行的「专家」前馈网络,但每次前向传播只有少数几个专家被路由器选中并激活。以 DeepSeek-V3 为例,它拥有约 671B 总参数,但每个 token 只激活约 37B 参数。这意味着 MoE 模型的「计算量」远小于同等参数量的密集模型,但「内存占用」仍需加载全部专家权重。FreeToken 和 Colibri 的边缘推理策略,本质上是利用 MoE 的稀疏性——既然每次只用几个专家,就可以把冷专家放在慢速存储上,按需换入热专家。这一策略对密集模型(如 LLaMA 架构)完全无效,因为密集模型每层的全部权重在每个 token 的计算中都必须参与。
面向不同场景的推理引擎选型建议
综合来看,选型逻辑其实非常清晰:
- 想要简洁 GUI 的桌面体验 → 用 LM Studio
- 需要集成开发工具、像管理软件包一样管理模型的本地 API 守护进程 → 用 Ollama
- 在 CPU/GPU 混合的消费级硬件上想完全控制 GGUF 量化 → 用 llama.cpp
- 构建服务并发用户的自动化系统、跑专用加速器 → 部署 SGLang 或 vLLM
- 在现代消费级 NVIDIA 卡上实验超大稀疏 MoE 架构 → 密切关注 FreeToken 和 Colibri
归根结底,本地 AI 推理引擎没有「谁最强」的答案,只有「哪一层最匹配你的场景」。理解五层架构,比追逐任何一张 benchmark 截图都更有价值。
相关推荐

通用AI模型直接操控机械臂,成功率远超专用策略
研究者提出智能体操作策略AMPs,让通用AI模型直接控制机械臂。AMP1框架在RoboLab-120零样本成功率达85.6%,远超VLA的49.2%和WAM的42.9%,真实世界108次试验成功104次,失败率降低20倍和15倍。

MLSys 2027审稿人尚未收到论文分配?社区讨论引关注
Reddit社区讨论MLSys 2027审稿人是否已收到论文分配。互惠审稿人反映尚未被分配论文,社区关注分配时间线及对评审工作的影响。

RTX 5060 Ti 16GB被抢购:AI热潮下的显卡新宠
Reddit社区热议RTX 5060 Ti 16GB显卡遭AI用户抢购,分析其显存优势、性价比及对市场的影响,探讨AI硬件需求新趋势。