别再盲信AI供应商:两步堵住模型溯源与隐私泄露

托管AI API存在模型版本黑箱与提示词去向不明两大信任缺口,本地代理层可将部分信任转为可验证。
文章针对托管AI API的两个结构性信任问题展开:一是模型版本不透明,API文档声称的模型可能与实际运行版本不符,供应商有动机在高负载时悄悄降级为蒸馏或量化模型;二是提示词离开本地后去向不明,训练用途、日志保留、人工审查均缺乏技术验证手段。作者提出本地代理层方案,通过模型指纹检测建立可复现的行为基线,通过提示词最小化与脱敏降低隐私暴露面。但两方案均存在局限:指纹检测依赖供应商行为稳定且难以精确归因,脱敏面临效果与功能的权衡。结论是:把不可观测变为部分可观测,信任应建立在证据之上。
调用托管式AI API时,有两个关键问题几乎从未被验证:实际运行的到底是哪个模型版本?提示词在服务商侧被谁看到了? 开发者George Orwell在dev.to上分享了一套本地验证方案,试图把"信任"变成可检查的事实。
问题一:模型版本黑箱
API文档写着"gpt-4"或"claude-3",但实际响应可能来自更便宜的蒸馏版本、量化版本,甚至是上一代模型。供应商有充分动机在负载高峰期悄悄降级,而这种降级对开发者完全不可见。
这不是阴谋论。不同模型在推理能力、上下文长度、工具调用格式上的差异足以让线上应用行为突变——而你的监控面板上只会显示"API正常"。
蒸馏模型(Distilled Model) 是指用大模型(教师模型)的输出作为训练数据,训练出参数更少、推理更快的"学生模型"。厂商常在同一 API 名称下混用蒸馏版本以降低成本,但其推理深度、长链逻辑和边界情况处理能力往往明显弱于原版,用户却难以从响应本身察觉。
量化(Quantization) 则是把模型权重从 FP16/BF16 等高精度格式压缩为 INT8、INT4 甚至更低比特表示,以减少显存占用和推理延迟。低比特量化在多数日常问答中表现接近原模型,但在数学推理、代码生成、长上下文检索等任务上会出现明显退化。这两类"降级"在监控面板上通常只体现为延迟和成本的改善,而不会触发任何错误或告警,因此极难被传统可观测性工具发现。
问题二:提示词去向不明
托管API意味着你的提示词必须离开本地。谁读了它?是否用于训练?日志保留多久?安全团队是否有人工审核?大多数服务条款用模糊措辞回避了这些问题,而开发者没有技术手段去核实。
对于处理用户数据、内部代码或商业策略的应用,这不是合规文档能解决的——它是一个结构性信任缺口。
提示词(Prompt) 在托管 API 场景中不只是用户的输入文本,往往还包含系统指令、few-shot 示例、检索到的内部文档片段、工具调用 schema,甚至被拼接进上下文的数据库记录。也就是说,一条提示词可能同时暴露业务逻辑、用户隐私和内部知识库结构。
与自托管模型相比,托管 API 的调用链路是黑箱:请求经过服务商的多层网关、负载均衡、日志系统与安全审核管线。多数服务条款只承诺"可能用于改进服务"这类模糊表述,既不明确训练用途的边界,也不提供数据删除的可验证接口。对企业而言,这构成了结构性信任缺口——不是通过签署 DPA 或阅读合规文档就能消除的,因为合规文档约束的是法律义务,而无法回答"这条提示词此刻在谁的机器上、被谁看到"这一技术事实。
解决方案:本地可验证的代理层
作者的思路是在调用链路中插入自己控制的中间层,让"供应商说了什么"变成"我能测出什么"。
核心做法包括:
- 模型指纹检测:通过固定提示词观察响应特征(token分布、特定格式偏好、能力边界),建立可复现的模型行为基线。当供应商切换后端模型时,指纹会漂移。
- 提示词最小化与脱敏:在请求发出前剥离敏感内容,只传输完成任务所必需的信息。这是降低隐私暴露面的直接手段。
这两招的共同点是:不要求供应商改变行为,只改变自己发送和验证的方式。
模型指纹(Model Fingerprinting) 借鉴了传统软件指纹识别的思路:向 API 发送一组精心设计的探测提示词,记录响应中的统计特征,例如特定 token 的分布偏好、对格式指令的服从度、对边界问题的拒答模式、输出长度的分布等。将这些特征与已知模型的行为基线比对,就能在供应商悄悄切换后端时捕捉到漂移信号。
代理层(Proxy Layer) 则是一个运行在开发者自己环境中的中间服务,位于应用与托管 API 之间。它承担两件事:一是拦截并改写请求,剥离或替换敏感字段;二是记录完整的请求/响应样本,供离线的指纹比对和回归测试使用。其价值在于把原本不可观测的调用链路变成可审计、可复现的数据流,而不依赖供应商提供任何额外接口或承诺。
每个方案的局限
作者坦率地指出了短板。
模型指纹检测依赖供应商行为稳定。一旦对方随机化输出或引入噪声防御,指纹会失效;而且它只能识别"变了",难以精确归因到具体模型型号。
提示词脱敏的困境在于效果与功能的权衡。脱敏越彻底,模型能理解的信息越少,回答质量下降。某些任务本质上就需要完整上下文,此时本地代理层能做的很有限。
换句话说,这两个方案把"完全信任"降级为"有条件验证",但没有消除信任本身。
从可观测性角度看,模型指纹检测属于行为级黑盒探测,其精度受限于探测提示词的设计质量和供应商引入的随机性。若供应商在采样温度、top-p 或输出后处理上做随机化,指纹信号会被噪声淹没。此外,即使检测到行为变化,也缺乏从响应反推具体模型型号的可靠方法,只能判断"变了"而非"变成了什么"。
提示词脱敏则涉及效用-隐私权衡:脱敏规则越严格,模型可用的上下文越少,回答的相关性和准确性下降越明显。对于代码补全、法律文档分析、医疗问答等高度依赖完整上下文的任务,脱敏空间极为有限,本地代理层能提供保护的范围也相应收窄。两者共同构成的是有条件验证框架,而非对供应商信任的替代方案。
对开发者的实际意义
在AI基础设施快速演进的当下,供应商锁定和版本漂移是真实风险。作者方案的实用价值不在于完美,而在于把不可观测的东西变成可观测的——哪怕只是部分可观测。
对于构建在托管API之上的生产系统,至少应该建立模型行为的回归测试,并对发送出去的提示词内容保持明确意识。信任可以被给予,但最好建立在证据之上。
相关推荐

开源多Agent模拟经营项目实战评测
基于B站UP主开源的多Agent沙盘经营项目实测,拆解其规划、记忆、多Agent通信、HITL与评估机制,对比大模型自主决策与固定规则引擎在不同场景下的收益差异,为Agent开发者提供选型与工程实践参考。
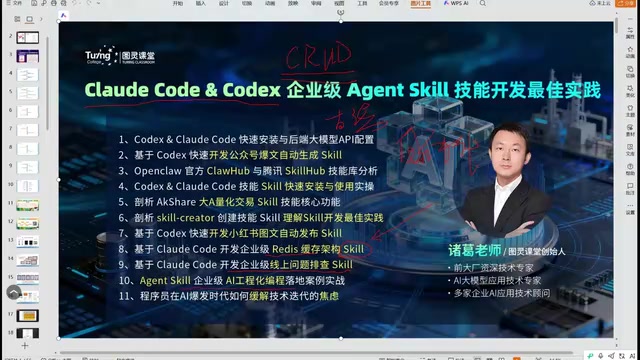
AI工程化实战:Claude Code与Agent Skill开发全流程
B站实战课解析AI工程化:用Claude Code、Codex、WorkBuddy开发企业级Agent Skill,涵盖公众号报文、量化分析、小红书自动发布等案例,讲透Skill驱动开发的范式转移与工具选型。
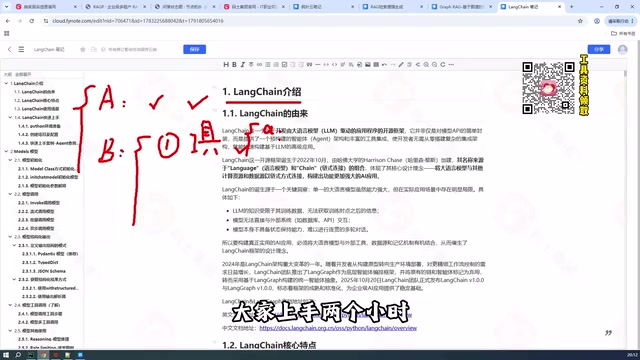
LangChain零基础入门:结构化输出与Agent实战指南
从LangChain零基础讲起,厘清低代码平台与大模型应用开发的本质区别,覆盖结构化输出、工具调用、Agent实战与多租户RAG企业项目落地四大模块,适合有开发基础想转型AI应用开发的工程师。