Browser Use深度解析:自然语言驱动的浏览器自动化智能体实战指南
Browser Use:自然语言驱动的浏览器自动化智能体工具全面解析
Browser Use 是一款以自然语言驱动的浏览器自动化智能体工具,用户只需用日常语言描述任务即可自动执行浏览器操作。它采用智能体+大模型+工具的标准架构,通过结构化返回(而非Function Calling)与大模型交互,兼容多种主流模型。底层已从Playwright迁移至CDP协议,提升了长时间运行的稳定性。结合pytest等框架,可实现工业级的Web自动化测试。
什么是 Browser Use?
Browser Use 是一款以自然语言驱动的浏览器自动化智能体工具,官方将其定义为「以纯文本的形式自动执行浏览器任务」。换句话说,你只需要用日常语言描述想在浏览器中完成的操作,Browser Use 就能自动帮你执行——无需编写复杂的定位脚本或操作代码。
这个工具目前被业内公认为最优秀的浏览器自动化智能体之一,阿里云广告也曾在其技术文章中提到使用 Browser Use 作为核心智能体方案。它的核心理念非常直接——重复性的浏览器工作已经过时了,借助 AI Agent 的能力,大量机械化的浏览器操作都可以被高效自动化。
这里提到的 AI Agent(智能体),是指能够感知环境、自主决策并采取行动以达成目标的智能系统。与传统的单次问答式 AI 不同,Agent 具备任务规划、工具调用、记忆管理和多步推理的能力。一个典型的 Agent 由感知模块(获取环境信息)、决策模块(通常由大语言模型驱动)和执行模块(调用外部工具完成操作)三部分组成。在浏览器自动化场景中,Agent 需要不断地观察页面状态、推理下一步操作、执行浏览器指令,并根据执行结果调整策略,形成一个持续的感知-决策-行动循环。
架构解析:Browser Use 的工作原理
作为一个标准的 AI Agent,Browser Use 具备智能体的典型特征。下面从各个核心层次拆解它的架构设计。
客户端层
Browser Use 提供了三种交互方式:命令行(CLI)、代码调用(Python API)以及在线云服务。开发者可以根据实际场景灵活选择。
智能体内核
工具的核心是一套完整的智能体系统,由大模型、工具集和提示词三大要素组成。智能体负责管理消息历史、协调各组件之间的交互流转。
大模型支持
Browser Use 兼容多种主流大模型,包括 Ollama(本地部署模型)、OpenAI、Claude 等。你可能没注意到,它采用结构化返回(Structured Output)的方式与大模型交互,而非传统的 Function Calling。这一设计让它的模型适配范围更广——只要支持结构化返回的模型都能接入使用。
要理解这一设计选择的意义,需要了解两种方案的区别。Function Calling 是 OpenAI 在 2023 年推出的一种机制,允许大模型在对话中声明需要调用某个预定义函数,并输出符合函数签名的参数。这种方式依赖模型提供商的特定 API 实现,不同厂商的支持程度和格式各异。结构化返回则是一种更通用的方案——通过在提示词中定义 JSON Schema,要求大模型直接输出符合该 Schema 的 JSON 数据。这种方式不依赖特定的 API 特性,只要模型能够遵循指令输出合法 JSON 即可,因此对不同模型的兼容性更好。Browser Use 选择结构化返回而非 Function Calling,正是为了最大化模型适配范围。
浏览器控制层
底层技术经历了一次关键演进:早期版本基于 Playwright 实现浏览器控制,而最新版本已经切换到 CDP(Chrome DevTools Protocol),直接调用 Chrome 浏览器的开发者协议。这一变更显著提升了长时间运行场景下的性能和稳定性。
Chrome DevTools Protocol(CDP)是 Chrome 浏览器内置的远程调试协议,它允许外部程序通过 WebSocket 连接与浏览器进行底层通信。CDP 提供了对浏览器几乎所有功能的编程访问,包括 DOM 操作、网络拦截、JavaScript 执行、性能分析、页面截图等。Google 官方的 Node.js 浏览器自动化库 Puppeteer 就是直接基于 CDP 构建的。相比之下,Playwright 虽然也使用 CDP 与 Chromium 通信,但在其上增加了一层自己的抽象协议和进程管理机制,这在长时间运行的场景下可能引入额外的开销和不稳定因素。直接基于 CDP 开发意味着减少了中间层,能够更精细地控制浏览器行为,但也意味着需要自行处理许多 Playwright 已经封装好的便利功能。
完整工作流程
一次典型的任务执行流程如下:
- 用户以自然语言发布任务给智能体
- 智能体构建提示词并发送给大模型
- 大模型根据工具清单返回结构化的工具调用指令
- 智能体通过 CDP 协议控制浏览器执行具体操作
- 浏览器返回页面的 DOM 结构和当前状态
- 智能体将执行结果反馈给大模型,进行下一轮决策
- 经过多轮循环迭代,直到大模型判断任务已完成
安装与快速上手
环境准备
官方推荐使用 Python 3.12 环境,具体安装步骤如下:
# 创建隔离环境(使用 uv 工具)
uv venv --python 3.12
# 激活环境
source .venv/bin/activate
# 安装 Browser Use
pip install browser-use
# 如需命令行工具
pip install browser-use[cli]
# 安装浏览器(借用 Playwright 的安装能力)
playwright install
注意:最新版本启动时会下载一些海外资源,国内用户首次运行可能需要配置代理。
代码方式调用(推荐)
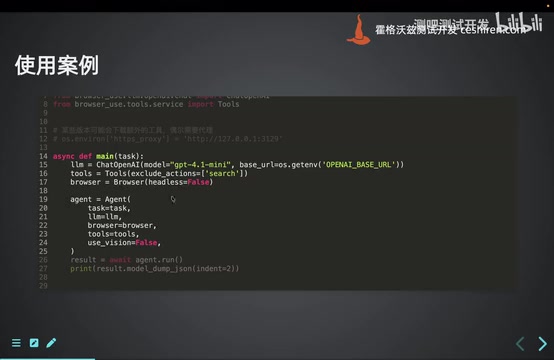
官方主推通过 Python API 进行调用,灵活性最高:
from browser_use import Agent
from langchain_openai import ChatOpenAI
from dotenv import load_dotenv
import asyncio

load_dotenv()  # 加载 .env 配置文件中的环境变量

async def main():
    llm = ChatOpenAI(model="gpt-4o")  # 初始化大模型
    agent = Agent(llm=llm, task="打开百度搜索Browser Use")
    result = await agent.run()  # 异步执行任务

asyncio.run(main())
代码方式的优势在于可以灵活封装,比如与 pytest 结合实现批量测试用例的自动化运行。
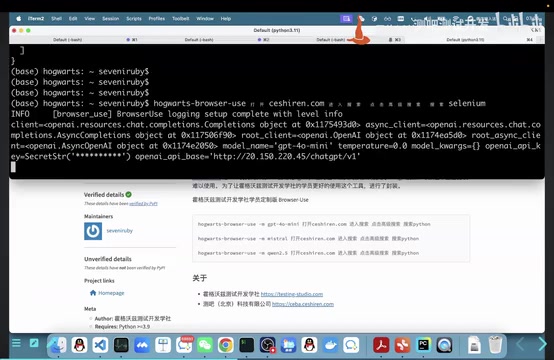
命令行方式
browser-use --model gpt-4o "打开百度搜索Browser Use"
命令行方式上手简单,适合快速验证。但参数暴露有限,许多高级配置无法通过命令行完成。
核心配置详解
三级配置体系
Browser Use 的配置分为三个层级:配置文件(.env)→ 环境变量 → API 参数传入。三者优先级依次递增,API 参数能实现最精细化的控制。
Agent 智能体参数
Agent 是最核心的 API 入口,初始化和 run 方法都提供了丰富的参数选项:
- 浏览器配置:窗口大小、是否可视化、无头模式、复用已有浏览器实例等
- 模型配置:选择大模型类型、是否启用视觉能力
- 工具配置:内置工具的增删管理
- 运行控制:最大执行步数、前后钩子函数等
关于视觉模型,默认配置为 auto(自动检测)。但根据实际使用经验,建议关闭视觉模型,因为视觉识别的稳定性尚有不足。纯文本模式下,Browser Use 基于可访问性树(Accessibility Tree)和 DOM 结构解析页面内容,这是目前最稳定可靠的方案。
可访问性树(Accessibility Tree)是浏览器根据页面 DOM 结构生成的一棵语义化树形结构,最初设计目的是为屏幕阅读器等辅助技术提供页面内容的结构化描述。每个节点包含元素的角色(如按钮、链接、文本框)、名称、状态(如是否可点击、是否展开)等语义信息。在 AI 驱动的浏览器自动化中,可访问性树成为了一种极其高效的页面表示方式——相比原始 HTML 代码,它过滤掉了大量样式和布局噪音,只保留了与交互相关的语义信息,大幅减少了传递给大模型的 Token 数量,同时提供了足够的上下文让模型理解页面结构并做出操作决策。这也是 Browser Use 建议关闭视觉模型、采用纯文本模式的技术基础。
工具系统(Tools)
Browser Use 内置了十余种常用工具,涵盖搜索、点击、输入、截图等操作。工具系统支持灵活的增删定制:
from browser_use import Controller

# 排除不需要的内置工具(如 Google 搜索在国内不可用)
controller = Controller(exclude_actions=["search_google"])

# 添加自定义工具
@controller.action("自定义工具描述", param_model=MyParams)
async def my_custom_tool(params: MyParams):
    # 执行自定义业务逻辑
    return ActionResult(extracted_content="执行结果")
在工具响应处理方面,默认会将所有工具输出发送给大模型。但对于生成图片、视频、大型 PDF 等场景,可以自定义响应策略——只告诉大模型「任务已完成」,而将实际产物保存到本地,避免不必要的 Token 消耗。
提示词与 ReAct 机制深度剖析
通过抓包分析 Browser Use 与大模型之间的通信内容,可以发现它的提示词工程设计相当精细。
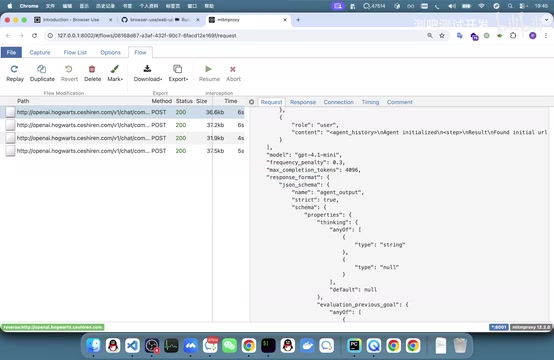
系统提示词的五层结构
- 角色定义:明确告知大模型「你是一个能执行浏览器自动化任务的 AI」
- 能力描述:逐一列举所有可执行的操作(点击、输入、提交表单等)
- 上下文信息:当前浏览器状态、页面 DOM 结构、执行历史、用户原始请求
- 规则约束:包含大量推理规则和行为规范,引导大模型做出合理决策
- 响应格式:要求大模型以结构化的 ReAct 格式输出
结构化 ReAct 策略
Browser Use 通过结构化返回实现 ReAct(Reasoning + Acting)策略。大模型每次返回的 JSON 结构包含以下字段:
thinking:当前的推理思考过程evaluation:对当前页面状态的评估memory:需要跨步骤记忆的关键信息next_goal:下一步的具体目标action:要执行的具体操作(从工具清单中选择)
ReAct 是 2022 年由普林斯顿大学和 Google 联合提出的一种 AI Agent 推理框架,其核心思想是让大语言模型在执行任务时交替进行「推理」(Reasoning)和「行动」(Acting)。在每一步中,模型先用自然语言表达当前的思考过程(类似思维链 Chain-of-Thought),然后基于推理结果选择一个具体的工具或动作来执行,再根据执行结果进行下一轮推理。这种方式相比纯推理或纯行动的方案,能够显著提升任务完成的准确率和可解释性。Browser Use 将 ReAct 的思考过程结构化为 thinking、evaluation、memory、next_goal、action 等字段,使得每一步的决策过程都清晰可追溯。
这种实现方式不依赖 Function Calling 机制,而是通过结构化输出完成工具调用,对不同大模型的适配性更强。
底层框架演进:从 Playwright 到 CDP
Browser Use 团队自研了一套基于 CDP 协议的浏览器自动化框架,用以替代早期依赖的 Playwright。迁移的主要原因是 Playwright 在长流程、长时间运行的场景下存在性能瓶颈和稳定性问题。
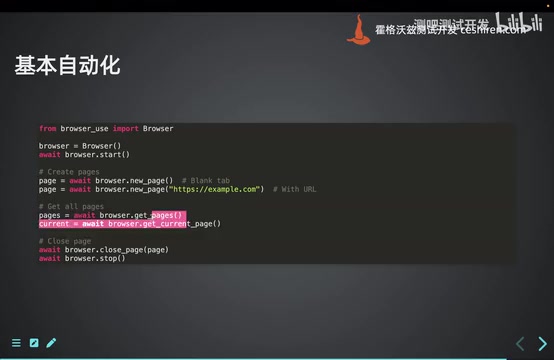
新框架具备以下特点:
- 直接基于 CDP 协议通信,减少中间层开销,性能更高
- 封装了浏览器实例、页面管理等基础概念
- 支持 CSS 选择器精准定位元素
- 集成了 AI 辅助定位能力——可以通过自然语言描述让大模型帮助定位页面元素
- 支持获取当前活动页面、页面计数等 Playwright 不便实现的功能
当然也存在一定取舍。Playwright 由微软开发维护,是目前最流行的跨浏览器自动化测试框架之一,提供了许多开发者友好的高级特性。例如 Locator 的自动等待机制(Auto-waiting)——在执行点击或输入操作前,Playwright 会自动等待元素变为可见、可交互状态,无需开发者手动编写等待逻辑。此外,Playwright 还支持跨浏览器(Chromium、Firefox、WebKit)测试、网络请求拦截、Trace Viewer 可视化调试等功能。Browser Use 从 Playwright 迁移到自研 CDP 框架,虽然在长流程稳定性上获得了提升,但也意味着这些便利的高级封装需要重新实现或由开发者自行处理,这是一个典型的控制力与便利性之间的工程取舍。
实战:结合 pytest 批量执行浏览器自动化测试
Browser Use 在 Web 自动化测试领域的应用非常直观——结合 pytest 的参数化功能,可以轻松实现测试用例的批量运行:
import pytest
from browser_use import Agent

test_cases = [
    "打开百度搜索Python",
    "打开测试人社区,进入高级搜索,搜索自动化测试",
]

@pytest.mark.parametrize("task", test_cases)
async def test_browser_task(task):
    agent = Agent(llm=llm, task=task)
    result = await agent.run()
    assert result is not None
在此基础上还可以进一步扩展:从 Jira、禅道或其他测试管理平台远程拉取测试用例,动态转换为参数化数据,搭建一条完全自动化的测试执行流水线。
总结与选型建议
Browser Use 是当前浏览器自动化智能体领域最成熟的开源工具之一,核心优势可以归纳为以下几点:
- 自然语言驱动:大幅降低浏览器自动化的使用门槛,非技术人员也能上手
- 架构设计清晰:遵循智能体 + 大模型 + 工具的标准范式,易于理解和扩展
- 模型适配范围广:基于结构化返回而非 Function Calling,兼容更多大模型
- 底层性能优秀:从 Playwright 迁移到 CDP 协议后,长时间运行的稳定性显著提升
- 扩展性强:支持自定义工具开发,与 pytest 等测试框架无缝集成
对于 Web 自动化测试团队而言,Browser Use 已经达到了工业级可用的水平。无论是日常的回归测试、探索性测试,还是构建端到端的自动化流水线,它都是一个值得认真评估的选择。
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。