《部落冲突》手游画面分割数据集:6.9k帧、1.9k类

一个专为《部落冲突》打造的实例分割数据集,含6,909帧、420万掩码、1,900类,按基地划分验证集。
本文介绍了一个针对《部落冲突》游戏画面的实例分割数据集,包含6,909帧图像和约420万个多边形掩码,覆盖1,900个类别,帧来自侦察屏幕、战斗过程和战斗结束屏幕三个界面,同时提供YOLO seg和COCO两种格式。数据集采用按基地划分验证集的策略,避免同一基地的帧泄漏到训练集,提升泛化评估的可靠性。文章分析了1,900个类别带来的细粒度解析能力与类别分布不均衡的挑战,讨论了免费样本加付费完整版的模式对学术采用率的影响,并指出数据集仅覆盖单一游戏、长尾分布和标注质量未披露等局限。整体上,该数据集填补了手游画面理解领域的一个空白,对游戏AI研究者和开发者具有参考价值。
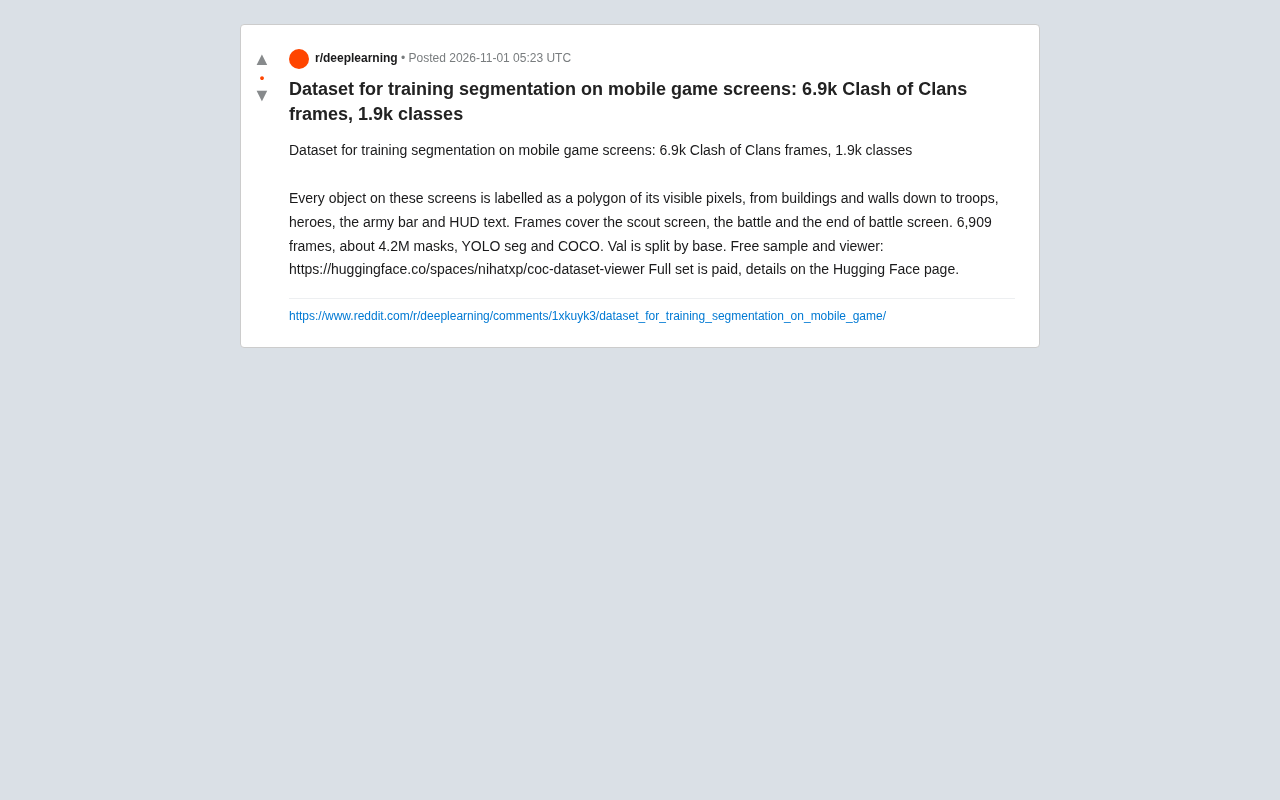
手游视觉AI的新燃料:一个专为《部落冲突》打造的分割数据集
在移动游戏AI领域,高质量标注数据一直是稀缺资源。最近,Reddit社区分享了一个专门针对《部落冲突》(Clash of Clans)游戏画面构建的实例分割数据集,包含6,909帧图像和约420万个掩码,覆盖1,900个类别。这个数据集试图将游戏屏幕上的每一个可见对象——从建筑、城墙到兵种、英雄,再到军队栏和HUD文字——都用多边形精确勾勒出来。
对于想要训练游戏理解模型的开发者来说,这无疑提供了一个现成的起点。但它的价值与局限同样明显。
数据集覆盖了什么
根据发布者描述,数据集的帧来自《部落冲突》的三个关键界面:侦察屏幕(scout screen)、战斗过程(battle)以及战斗结束屏幕(end of battle screen)。标注方式为实例分割,每个对象以其可见像素构成的多边形表示,而非简单的边界框。
数据规模方面,6,909帧图像对应约420万个掩码,类别数达到1,900个。格式上同时提供YOLO seg和COCO两种主流格式,方便接入不同的训练 pipeline。验证集按基地(base)划分,这意味着同一基地的帧不会同时出现在训练集和验证集中,有助于评估模型对新基地的泛化能力。
发布者提供了一个免费的样本和在线查看器(Hugging Face Spaces),完整数据集则需要付费获取。
实例分割与语义分割、目标检测的关键区别在于:目标检测只给出边界框,语义分割为每个像素分配类别标签但不区分同类个体,而实例分割要求同时区分类别和个体,即每个对象(如两座同等级弓箭塔)都有独立的掩码。本文数据集用多边形表示掩码,相比像素级掩码更紧凑,便于存储和转换,但也要求标注者精确勾勒对象轮廓。YOLO seg格式是Ultralytics框架支持的实例分割标注格式,通常以文本文件存储多边形坐标;COCO格式则是更通用的JSON结构,被Detectron2、MMDetection等广泛支持。两者并存降低了数据集接入不同训练pipeline的迁移成本。
为什么按基地划分验证集很重要
在游戏画面分割任务中,如果随机划分帧,同一基地的连续帧可能同时进入训练和验证集,导致模型通过记忆背景布局获得虚高的验证分数。按基地划分验证集迫使模型学习对象本身的视觉特征,而不是记住特定基地的排列方式。这一设计体现了发布者对数据泄漏问题的考量,也让验证结果更具参考价值。
对于研究游戏场景理解的研究者来说,这种划分方式值得借鉴。
数据泄漏指训练数据中包含了与验证或测试数据高度相似甚至相同的信息,导致模型评估分数虚高、无法反映真实泛化能力。在视频或连续帧场景中,相邻帧的背景布局几乎一致,若随机划分,模型可能通过记忆背景而非学习对象特征来“通过”验证。按基地(base)划分是一种分组划分(group split)策略,确保同一基地的所有帧只出现在一个划分中。类似做法在医学影像(按患者划分)、自动驾驶(按场景/路段划分)中已被广泛采用。评估分组划分效果时,通常对比随机划分与分组划分下的验证指标差距,差距越大说明泄漏越严重。
1,900个类别:细粒度与挑战并存
1,900个类别是一个相当庞大的数字。在《部落冲突》中,不同等级的同一建筑外观差异明显,兵种和英雄也有多种形态。细粒度标注让数据集能够支持对游戏状态的精细解析,比如识别特定等级的防御建筑或特定兵种的数量。
但类别数多也带来挑战:类别分布可能高度不均衡,部分稀有类别样本极少,模型难以学好。发布者并未在描述中提供类别分布统计,这是使用者需要自行探索的部分。
长尾分布指类别样本数量极不均衡,少数头部类别占据大部分样本,大量尾部类别样本极少。在1,900个类别的分割任务中,低等级建筑、稀有兵种或特定HUD元素可能只有几十甚至几个样本。长尾分布会导致模型在尾部类别上的分割精度显著下降,常用应对策略包括:重采样(对尾部类别过采样)、损失函数加权(如focal loss)、分类器再平衡(如logit adjustment),以及将尾部类别合并为超类。使用者应先统计类别频次直方图,识别长尾程度,再决定是否采用这些策略。
付费模式与社区反响
数据集采用免费样本+付费完整版的模式。这种模式在学术数据集领域并不常见,但在细分垂直领域有其合理性——标注成本高昂,完全免费难以持续。不过,这也可能限制其在学术研究中的采用率。发布者将样本和查看器放在Hugging Face Spaces上,降低了潜在用户的评估门槛,是一个务实的做法。
潜在应用与局限
该数据集最直接的应用是训练游戏画面分割模型,进而支持游戏状态识别、自动操作辅助、直播画面分析等场景。对于《部落冲突》这类策略游戏,精确识别建筑布局和兵种位置是构建AI玩家的基础。
局限也很明显:数据集仅覆盖一款游戏,迁移到其他游戏需要重新标注;1,900个类别的长尾分布可能影响模型性能;付费获取方式可能阻碍学术复现。此外,发布者未披露标注质量评估指标(如标注一致性),使用者需要自行验证。
标注一致性是衡量标注质量的核心指标,通常用多人标注同一批图像后计算交并比(IoU)或Dice系数来评估。对于实例分割,还需考察不同标注者对同一对象边界判定的差异,尤其是遮挡、半透明特效和HUD重叠区域。若发布者未披露一致性指标,使用者可从训练集与验证集的损失差距、模型在样本上的可视化结果来间接判断标注噪声水平。标注噪声过高时,模型可能学到错误边界,此时可考虑使用标注平滑或噪声鲁棒损失函数。
结语
这个《部落冲突》分割数据集填补了手游画面理解领域的一个空白。6.9k帧、420万掩码、1.9k类别的规模,加上按基地划分验证集的严谨设计,使其成为游戏AI研究者和开发者值得关注的资源。是否付费获取,取决于具体项目对数据规模和质量的要求。对于学术研究,免费样本可以作为一个不错的起点。
相关推荐

Heretic 2.0 发布:从去审查到通用模型修改工具
Heretic 2.0 正式发布,新增任意秩消融(ARA)算法与插件系统,从去审查专用工具进化为可抑制废话、降低谄媚、调整情感对齐的通用模型修改平台。37k GitHub 星标,Hugging Face 衍生模型超 8500 个。
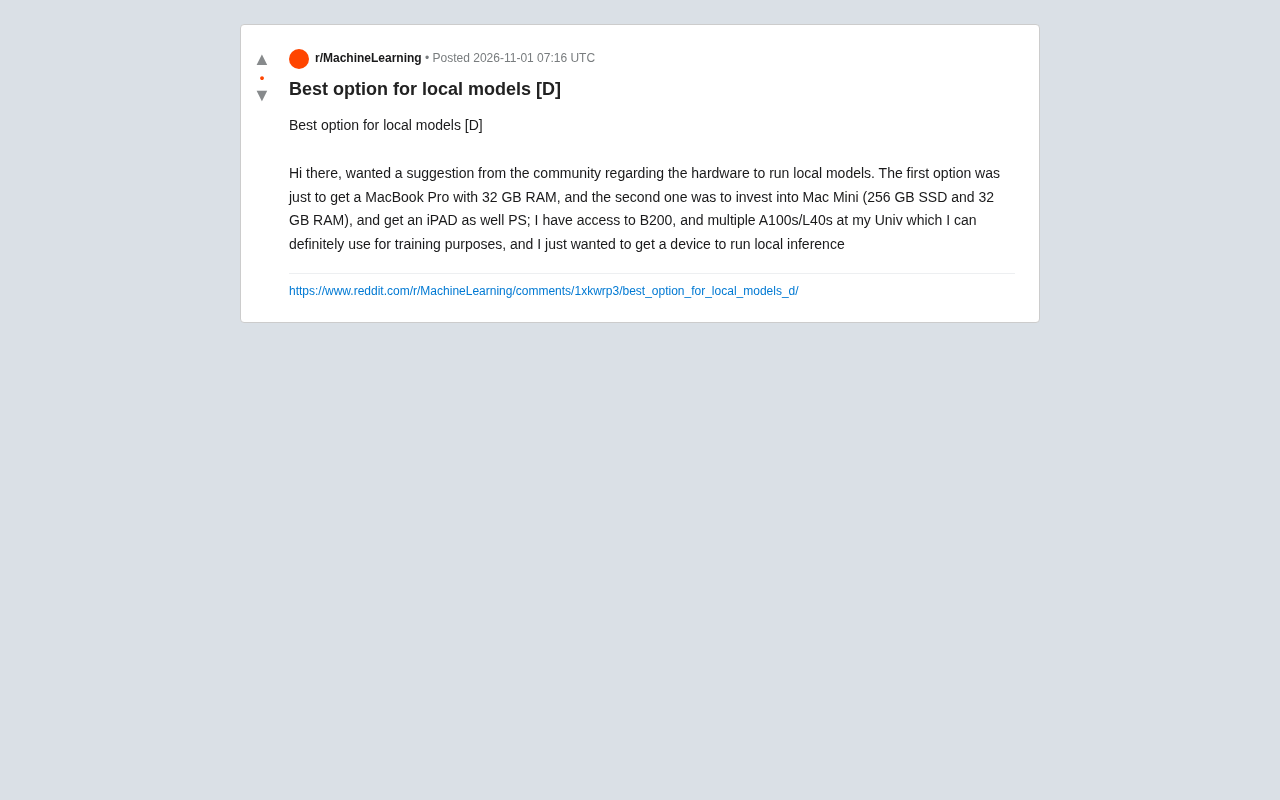
本地大模型硬件怎么选?MacBook Pro vs Mac Mini+iPad深度对比
Reddit社区热议本地大模型硬件选择:32GB MacBook Pro与Mac Mini+iPad组合如何取舍?本文从便携性、性价比、内存需求等角度深度分析,帮你找到最适合本地推理的设备方案。

AI Agent失败溯源:如何定位错误决策的根因?
Reddit讨论聚焦AI Agent失败溯源难题:如何定位导致Agent做出错误决策的根因?分析LangSmith、LangFuse等可观测性工具的局限,探讨手动分析与自建分析系统的实践组合,为Agent可靠性提升提供思路。