#游戏AI
共 42 篇相关文章

本地模型为何在Doom游戏决策中击败Jev AI API?
YouTube视频对比显示,本地模型GLiNER在Doom游戏中以12毫秒响应和8.8次/秒决策频率,大幅超越Jev AI API的2.5次/秒,得分翻倍。

《部落冲突》手游画面分割数据集:6.9k帧、1.9k类
Reddit分享的《部落冲突》手游画面实例分割数据集,含6.9k帧、约420万掩码、1.9k类别,提供YOLO seg和COCO格式,验证集按基地划分,免费样本可在线查看。

GPT-5.6 Sol 通关《Factorio》和平模式:AI游戏能力新突破
GPT-5.6 Sol 据称能通关《Factorio》和平模式,引发 Hacker News 热议。本文分析该消息的背景、技术意义及对 AI 游戏研究的启示。

AI智能体集群实战:Minecraft与Mindustry中的群体智能实验
Hacker News讨论分享在Minecraft和Mindustry中运行AI智能体集群的实验,探讨多智能体协作、通信开销与涌现行为等关键问题,为AI智能体研究提供游戏化测试床的新视角。

纯棋盘输入训练贪吃蛇AI:简化设计击败复杂特征工程
开发者用C++17和PPO训练贪吃蛇智能体,仅用固定棋盘one-hot输入,平均得分267/297,21%对局填满棋盘。实验揭示gamma比特征工程更重要,简化输入反超复杂设计,并分享失败回放与价值估计校准的实践经验。

自博弈AI为何总被廉价兵种打崩?RTS开发者亲述困境
独立开发者用纯自博弈训练RTS指挥官AI,却发现AI对历史版本胜率极高,却被人类玩家用廉价一级兵种击溃。本文分析自博弈策略坍塌的成因,探讨剥削者、多样性奖励与奖励设计等解决路径,并介绍其开放Bot Kit与AI联赛计划。
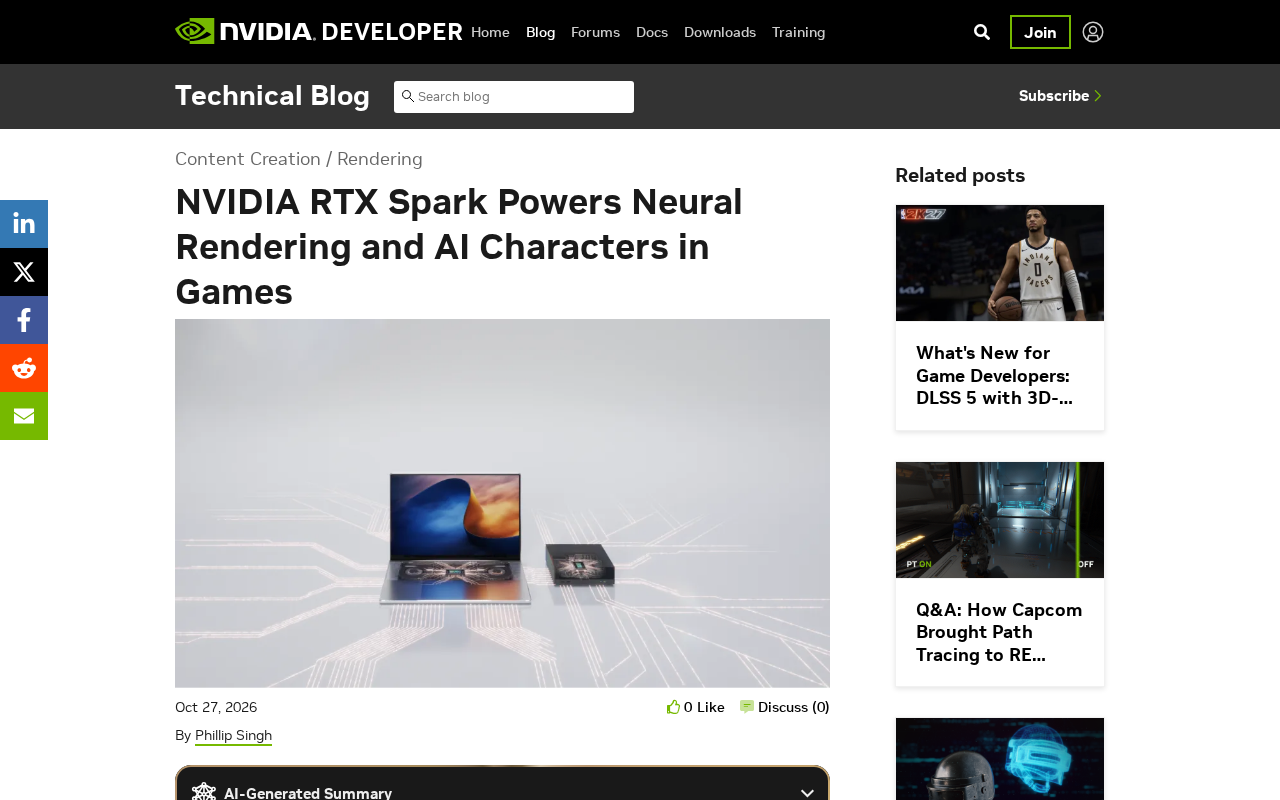
NVIDIA RTX Spark:用本地AI算力重构游戏神经渲染
NVIDIA 推出 RTX Spark Windows PC 平台,基于 Blackwell RTX 架构,面向 AI 开发、内容创作与游戏,主打神经渲染与 AI 角色在本地实时运行,覆盖轻薄笔记本与紧凑台式机形态。
AI用2.5天打造JAX环境,让《Getting Over It》智能体胜率85%
Reddit 用户借助 Opus 5.5 构建 JAX 版《Getting Over It》环境,经 2.5 天训练,智能体在真实游戏胜率达 85%,展示 LLM 驱动环境生成的潜力。
用Rust写模拟器训练PPO智能体刷暗黑2重制版深渊
Reddit网友分享用Rust无头模拟器训练PPO智能体刷暗黑2重制版深渊:单CPU约20分钟、47.5万参数,奖励按刷图速率设计,死亡扣1000分,仅限离线使用。

用DOOM游戏训练神经网络:一次硬核实验
开发者用DOOM游戏构建神经网络,将经典FPS游戏画面作为训练数据。本文分析其技术路线、数据预处理、网络结构选择及这类实验的价值与局限。

强化学习通关《抡大锤》:63%进度背后的分布式训练策略
开发者用深度强化学习挑战《抡大锤》,智能体从底部攀爬至63%进度,卡在铁砧部分。项目开源,采用分治训练和CPU训练策略,寻求社区协作突破瓶颈。

LLM Agents挑战宝可梦对战:AI智能体博弈新实验
Hacker News热议项目让LLM Agents玩宝可梦对战(Pokemon Showdown),探索大语言模型智能体在不完全信息博弈中的策略决策能力,分析AI智能体能力边界与游戏对抗实验价值。
神经进化玩超级马里奥超越人类:原理与启示
Reddit热帖展示神经进化AI在《超级马里奥》中超越人类表现。本文解析神经进化的核心机制、超越人类的原因及其对AI研究与游戏设计的启示。

开发者打造Sandtris AI对手,浏览器免费对战
开发者打造Sandtris AI对手,推出免费浏览器游戏Sandtris Duel,邀请玩家对战测试。了解这个沙盒俄罗斯方块AI项目的特点与后续计划。

腾讯IntelliScene:多智能体推理驱动游戏场景布局
腾讯游戏AI团队在B站展示IntelliScene多智能体游戏场景布局系统:1.0用LLM集群与慢思考实现叙事驱动布局,2.0引入视觉语言模型与概念艺术引导,3.0提出分层放置架构,关键物体恢复率超90%,放置速度显著优于现有方案。
混合智能体通关暗黑破坏神I:钢铁侠模式抵达第9层
混合AI智能体在暗黑破坏神I钢铁侠模式下抵达地下城第9层。项目采用算法+强化学习混合架构,包含CNN+LSTM注意力机制、装备评分公式和奖励塑形迭代,开发者分享了完整的技术实现与当前瓶颈。

开源大模型在《Among Us》投票中为何输给小网络?
开发者用开源大模型 gpt-oss:20b 替代《Among Us》模拟器中的小型投票网络,六种配置下大模型从未胜出。本文详述实验设置、八人与十五人局数据对比,分析通用大模型为何不敌领域专用小网络。
用PPO智能体让AI跑《神庙逃亡》:手机端实测最远16782米
开发者用PPO强化学习智能体玩《神庙逃亡》,通过Frida直接读取游戏内存并调用游戏方法操作,自建C++无头模拟器6分钟训练1000万步,真机14次实测中位数4736米、最远16782米,GitHub已开源。