B站AI无限竞技场:三款MOE模型本地部署极限PK

RTX 3060本地实测三款30B级MOE模型,Qwen 3.6 35B A3B在3D建模任务中一次成型表现最佳。
作者在RTX 3060本地环境下,使用LlamaCBP推理框架与IQ4量化版本,对Gemma 4、GLM 4.7 Flash、Qwen 3.6 35B A3B三款30B级MOE模型进行横向对比。测试任务为生成“雨夜便利店街角”3D场景,考察空间建模、细节把控与多轮优化稳定性。结果显示,Qwen 3.6 35B A3B首次生成即基本完成,元素齐全且红绿灯可自动切换,综合最佳;GLM 4.7 Flash首版细节较多但二次优化出现语法错误与变量未声明bug,稳定性不足;Gemma 4生成速度快但优化几乎无效、细节缺失,排名垫底。作者还尝试了更大参数的Qwen 3.8 Flash Next,质量显著提升但需借助内存与SSD,不参与评比。
在B站,AI无限竞技场正成为评测大模型能力的热门方式。众多UP主用复杂场景题目让模型同台竞技,而线上测评往往成本高昂。为了降低成本并探索本地部署的可行性,我使用自己的设备进行了一次针对三款MOE模型的横向对比。测试不仅关注生成速度,更聚焦于模型在复杂3D建模任务中的表现与稳定性。
测试环境与模型选择
本地部署的核心硬件是一张RTX 3060显卡(显存容量为素材中未明确给出的具体数值)和双通道内存(总容量素材未提供)。显卡运行在PCIe 4.0 x16通道上,为模型推理提供基础算力。推理框架选用截止当前最新版本的LlamaCBP,所有模型均采用Anslot提供的IQ4量化版本,以平衡显存占用与推理速度。
参与PK的三款模型均为30B参数级别的MOE架构,但激活参数各不相同:
- Gemma 4:总参数26B,每次激活4B
- GLM 4.7 Flash:总参数30B,每次激活3B
- Qwen 3.6 35B A3B:总参数35B,每次激活3B
由于本地设备限制,上下文长度上限为128K,模型推理速度大约在每秒20-30个token之间。为避免单次输出过长导致上下文溢出,所有模型均通过在线方式引用JS库,并要求将JS代码单独编写。Agent框架统一使用最新版本的DeepSeek广告 Hanis,确保测试条件一致。
MOE(混合专家)架构是目前大模型领域的重要设计范式。与传统稠密模型每次推理都激活全部参数不同,MOE模型包含多个“专家”子网络,并通过一个门控网络(Router)为每个token动态选择激活少数几个专家。因此MOE模型可以拥有很大的总参数量,但单次推理只计算其中一小部分,从而在保持较高能力的同时大幅降低算力与显存带宽需求。文中三款模型的总参数在26B到35B之间,而激活参数仅3B到4B,正是这一特性的体现。需要注意的是,总参数量仍决定模型加载时占用的显存,激活参数则主要影响推理速度,二者需要区分看待。
量化是指用更低比特的数据类型(如4位、8位整数)来表示模型权重,以减少显存占用和内存带宽压力,从而让大模型能够在消费级显卡上运行。文中提到的IQ4属于4比特量化的一种,通常配合特定的量化算法(如llama.cpp生态中的重要性矩阵量化)来尽量保留模型精度。量化会带来一定的质量损失,但4比特量化在多数任务上仍能保持较好表现,是本地部署的常见折中方案。与之相关的还有上下文长度,即模型单次能够处理的最大token数量,文中128K的上限意味着模型可以容纳较长的对话与代码,但超出后需要截断或分段处理。
建模任务设计:雨夜便利店街角
本次测试的题目是生成一个“雨夜便利店街角”的3D场景,要求以完整的正方形底座为基础,所有元素搭建在底座上,构图紧凑、层次清晰,呈现小巧精致的可收藏模型感。具体元素包括:位于视觉中心的日式便利店,外部有招牌、橱窗、自动门、屋檐雨棚,以及贩卖机、自行车、路灯等街角道具。场景中不需要人物,店内的货架等信息可以简化处理——本地模型在内部细节上的表现普遍较弱。
这一任务对空间建模能力和细节把控要求极高,能够直观反映模型对复杂指令的理解与执行水平。
Agent框架在这里扮演的是“调度层”角色:大模型本身只负责生成文本或代码,而Agent框架负责组织提示词、调用工具(如执行代码、读写文件)、维护多轮对话状态,并在模型输出出错时进行重试或修复。文中统一使用同一款Agent框架,是为了排除框架差异对结果的干扰,使对比更聚焦于模型本身的能力。此外,文中要求“通过在线方式引用JS库”并将JS代码单独编写,是为了避免模型把大量库代码直接内联进输出,从而节省上下文并降低语法出错概率,这也是本地部署时控制输出长度的常用技巧。
三款模型实战表现
Gemma 4:快速生成,优化乏力
Gemma 4首次生成仅用时9分7秒,速度令人印象深刻。初始版本中,便利店主体结构完整,自动门、贩卖机、路灯等元素均有呈现。但自动门存在明显问题,路灯单独放置,整体细节不足。
随后进行二次优化,耗时约4分钟,结果却令人失望:新增的红绿灯并未安装在路灯杆上,门头优化几乎无效,多次细节调整后仍无明显改善。这表明Gemma 4在该任务上的上限较低,优化能力有限。
GLM 4.7 Flash:细节丰富但稳定性堪忧
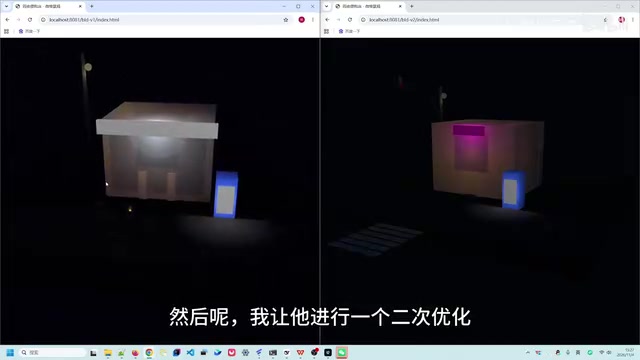
GLM 4.7 Flash首次生成同样在10分钟左右完成,初始版本细节比Gemma 4更丰富,电线杆和连接线等元素均有体现。然而,在二次优化时耗时17分钟,却引入了基础语法错误——括号未正确闭合。随后修复该问题又花费30分钟,期间还出现变量未声明的bug。
从最终效果看,第一版虽然内部结构混乱、自动门被墙体堵住,但至少能辨认出便利店轮廓;第二版优化后反而更差,模型整体缩小,自动门变成木门,细节大量丢失。GLM 4.7 Flash的稳定性问题突出,优化过程充满不确定性。
Qwen 3.6 35B A3B:一次成型,细节到位
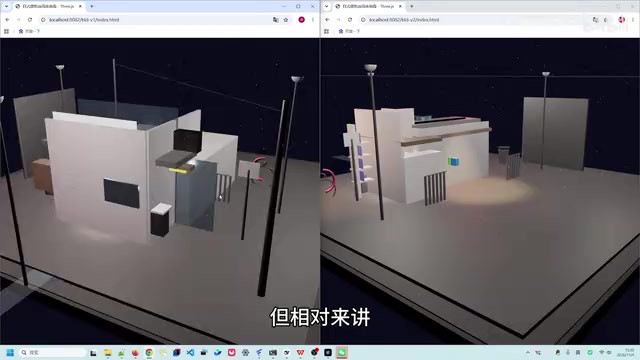
Qwen 3.6 35B A3B的表现截然不同:首次生成即基本完成,无需二次优化。场景中便利店周围环境完善,空调机、红绿灯(能够自动切换红黄绿)、垃圾桶、路灯、贩卖机、道路等元素一应俱全。自行车虽然仍有瑕疵,但相比前两者明显更好。星空背景增添氛围,唯一欠缺的是雨夜的下雨感。
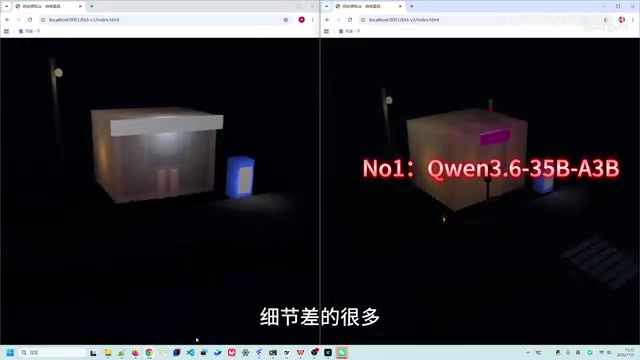
整体而言,Qwen 3.6 35B A3B在三个模型中表现最强,一次成型且细节丰富,稳定性远超对手。
**“一次成型”与“二次优化”**的差异,本质上反映的是模型在长程代码生成中的自洽性与纠错能力。3D场景代码往往包含大量嵌套结构(如场景树、几何体、材质、动画),任何一处括号或变量名错误都可能导致整个场景无法渲染。模型在二次优化时需要在已有代码上做局部修改,这比从零生成更容易引入回归错误——GLM 4.7 Flash出现的括号未闭合与变量未声明即属此类。因此,评估这类任务时,首次生成的成功率和多轮修改后的稳定性,往往比单次生成速度更能说明模型的工程可用性。
排名与意外发现
综合表现排序:Qwen 3.6 35B A3B第一,GLM 4.7 Flash第二,Gemma 4垫底。尽管GLM 4.7 Flash出现bug,但其第一版细节仍优于Gemma 4,因此位列第二。Gemma 4因优化乏力、细节缺失排名最后。
测试之外,我还尝试了Qwen 3.8 Flash Next——一个参数量更大的模型,本地部署需借助大量内存和SSD,但仍在同一硬件上运行。其生成质感遥遥领先:电线杆仿真度高,便利店名称清晰,玻璃门可透视内部货架,自行车细节到位,整体远超前三个模型。虽然不参与评比,但四倍参数带来的质量提升显而易见,为本地部署提供了新的参考。
本次测试表明,MOE模型在本地部署下已能完成复杂建模任务,但模型间的稳定性、细节处理和优化能力差异显著。Qwen 3.6 35B A3B展现了最佳平衡,而更大参数的模型则揭示了硬件升级的潜力。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。