参差前沿之辩:数学与代码狂飙,AI其他能力会触顶吗?

RLVR可无限推高数学与代码能力,但写作等软性能力是否会因数据瓶颈触及天花板,仍是大模型竞赛的核心悬案。
大模型的能力版图呈现"参差前沿"特征:数学和代码因答案可被机器自动验证,可借助RLVR(基于可验证奖励的强化学习)以几乎零边际成本持续迭代,能力曲线近乎垂直上升;而写作、价值判断、开放式推理等"不可验证"领域,奖励信号难以自动化,进步缓慢且高度依赖人类标注数据。核心争议在于:非可验证能力的现有改善,究竟源于强推理训练产生的"通用智能溢出",还是仅仅来自持续注入的大规模人类数据?若是前者,RLVR可撬动全面能力增长;若是后者,软性能力将随数据增量放缓而停滞,"偏科"差距反而扩大,高质量独家数据将成为决定性战略资产。
一个值得深思的提问
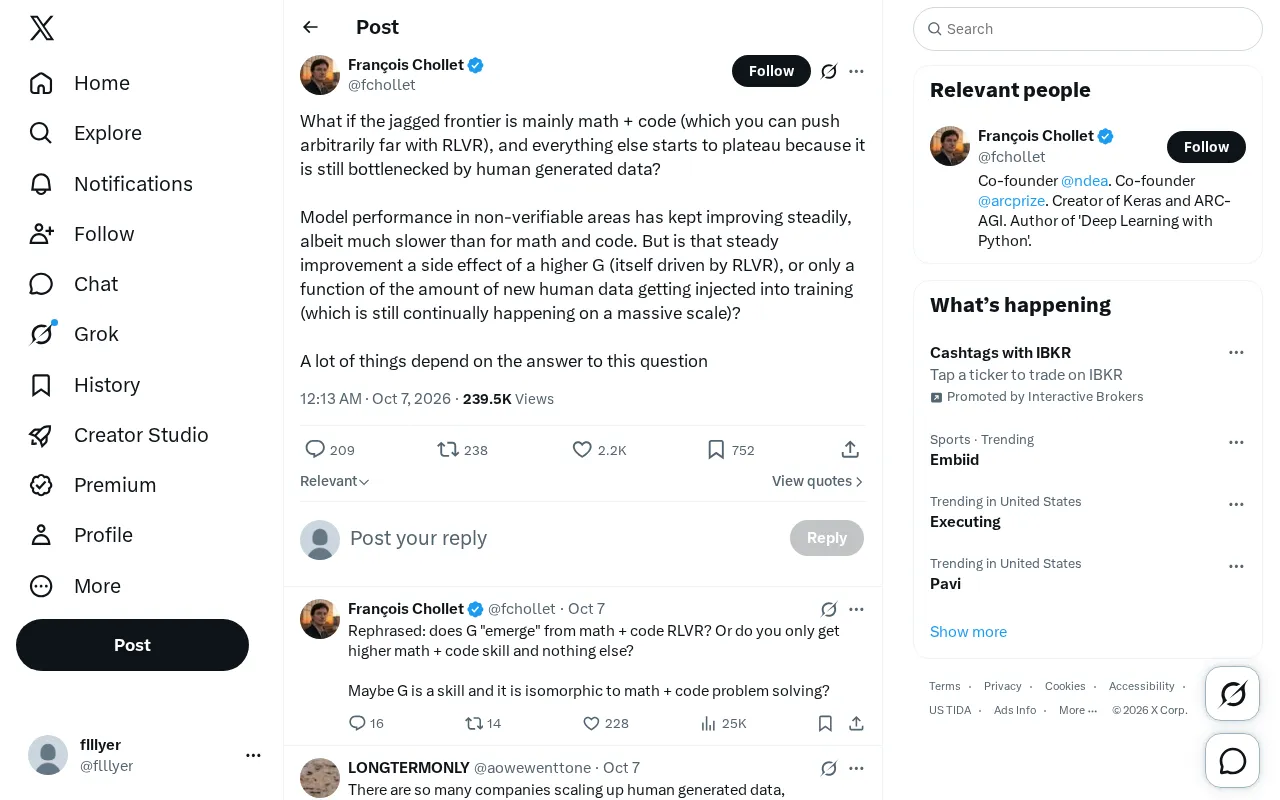
大模型能力的发展呈现出明显的"参差前沿"(jagged frontier)特征——在某些任务上接近甚至超越人类专家,而在另一些任务上却表现平庸。一条来自推特的讨论,把这种不均衡现象推向了一个更尖锐的追问:如果所谓的参差前沿,本质上主要体现在数学和代码领域,而这些领域恰恰可以借助 RLVR(基于可验证奖励的强化学习)被无限推高,那么其他能力是否会因为仍然受制于人类生成的数据而逐渐触及天花板?
这个问题看似抽象,却直指当前大模型训练范式的核心矛盾。
为什么数学和代码能"无限推高"
RLVR 的全称是 Reinforcement Learning with Verifiable Rewards,核心在于"可验证"三个字。数学题有标准答案,代码能否运行、能否通过测试用例,都可以被机器自动判定。这意味着模型可以在没有人类逐条标注的情况下,通过海量的自我尝试与反馈循环不断迭代。
换句话说,在这些领域里,奖励信号是客观、可规模化、几乎零成本生成的。只要算力足够,模型就能持续地"自己跟自己较劲",把能力推向越来越高的水平。这也是为什么近期众多前沿模型在数学竞赛、编程基准测试上的进步速度令人瞠目。
RLVR 的实践先驱之一是 DeepSeek广告-R1 及 OpenAI 的 o1/o3 系列模型。这些模型在训练时让模型反复生成解题步骤,再由自动化评判器检验最终答案是否正确,从而产生稠密的奖励信号。这一范式本质上是 AlphaGo 思路的语言版迁移:围棋的胜负可机器裁判,数学题的答案同理。与传统的基于人类反馈的强化学习(RLHF)相比,RLVR 不依赖人工打分员,边际成本极低,可以以远超 RLHF 的规模运行。正因如此,模型在竞赛数学(如 AIME、IMO 题目)和代码生成(如 Codeforces 竞赛题)上的得分在过去一年间出现了近乎垂直的增长曲线。
不可验证领域的隐忧
问题的另一面在于那些不可验证的能力——写作质量、常识推理、价值判断、情感表达、复杂的多轮对话等等。这些任务没有唯一的标准答案,奖励信号难以自动化生成,很大程度上仍然依赖人类标注与人类产出的文本数据。
原文作者敏锐地指出:模型在这些非可验证领域的表现确实一直在稳步提升,只是速度远慢于数学和代码。但真正的关键问题是——这种稳步提升究竟来自哪里?
作者提出了两种可能的解释:
解释一:通用能力的溢出效应
一种可能是,RLVR 在数学和代码上训练出的更强"通用智能"(文中用 G 表示),会自然外溢到其他领域。也就是说,让模型学会严密的逻辑推理、学会分步拆解复杂问题,这种底层能力的提升会迁移到写作、对话等软性任务上。如果是这样,那么只要继续推高数学和代码,整个模型的全面能力都会水涨船高。
这一假说在认知科学中有对应的概念——"迁移学习"(transfer learning)或"领域无关推理能力"。其背后的直觉是:严格的数学训练能强化模型在隐空间中执行分步推演、检测自身矛盾的底层电路,这些电路在处理其他任务时同样会被激活。部分研究者将这类底层能力类比为 Spearman 的"g 因子"(一般智力因子)——即跨领域通用的认知基础。支持这一假说的间接证据是:o1/o3 等以推理为核心训练目标的模型,在医学诊断、法律分析等非数学领域也呈现出明显的能力跃升,尽管这些领域并非其强化学习的直接训练对象。不过,"溢出到什么程度"仍是未解之谜。
解释二:人类数据的持续注入
另一种可能则悲观得多:非可验证领域的进步,仅仅是因为训练中不断注入了大规模的新人类数据。进步并非来自智能本身的跃升,而是数据量累积的结果。如果真是如此,一旦高质量人类数据的增量放缓或枯竭,这些领域的能力就可能真正触及天花板。
衡量非可验证能力的困难本身就是一个深层问题。写作质量、情感共鸣、价值判断等任务缺乏"地面真相"(ground truth),当前主流的评估方式——无论是 MT-Bench、AlpacaEval,还是让另一个大模型充当裁判(LLM-as-Judge)——都存在循环依赖和评分偏差的风险。这意味着即便我们观察到"非可验证能力在稳步提升",也很难排除这只是评估体系自身的偏移所致,而非模型能力的真实跃升。如何为开放性任务构建可信的评估基准,本身就是当前 AI 评估领域最棘手的挑战之一。
为什么这个问题如此重要
正如作者所言,"很多事情都取决于这个问题的答案"。这不是一个纯学术的思辨。
如果是解释一成立,那么 AI 的发展路径将相对乐观——通过可验证领域的强化学习,就能撬动整体能力的持续增长,数据瓶颈的影响被大大削弱。实验室可以把资源集中投向 RLVR 这类可扩展的训练方法。
如果是解释二成立,那么我们将面临一个更为复杂的局面:数学和代码会继续一骑绝尘,而创意写作、人文判断、开放式推理等能力可能逐渐陷入停滞。模型会变得越来越"偏科",参差前沿的差距不是在缩小,而是在扩大。这也意味着高质量人类数据的价值将变得空前重要,谁掌握了独特的数据来源,谁就掌握了突破瓶颈的钥匙。
现实可能介于两者之间
当前的证据尚不足以给出定论。非可验证能力的持续改善是客观事实,但其驱动因素极难拆解——通用能力提升与数据注入很可能是同时发生、相互交织的。
这场讨论的价值,不在于立刻给出答案,而在于提醒整个行业:不要被数学和代码的亮眼成绩所迷惑,误以为所有能力都能以同样的速度被推进。 判断哪些能力可以靠算法自我扩展、哪些仍然被数据牢牢锁死,将决定下一阶段大模型竞赛的真正走向。
对于关注 AI 前沿的从业者和观察者而言,这个"参差前沿到底卡在哪里"的问题,值得持续追踪与验证。
相关推荐

亚马逊新款Alexa平板来袭:超值价格背后的广告隐忧
亚马逊新款Alexa平板以229至549美元的超值价格冲击安卓平板市场,有望成为默认选择。但低价背后是广告补贴与购物推送的隐忧,本文分析其机遇与潜在陷阱。

ChatGPT移动端上线DOT:随身AI代理如何帮你搞定工作
OpenAI的ChatGPT移动端正式上线DOT主动式AI代理,支持iOS和Android。本文详解DOT的设置流程、个性化配置,以及它如何自主编码、跨Slack协作完成复杂任务。

Claude Code v2.1.296 更新解析:子代理、权限与跨平台修复
Claude Code v2.1.296 版本更新详解:新增子代理 autoCompactWindow 与工作流模型控制,加固 Bash 权限与密钥脱敏,优化 Windows 兼容性,并下调 Sonnet 5.5 缓存读取价格。