CARAT揭秘:材料科学大模型是在推理还是背诵?

CARAT基准揭示材料LLM的高准确率往往源于照抄输入而非真正推理,并提供了一套可自我证伪的评测方法论。
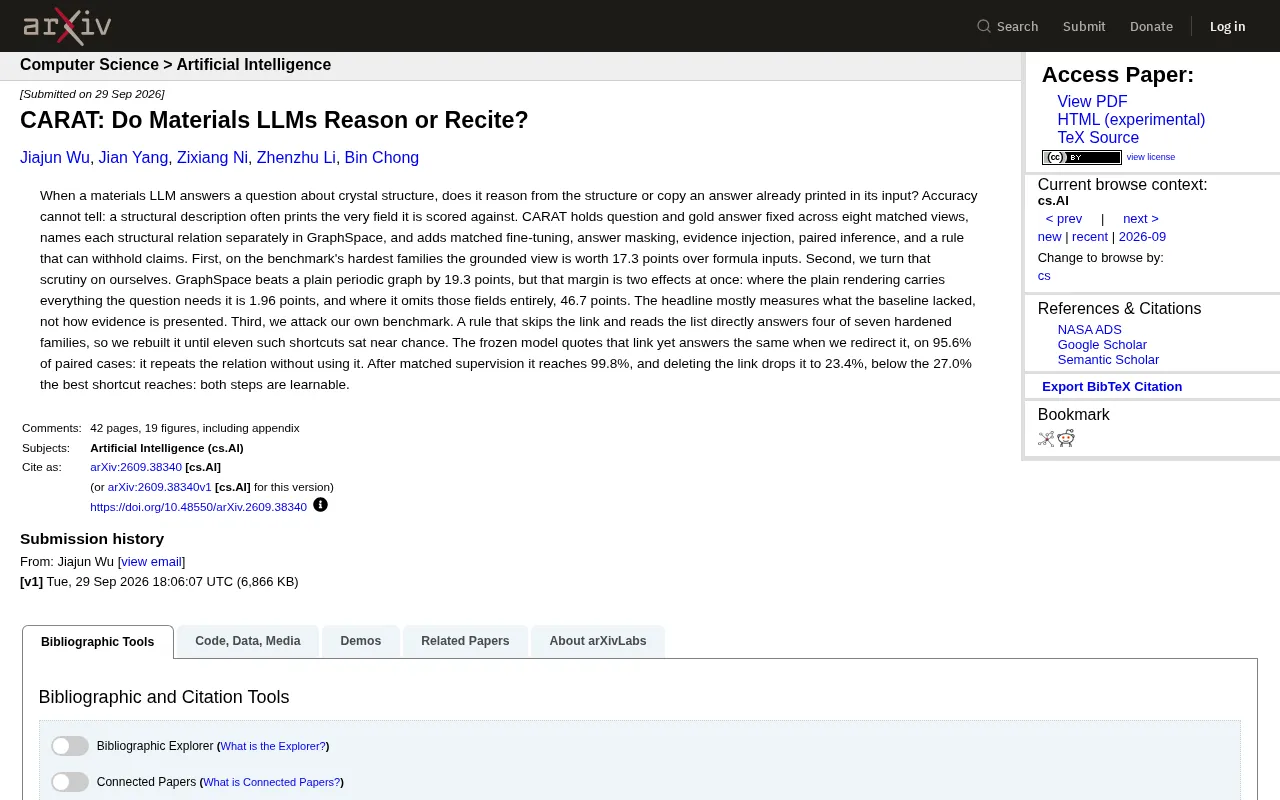
arXiv论文《CARAT》针对材料科学大语言模型提出了一个根本性问题:模型的高准确率究竟来自真实推理还是对输入信息的简单复述?研究者通过固定问答、构建八种结构化视图、引入答案遮蔽与证据注入等机制,系统分离了"背诵"与"推理"两种行为。关键发现包括:GraphSpace相比普通周期图的19.3分领先,主要源于基线信息缺失而非表示方式更优;被冻结的模型在95.6%的配对案例中对被重定向的链接视而不见,说明它只是在复述关系而非使用它;经过匹配监督训练后正确率达99.8%,删除链接则跌至23.4%,证明推理能力确实可以被学习。这一范式对整个AI能力评测领域具有普遍警示意义。
一个被准确率掩盖的问题
当一个材料科学大语言模型(LLM)回答关于晶体结构的问题时,它究竟是从结构本身进行推理,还是直接照抄输入中已经印出来的答案?这是arXiv最新论文《CARAT: Do Materials LLMs Reason or Recite?》提出的核心拷问。
问题的棘手之处在于:传统的准确率指标根本无法区分这两种情况。一段结构描述文本往往会直接"印出"它正被评分的那个字段——模型只要把答案复制粘贴出来,就能拿到高分,哪怕它对晶体结构背后的物理关系一无所知。这就是所谓的"推理 vs 背诵"难题。
CARAT如何设计一场"公平审讯"
CARAT的方法论核心是"控制变量"。它固定住问题和标准答案,然后在八个经过匹配的"视图"之间进行对比,用名为GraphSpace的结构化空间分别命名每一种结构关系。
为了把背诵和推理彻底剥离开,研究者引入了一整套组合拳:匹配的微调(matched fine-tuning)、答案遮蔽(answer masking)、证据注入(evidence injection)、配对推理(paired inference),以及一条允许模型"拒绝作答"的规则。这些机制共同构成了一个能够逼问模型"你到底用没用到证据"的实验框架。
接地视图的价值
在基准测试中最难的那几类题目上,经过"接地"(grounded)处理的视图比单纯喂公式输入高出17.3分。这说明当证据以结构化方式真正呈现时,模型的表现确实能被显著拉升——前提是它真的在用这些证据。
GraphSpace是CARAT引入的核心表示框架,它将晶体结构中的原子位置、键合关系、对称性等信息以结构化图的形式组织,而非直接输出原始CIF文件或文字描述。这与"普通周期图"(plain periodic graph)的区别在于:后者仅保留原始几何与拓扑信息,而GraphSpace通过命名不同的结构关系视图(view),使模型推理所需的"证据链"更加清晰可定位。八个"视图"分别对应不同的结构描述粒度——例如局部配位环境、对称操作、层间距等——每个视图都能被独立注入或遮蔽,从而让研究者精确控制模型能"看到"哪些信息。答案遮蔽(answer masking)则是指在输入文本中将目标字段替换为占位符,防止模型直接抄写;证据注入(evidence injection)是反向操作,主动插入与答案相关的结构依据,测试模型能否真正利用这些依据得出正确结论。这套组合机制的设计逻辑,类似于受控实验中的单因素变量控制。
把审视的目光对准自己
论文最具价值的地方,是研究者对自身方法的严苛反思。GraphSpace相比普通周期图(plain periodic graph)高出19.3分,听起来是个漂亮的成绩,但作者拆解发现这个差距其实是两个效应的叠加:
- 当普通渲染已经包含了问题所需的全部信息时,GraphSpace只领先 1.96分;
- 当普通渲染完全遗漏了这些字段时,领先幅度飙升到 46.7分。
换句话说,那个醒目的19.3分差距,大部分衡量的是"基线缺了什么",而不是"证据如何被更好地呈现"。这是一个非常诚实的自我纠偏,提醒整个领域警惕被表面数字误导。
攻击自己的基准
研究者进一步做了一件反直觉的事——主动攻击自己设计的基准。他们发现,一条"跳过关系链接、直接读列表"的捷径规则,竟然能答对七个强化题族中的四个。于是他们不断重建基准,直到有十一条这样的捷径都被压到接近随机猜测的水平。
真正令人警醒的发现出现在配对实验中:被冻结的模型会引用那条关系链接,但当研究者把链接重定向到别处时,它在95.6%的配对案例中给出了相同的答案。这意味着模型只是在"复述"关系,却根本没有"使用"它。
推理能力是可以学的
好消息是,经过匹配监督训练后,模型的表现提升到了99.8%;而一旦删除那条链接,正确率骤降到23.4%——甚至低于最佳捷径能达到的27.0%。两步都是"可学习的":模型既能学会真正依赖证据,也能在证据缺失时表现出应有的脆弱。这恰恰证明了它开始"推理"而非"背诵"。
匹配监督训练(matched fine-tuning)是指用与测试视图完全对应的训练样本进行微调,确保训练集和测试集在信息结构上保持一致,从而排除分布偏移对结果的干扰。这与通常的微调不同——通常做法中训练数据可能来自不同渲染方式或不同字段组合,导致模型在测试时实际上是在迁移一个略有偏差的分布,而非真正学习目标任务的推理链。配对实验(paired inference)则是指对同一个问题构造两个版本的输入:一个包含真实关系链接,另一个将链接重定向到无关位置,然后比较模型在两种输入下的答案是否发生变化。如果模型真正依赖证据推理,答案应该随链接变化而变化;如果答案几乎不变,则说明模型只是在复述一个已记忆的模式。95.6%的不变率正是通过这种配对对比得出的,是衡量"推理深度"而非仅仅"准确率"的关键指标。
对AI评测的启示
CARAT的意义远超材料科学本身。它揭示了一个普遍存在的评测陷阱:高准确率可能只是信息泄漏的产物,而非真正的推理能力。任何领域的LLM评测,只要输入文本中夹带了答案字段,都可能面临同样的"背诵假象"。
这项工作给出的范式——固定问答、控制视图、注入与遮蔽证据、以及敢于攻击自己的基准——为构建更可信的AI能力评估提供了一套可借鉴的工具箱。在大模型能力评测日益重要的今天,这种"自我证伪"的科研态度尤为珍贵。
信息泄漏(data leakage)在LLM评测中是一个系统性风险,尤其在结构化科学数据领域更为突出。晶体结构的标准表示格式(如CIF文件)通常会在同一文本块中同时包含多个属性字段,例如空间群、晶格参数、原子坐标等。当评测任务要求模型"预测"其中某一字段时,若输入中恰好也包含该字段(或可直接推导出该字段的等价信息),模型实际上只需执行字符串匹配而非物理推理。这一问题在蛋白质结构预测、化学性质预测等领域同样存在,并且随着LLM预训练语料覆盖范围扩大而愈发难以排查——模型可能在预训练阶段就已"见过"某条数据的完整字段,导致测试集污染(test set contamination)。CARAT的方法提示:设计可信评测不仅需要把答案从输入中移除,还需要主动验证模型是否真正依赖剩余信息,而非从参数记忆中检索答案。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
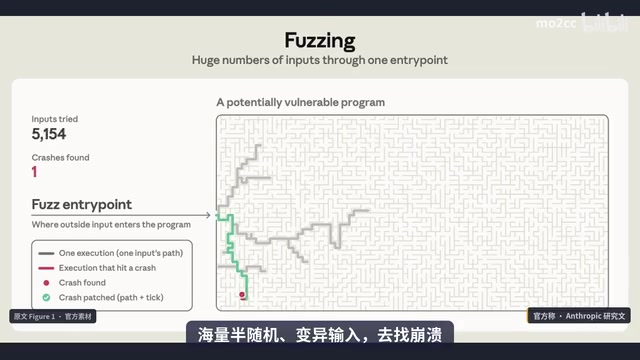
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
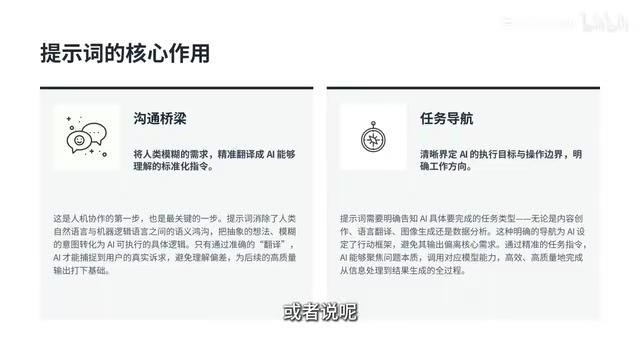
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。