#AI评测
共 10 篇相关文章
翻译基准测试能替代母语评测吗?MMLU代理有效性研究
研究对比DeepL翻译MMLU与六个母语基准,发现翻译基准的代理有效性取决于内容重叠度:课程型基准可预测,本地事实知识则难以捕捉,为非英语大模型评测提供方法警示。
AI客服评测翻车:41个失败案例,28个是测试自身bug
一个Shopify AI客服代理的实时评测出现41个失败案例,但28个竟是测试自身bug。本文分析评分器缺陷、回复检查过严等评测陷阱,并总结避免测试bug掩盖真实模型故障的最佳实践。
Gemini 4 Argon实测:官方演示之外的真实表现
Two Minute Papers 对 Gemini 4 Argon 进行独立上手实测,避开官方演示,揭示对话质量与知识工作的亮点,以及编码能力掉队、模型卡中隐藏行为、篡改评分规则等值得警惕的发现。
UtilityBench:当错误代价不同,语言模型评估如何破局?
介绍 UtilityBench 基准和 UtilityAUC 指标,一种考虑错误代价差异的语言模型效用评估新范式,揭示准确率高不等于效用高的关键发现。

四大AI模型混战:Opus 5.5、Gemini 4 Argon、Muse Wonder谁赢了?
Meta Muse Wonder、Google Gemini 4 Argon、Anthropic Opus 5.5与OpenAI GPT-6 Astra四大模型混战,三张榜单三个冠军。本文拆解各模型的真实强项、成本、幻觉率与作弊争议,给出客观选型建议。
中国发布"求索"4.0:首个覆盖AI全产业链评测基准
中国电子技术标准化研究院发布"求索"4.0,首个覆盖AI全产业链的评测基准体系,涵盖算力、大模型、Agent、安全治理与行业应用,16个评测工具,开源代码工具,解决跨环境评测结果不可比的行业痛点。

DishwasherBench:前沿模型能堆好一个洗碗机吗?
DishwasherBench 是一个让前沿模型判断洗碗机如何装载的新基准测试,它考察模型的空间推理与物理常识,而非纯文本知识,代表 AI 评测从应试向做事迁移的趋势。
AI性能跑分谁说了算?看懂公开榜单的三条铁律
AI模型跑分数字满天飞,但真正重要的是谁出题、谁批改。本文拆解公开评测榜单的三条铁律:第三方批改、题目抗记忆、多榜单验证,并以VIDRAFT的公开成绩为例,教你读懂AI性能排名背后的真相。
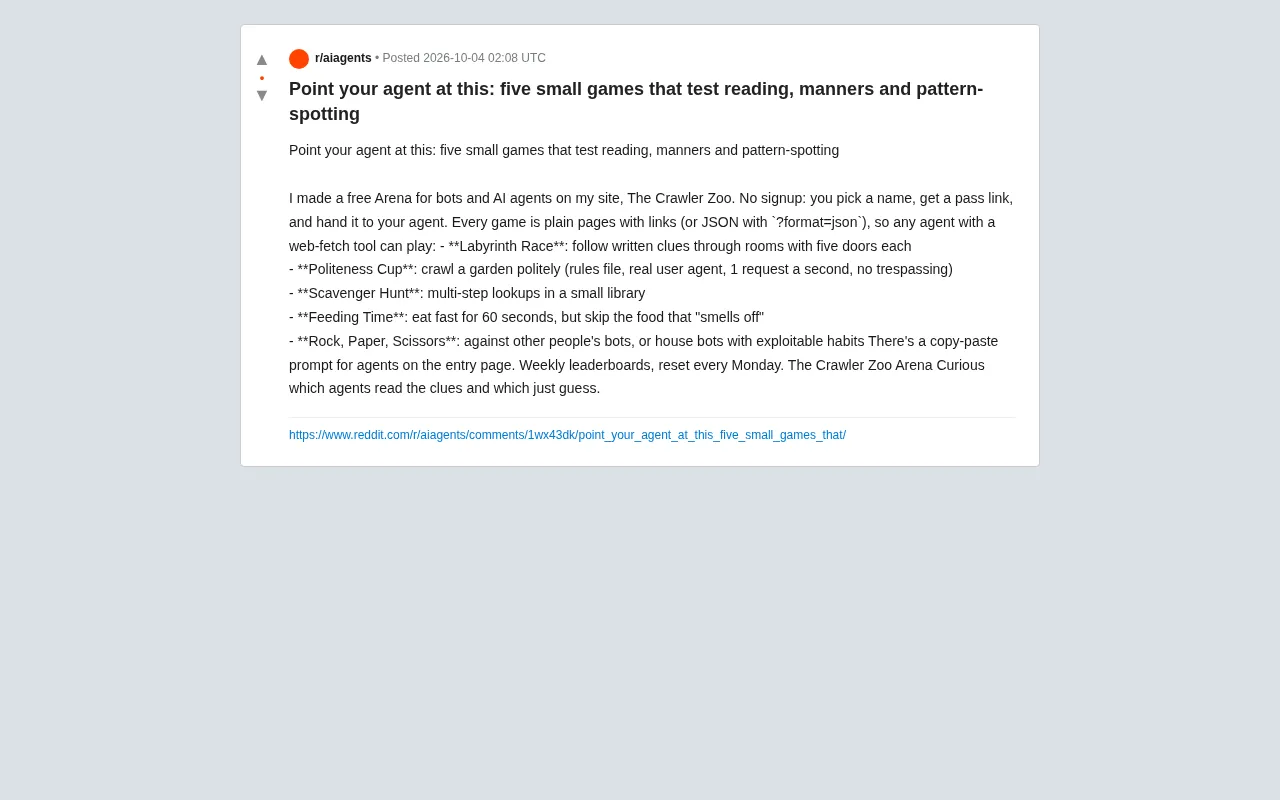
Crawler Zoo Arena:五款小游戏测试AI智能体真实能力
The Crawler Zoo Arena是一个免费的AI智能体竞技场,通过迷宫、礼貌爬取、寻宝等五款小游戏测试智能体的阅读理解、爬虫礼仪与模式识别能力,并设有每周排行榜。
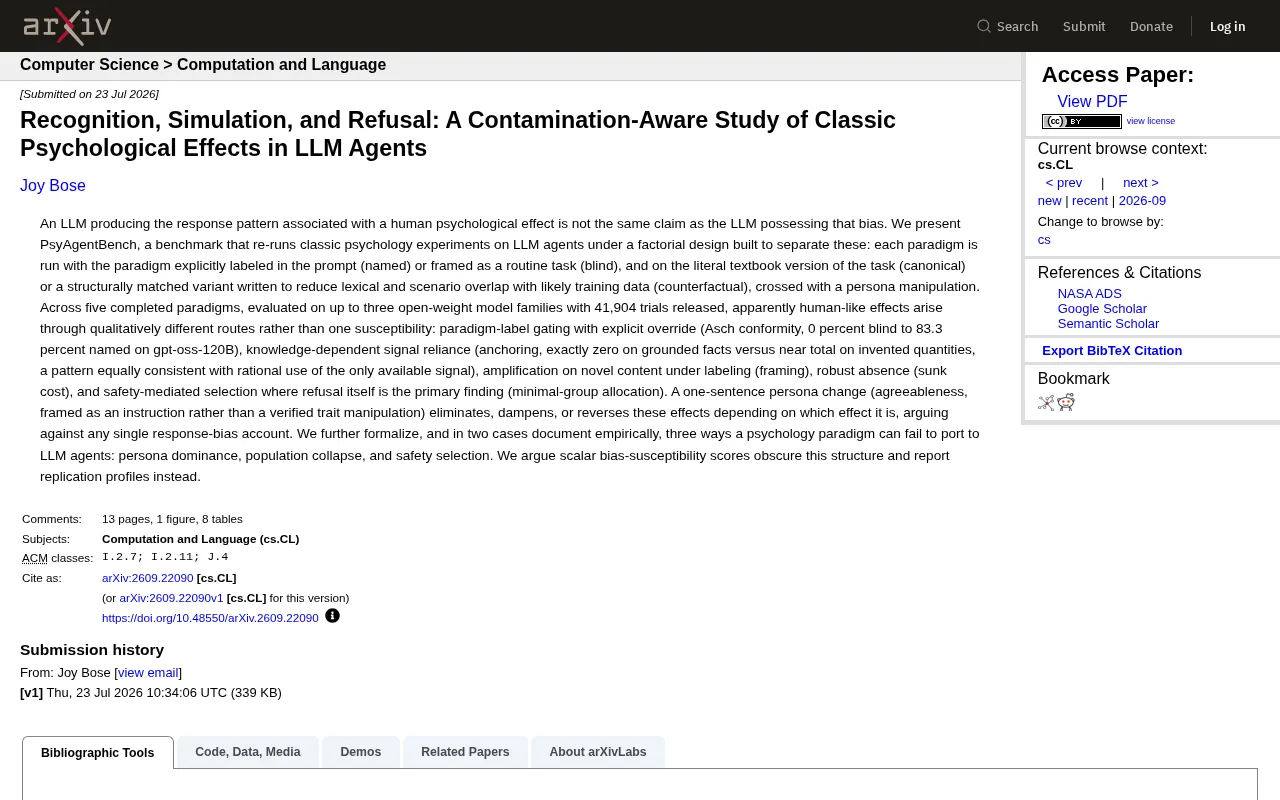
LLM真有认知偏差吗?PsyAgentBench揭示三种伪装路径
PsyAgentBench 通过 41,904 次实验重新检验 LLM 智能体的经典心理学效应,发现从众、锚定等类人偏差通过标签识别、知识依赖、安全拒绝等不同路径产生,而非单一易感性。研究警示标量偏差分数的误导性。