测试报告三分钟搞定?Lemon Test Report Skill实测:不造假、可审计
Lemon Test Report Skill将测试数据整理、结论判定与证据核验流程化,强调可审计与防造假。
Lemon Test Report Skill是一款AI辅助测试报告工具,定位为从测试数据到可审计报告的整理与校验流程,而非简单文本生成器。它一次输入可输出文字底稿、网页汇报报告、机器核验数据包三份产物,并自动排版分类。其核心能力包括:数据不足时标记“待确认”而非编造,结论分可上线、带风险上线、禁止上线、待确认四类且须有证据支撑,支持测试总结、回归核验、发布验收三种模式,并能对手工数据与重算结果冲突进行标记打假。工具明确边界:不能执行自动化测试、不能发现真实bug、不能代替发布决策。其价值在于将测试人从报告整理中解放,专注于质量分析。
测试执行结束,折磨才刚刚开始——手工统计通过率、核对bug数量、分析严重程度、排版成老板能看懂的PPT。每天加班花大量时间整理报告,根本没空做真正的质量分析。最怕数据统计错位,顺手填了个98%,一核对实际才90%。据B站UP主分享,一款名为Lemon Test Report Skill的AI工具正在测试圈流传,主打「从测试数据到可审计报告的整理与校验流程」,而不是简单的文本生成器。
它到底是什么:不是文本生成器,是校验流程
很多人对AI写报告的印象是「输入数据,输出漂亮话」。Lemon Test Report Skill的定位不同:它把测试数据整理、结论判定、证据核验串成一条流程,强调可审计、可追溯。
据UP主介绍,它的核心价值在于「数据未进去,三份报告吐出来」:把用例结果、bug清单表格、测试计划丢给它,直接输出测试三件套——可编辑的文字底稿(方便发飞书改字)、精美的网页版汇报报告(直接拿去评审展示)、机器核验数据包(防伪留痕、系统存档)。排版分类全自动搞定。
这意味着测试人从「表哥表姐」的角色中解放出来,把精力放回质量分析本身。
可审计在测试领域指报告中的每个结论都能追溯到原始数据、规则或证据,且过程可复核。传统AI报告常是黑箱生成,结论无法验证。Lemon Test Report Skill强调“机器核验数据包”和“防伪留痕”,意味着它把数据来源、计算逻辑、判定规则都固定下来,任何结论都能反查依据。这类似于财务审计中的“留痕”要求,目的是防止人为篡改或AI幻觉,确保报告在评审、合规场景下经得起质疑。
三大能力拆解:防造假、四态判断、防呆防错
数据不足时,它敢说「待确认」
这是这个skill最被强调的良心设计。很多AI为了讨好用户,报告写得漂漂亮亮,但缺少证据也照编不误。Lemon Test Report Skill如果缺少通过率等关键证据,不会帮你造假数据,而是把结论标记为「待确认」或「数据缺失」。
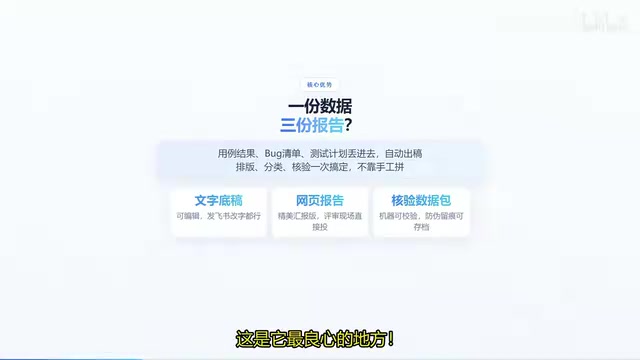
实测案例中,丢给它34条bug清单,它直接判定结论为「待确认」,并指出缺少通过率证据、高风险缺陷未关闭,绝不强行报喜。
四种结论,把「为什么不能上线」写清楚
它的结论分为四种:可上线、带风险上线、禁止上线、待确认。所有发布标准必须有证据支撑,比如设置通过率低于95%就提示禁止上线。
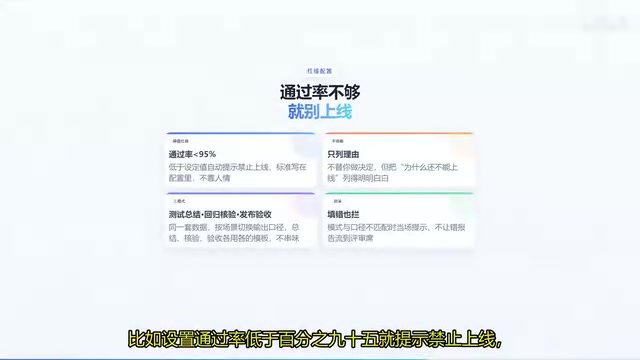
它不替你拍板做结论,但会帮你把「为什么还不能上线」的理由列得明明白白。这对需要向上汇报、又要留痕的测试团队来说,价值不小。
发布标准通常指团队预先定义的量化阈值,如通过率、缺陷密度、严重缺陷关闭率等。Lemon Test Report Skill要求所有结论必须有证据支撑,例如通过率低于95%则触发禁止上线。这本质上是将“质量门禁”自动化:工具不替人决策,但会严格比对预设规则与实测数据,并列出差距。这种做法减少了主观判断的随意性,尤其适合需要向上汇报和留痕的团队,让“不能上线”的理由有据可查。
全场景覆盖与自动打假
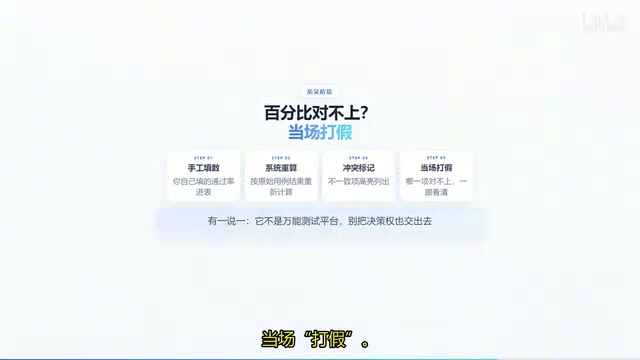
它支持三种工作模式:测试总结、回归核验、发布验收。更实用的是防呆防错——如果你手工填写的百分比和它重新计算的结果冲突,它不仅会重算,还会把冲突项标记出来,当场打假。那位「顺手填98%实际90%」的社死场景,正好被这一机制兜住。
防呆防错(Poka-yoke)源自精益制造,指通过设计让错误无法发生或立即被发现。在测试报告中,常见错误包括百分比填错、数据错位、结论与证据不符。该工具通过重新计算并标记冲突项来实现“自动打假”:当手工填写的百分比与重算结果不一致时,不仅修正数值,还高亮冲突位置,防止“顺手填98%实际90%”的社死场景。这种机制将事后检查变为实时校验,降低了报告的可信度风险。
边界要认清:它不是万能测试平台
有一说一,这个skill不能替你执行自动化测试,不能自动发现真实bug,不能代替你发布最终决策。
它的作用是辅助你更快、更准地完成结果整理、质量分析和发布评审。把整理数据、写报告、统计bug的时间省下来,让你真正去分析质量风险。UP主的用法建议是:先准备好结构化数据,让它跑一遍自动核验,再生成最终报告。
为什么这类工具值得关注
测试报告的本质矛盾在于:它既是质量证据,又是沟通材料,还常常是加班来源。通用大模型能写报告,但缺乏校验意识,容易「报喜不报忧」。把校验规则、结论分级、冲突检测固化进skill,相当于给AI加了一层质量闸门。
这也回应了一个现实问题:未来的测试人不会被AI替代,但会被会用AI整理报告的测试人替代。把写报告的精力省下来留给核心质量把控,才是这类工具真正的提效逻辑。
相关推荐
Claude Code 补测试实战:边界用例、覆盖率与断言怎么写
实战讲解如何用 Claude Code 为项目补单元测试:利用全局上下文生成边界用例、定位未覆盖分支提升覆盖率,并写出有效的断言。对比 Cursor、Trae 等工具,分析 Claude Code 在测试生成准确性上的优势。
把马桶接入树莓派:一场荒诞又硬核的IT实验
一位IT博主用树莓派和浮球开关给马桶接入IP地址,通过GPIO监控冲水事件并与网络断连日志关联。本文拆解硬件接线、上拉电阻原理、0.1秒轮询逻辑与安装过程,并延伸至AI Agent安全监控的同类思路。
语音识别中的偏见:从数据到部署的全链路检测与缓解
基于FAccT会议研究,系统解析语音激活与说话人验证中的七类偏见:从VoxCeleb数据集的历史与表征偏差,到模型规模对偏见的影响、困难测试集上假阴性率骤升的评估陷阱,以及构建包容性评估数据集的设计指南与Fair EVA审计项目。