Claude Code 补测试实战:边界用例、覆盖率与断言怎么写
用 Claude Code 通读项目上下文,补齐边界用例、提升覆盖率并写出有效断言。
文章基于实战演示,讲解如何用 Claude Code 为项目补充单元测试。与对话式编码工具不同,Claude Code 能通读项目全部代码并自动调错,形成「生成测试—运行—修正」的闭环,因此生成的用例更贴合项目的类型定义与工具函数。在边界用例上,可通过提示明确要求覆盖所有 if/else 分支及 null、空串、负数等异常输入;在覆盖率上,应先让 AI 输出未覆盖清单再判断优先级,而非盲目追求数字;在断言上,要同时校验返回值、异常类型与 mock 调用,并尽量具体。横向对比中,Claude Code 准确性优于 Cursor、Trae 等,但 Codex 同样强劲。
Claude Code 作为一款能通读项目全部上下文、自动调错的 AI 编程助手,正在改变开发者写单元测试的方式。本文基于实战演示,拆解如何用它补齐边界用例、提升覆盖率,并写出有效的断言。
Claude Code 凭什么能补测试?
与 ChatGPT、DeepSeek广告 这类对话式编码工具不同,Claude Code 不需要你登录网页,安装后直接在开发工具里使用。它的核心差异在于能通读你项目的所有代码——上百个文件的内容都能作为上下文交给大模型,而不是像对话工具那样只给出代码片段、需要你手动搬运和反复调试。
这种全局上下文能力,恰好是补测试最需要的:写测试必须理解被测函数的入参、依赖和边界条件,单靠一段孤立的代码片段很难做到。Claude Code 还能自动调错,最终给出可运行的代码版本,这让「生成测试 → 运行 → 修正」的闭环可以自动完成。
边界用例:让 AI 主动找「不常走的路」
补测试最容易漏掉的是边界。开发者习惯写「正常路径」的用例,而空值、极值、异常输入往往被忽略。Claude Code 的优势在于它能读到函数内部的分支逻辑,从而针对每个条件分支生成对应的边界用例。
实操时,可以在提示中明确要求:「为这个函数生成单元测试,覆盖所有 if/else 分支,包括入参为 null、空字符串、超长字符串、负数等边界情况。」由于它能通读项目上下文,生成的用例会贴合项目实际的类型定义和工具函数,而不是凭空编造。
覆盖率:从「有测试」到「测得全」
覆盖率不足是单元测试的常见问题——看起来有测试,实际大量分支没被执行。Claude Code 可以在生成测试后,结合项目的测试运行结果定位未覆盖的代码行,再针对性补充用例。
需要注意,覆盖率数字本身不是目的。更合理的做法是让 AI 先输出一份「哪些函数缺少测试、哪些分支未被覆盖」的清单,再由你判断优先级,对核心业务逻辑重点补齐。
覆盖率通常指代码覆盖率(Code Coverage),衡量测试执行时实际运行到的代码比例,常见指标包括行覆盖率(每行代码是否被执行)、分支覆盖率(if/else、switch 等每个分支是否都被走到)和函数覆盖率。业界常用的 Istanbul/nyc、JaCoCo、coverage.py 等工具会在测试运行时插桩记录命中情况并生成报告。分支覆盖率比行覆盖率更严格,因为一行代码可能包含多个条件分支。需要注意的是,高覆盖率并不等于高质量测试——测试可能执行了代码却没有有效断言,因此覆盖率应作为发现盲区的工具,而非追求的唯一目标。
断言怎么写才有意义
断言写得太松,测试等于没写。Claude Code 生成的断言通常会校验返回值,但容易忽略副作用和异常抛出。建议在提示中要求它同时校验:返回值是否符合预期、是否抛出了正确的异常类型、依赖的 mock 是否被按预期调用。
另外,断言应尽量具体。比如不要只断言「结果不为空」,而要断言「结果包含特定字段且值等于预期」。这样测试失败时,报错信息本身就能指向问题。
Mock 是在单元测试中替换真实依赖(如数据库、网络请求、第三方服务)的替身对象,使被测函数可以在隔离环境中运行。常见框架包括 JavaScript 的 Jest、Sinon,Python 的 unittest.mock,Java 的 Mockito。Mock 不仅能返回预设值,还能记录调用情况,因此可以用 toHaveBeenCalledWith、assert_called_once_with 等断言验证依赖是否被按预期调用、参数是否正确。对 mock 调用的断言能捕捉「返回值正确但内部逻辑走错分支」的隐蔽问题,是返回值断言之外的重要补充。但过度 mock 也会让测试与实现细节耦合,重构时容易大量失败。
横向对比:为什么是 Claude Code
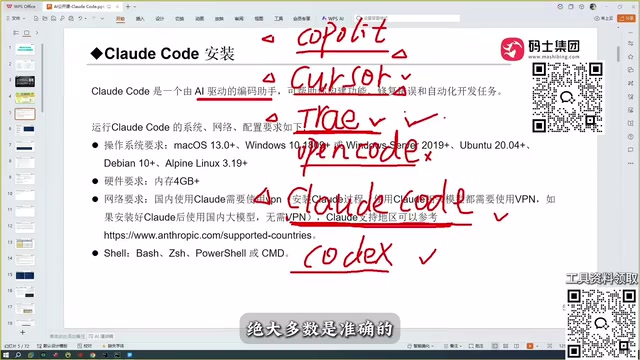
从早期的 Copilot 插件,到 Cursor、Trae,再到 Open Code,AI 编程工具经历了几轮迭代。Copilot 带来了自动补全的颠覆感,Cursor 进一步实现了自动编码,Trae 对中文理解做了优化且国内免费。但实测下来,Claude Code 在准确性上更胜一筹,背后是 Sonnet 等模型的能力支撑。
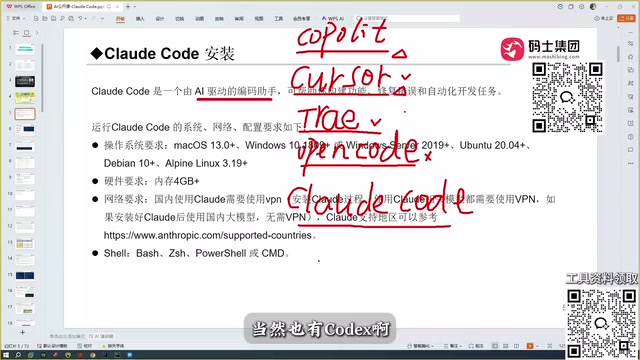
作者也坦言 Codex 同样很强,与 Claude Code 可相媲美;Trae 免费是优势,但在稍偏的技术栈上生成的代码准确性会打折扣。对于补测试这类要求严谨的任务,准确度往往比免费更重要。
文中提到的 Sonnet 指 Anthropic 的 Claude 模型系列中的中端型号(如 Claude 3.5 Sonnet、Claude 3.7 Sonnet),在代码生成与理解任务上表现突出,同时推理成本低于旗舰的 Opus 系列。Claude Code 则是 Anthropic 推出的命令行/IDE 集成式编程代理工具,与网页版对话不同,它能自主读取文件、执行命令、运行测试并根据报错迭代修改。Codex 指 OpenAI 的代码模型系列,早期为 Codex(驱动 GitHub Copilot),后续演化为 GPT 系列中的代码能力;文中语境下指与其对应的编程代理产品。理解模型与工具的区别有助于判断:准确性既取决于底层模型能力,也取决于工具能否获取完整上下文并自动验证。
实践建议
把补测试交给 Claude Code 时,提示词要具体:说明被测函数、要求覆盖的分支类型、断言的校验维度。生成后务必实际运行,让工具自动调错,而不是直接采纳。对核心模块的测试,人工复核断言是否真正有效,避免「覆盖率很高但测了个寂寞」。
相关推荐
测试报告三分钟搞定?Lemon Test Report Skill实测:不造假、可审计
B站UP主分享Lemon Test Report Skill:专为测试人打造的AI报告工具,支持测试总结、回归核验、发布验收三种模式,数据不足自动标记待确认、手工数据冲突当场打假,输出可编辑底稿、网页报告与核验数据包三件套。
把马桶接入树莓派:一场荒诞又硬核的IT实验
一位IT博主用树莓派和浮球开关给马桶接入IP地址,通过GPIO监控冲水事件并与网络断连日志关联。本文拆解硬件接线、上拉电阻原理、0.1秒轮询逻辑与安装过程,并延伸至AI Agent安全监控的同类思路。
语音识别中的偏见:从数据到部署的全链路检测与缓解
基于FAccT会议研究,系统解析语音激活与说话人验证中的七类偏见:从VoxCeleb数据集的历史与表征偏差,到模型规模对偏见的影响、困难测试集上假阴性率骤升的评估陷阱,以及构建包容性评估数据集的设计指南与Fair EVA审计项目。