拆解 Claude Opus 5.5 用代码生成动画视频的实现路线

用代码驱动逐帧渲染再合成视频,把AI视频创作从黑盒生成变为可调试的工程流程。
文章拆解了 Claude Opus 5.5 样片背后的技术路线:模型将需求写成代码,浏览器按时间轴逐帧绘制画面,再由工具合成视频。手绘质感通过30帧下每隔两帧换姿势实现,界面变形依赖 SVG 形态插值并需错开退场与进场防止穿帮,三维漫游则靠 WebGL 场景加摄像机路径控制。作者以 12 秒小样验证了完整流程的可复现性,并强调提示词应从「观众要看懂什么变化」出发。这套方法并非 Claude 独有,核心价值在于把视频创作变成文件化、可迭代的工程资产。
从一段代码到一段视频
Claude Opus 5.5 最近放出的写代码做视频样片引起了不少关注——手绘质感的线条会动起来、界面在不断变形拉伸、甚至能走进一个三维房间漫游。这些看似复杂的效果背后,其实是一条清晰可复现的技术路线。
这条路线的核心逻辑并不神秘:模型先把你的需求写成代码,浏览器负责把代码画成一帧帧画面,再把连续画面合成为视频。拿一只从左走到右的猫举例,它的位置随时间变化,每秒取 30 张图连起来,动作就出现了。更关键的是,这种方式让每一帧都可控——把时间退回去,同一时刻的猫仍在同一个位置,意味着你可以对任意一帧做精准校对。
这种「代码驱动 + 逐帧导出 + 合成视频」的流程,本质上是把视频创作变成了一个可编程、可调试的工程问题,而不是一次性的黑盒生成。
手绘质感是怎么搭出来的
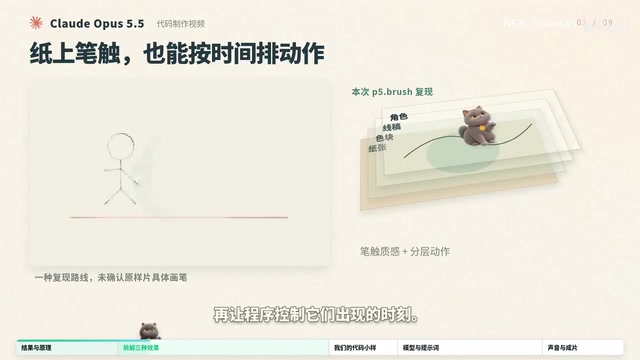
样片里那段手绘动画格外惊艳:线条有轻微抖动,颜色像铺在纸上,动作还带着一顿一顿的手画感。复现这种质感,可以用开源画笔库来实现——线条、色块、角色各画一层,再让程序控制它们出现的时刻。
画面每秒导出 30 帧,而角色可以每隔两帧才换一个姿势,这样播放依然连贯,又保留了手绘特有的停顿感。这个细节很说明问题:所谓「手绘感」并不是随机生成的,而是通过精确控制帧率与姿势切换节奏刻意营造出来的视觉效果。
需要说明的是,原样片具体用了哪套画笔库,还要参考它实际生成的代码,这里展示的只是一种可行的复现思路。
这里提到的「开源画笔库」,业内常用的代表是 Rough.js——它能让直线和矩形带上手绘抖动的轨迹,通过调节 roughness(粗糙度)和 bowing(弯曲度)参数就能控制线条的「手工感」程度。更完整的手绘动画场景里,Rough.js 通常搭配 Canvas 或 SVG 渲染层使用,角色的不同姿势则对应一组预先绘制好的关键帧图像,由代码按时间戳切换显示。「每隔两帧换姿势」在动画行业有个专有名词叫「on twos」(按二拍摄),是传统手绘动画的标准做法,迪士尼早期动画大量使用这一节奏,既节省了绘制帧数,又形成了区别于流畅电脑动画的独特质感。现代 CSS/JS 动画默认追求每帧都插值计算,反而丢失了这种「人手痕迹」,所以需要刻意跳过中间帧来复现。
界面变形与三维漫游的门道
界面变形这一段的关键在于「同一个形状始终留在眼前」。一个形状拉长、展开,里面的内容随之替换,观众的视线不用重新寻找主角。实现上分工明确:网页元素负责文字和按钮,矢量图负责轮廓,动画库控制变化速度。
最容易穿帮的地方在于交接——旧文字还没退场,新文字就进来了。解决办法是把退场和进场错开,变形才干净利落。这类细节在写提示词时就值得明确写清楚。
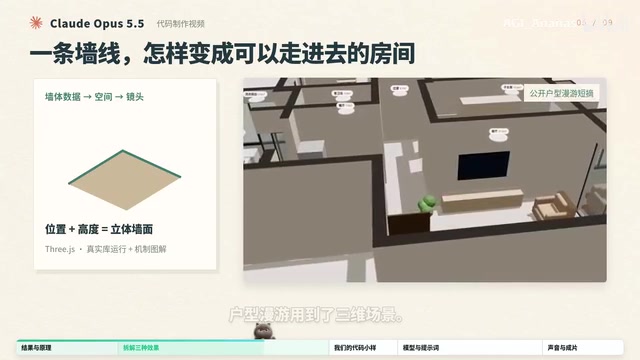
三维漫游则用到了完整的三维场景。项目代码里,墙体和家具都有坐标位置,镜头可以在房间里移动。平面上的一条墙线抬起来就成了墙面,给它高度、摆上家具,房间才有了深度。做成视频还要写一条镜头路线:什么时候走进门、什么时候转向窗边,全部交给时间轴来控制。不过要换一张新背景图,就还需要检查识别精度和尺寸适配。
文中提到的「矢量图负责轮廓、动画库控制变化速度」,对应的常见技术栈是 SVG 形变配合 GSAP(GreenSock Animation Platform)或 Anime.js。SVG 的 <path> 元素可以通过插值两组路径点数据实现形状之间的平滑变形(morphing),前提是两个路径的锚点数量需要一致,这也是「交接穿帮」问题的技术根源——如果旧路径和新路径的结构不对齐,插值会产生形状撕裂。三维漫游部分则通常依赖 Three.js,它是浏览器端最主流的 WebGL 封装库,可以用 JavaScript 定义墙体坐标、材质贴图和摄像机路径,浏览器通过 GPU 渲染出透视正确的三维画面。把「镜头路线写进时间轴」,本质上是在 Three.js 的动画循环里按帧更新摄像机的 position 和 lookAt 向量。
一个 12 秒小样的完整复现
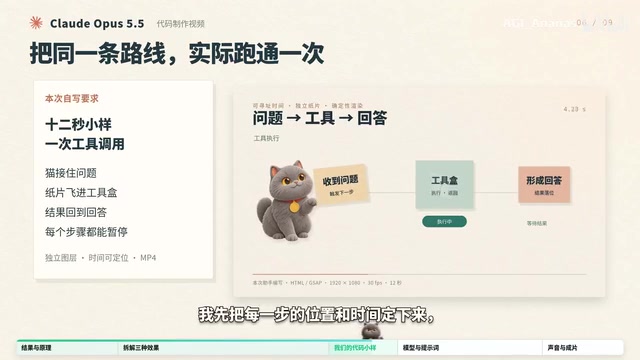
作者按这条路线亲手写了一个 12 秒的小样:一只猫接住飞来的问题,纸片飞进工具盒,结果在回答里呈现,每个动作都对应一个明确步骤。
制作流程是:先把每一步的位置和时间定下来,再让浏览器逐帧取图,最后合成视频。代码和成片都保留下来,想换角色或改停留时间,沿着这套文件继续改即可。
这种「文件化、可迭代」的工作方式,是整条路线最有价值的部分——它把一次性的创作沉淀成了可复用的资产。
「浏览器逐帧取图」这一步在工程实现上并不简单。常见方案是用 Puppeteer 或 Playwright 这类无头浏览器工具,通过脚本自动化地将页面时间轴推进到每一帧(如每隔 1/30 秒),然后调用截图接口导出 PNG,最后用 FFmpeg 把图片序列合成 MP4。这个过程的挑战在于时序同步:页面里的 CSS 动画或 requestAnimationFrame 循环需要被「冻结」在指定时刻,而不是随系统时钟自由播放,否则截图时机与动画状态会对不上。另一种方案是在 Canvas 动画代码里直接集成 CCapture.js 或 RecordRTC,从浏览器内部抓取每一帧的像素数据,避免外部工具的时序问题。无论哪种方案,「每帧都可校对」的特性都依赖于动画本身是确定性的——给定同一个时间戳,画面状态完全一致,这正是代码驱动相对于实时录屏的核心优势。
其他模型能不能做
一个自然的疑问是:这套方法是 Claude Opus 5.5 独有的吗?答案是否定的。画布、动画库和渲染工具本身都可以被其他编程模型调用,DeepSeek广告 等模型也可以尝试同样的任务。
实际效果取决于模型能否把动作写完整、跑通依赖,并根据预览反馈修正问题。作者坦言这次没有做模型之间的对照跑分,更想留下的是这条能复用的制作路线,而非一场性能比拼。
提示词该怎么写
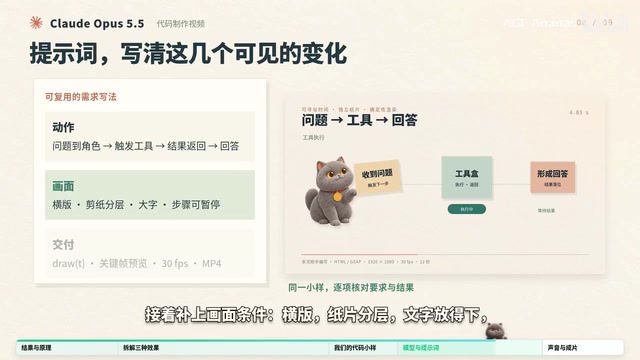
写提示词的起点,应该是「观众要看懂什么变化」。以那个小样为例,作者写的是:问题先到角色手里,随后出发,工具产出结果返回,角色才给出回答。接着补充画面条件——横版、纸片分层、文字放在后几步,每个步骤都能停下来检查。
最后写交付要求:能定位到任意时刻,先给关键帧再导出视频;预览有问题就改具体动作——纸片挡住结果就让它先退场,信息看不清就放大字号并留一点阅读时间。
如果要做带配音的片子,还得给声音留出位置:一句话里的动作说到哪,画面就跟到哪,字幕也要跟实际声音走,不能按字数平均分配。这些都是从实践中总结出的可操作经验。
真正值得带走的东西
这条路线的价值不在于某个惊艳的样片,而在于方法论的可迁移性。远程仓库里有逐帧导出的脚本,提示词库也收录了不少不同风格的案例,可以先挑一个效果做几秒,再把它做稳。
正如作者所说,真正值得带走的是:看见一段效果之后,能说清它怎么动、有什么话、怎么检查。这样下次换个主题,手里依然有一套能继续复用的办法。这或许才是 AI 辅助视频创作从「碰运气」走向「工程化」的关键一步。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。