拆解语言模型可控性:容量、响应度与对齐的三要素框架

论文将激活干预的有效性拆解为容量、响应度、对齐度三因子,提出因果探针大幅提升模型可控性。
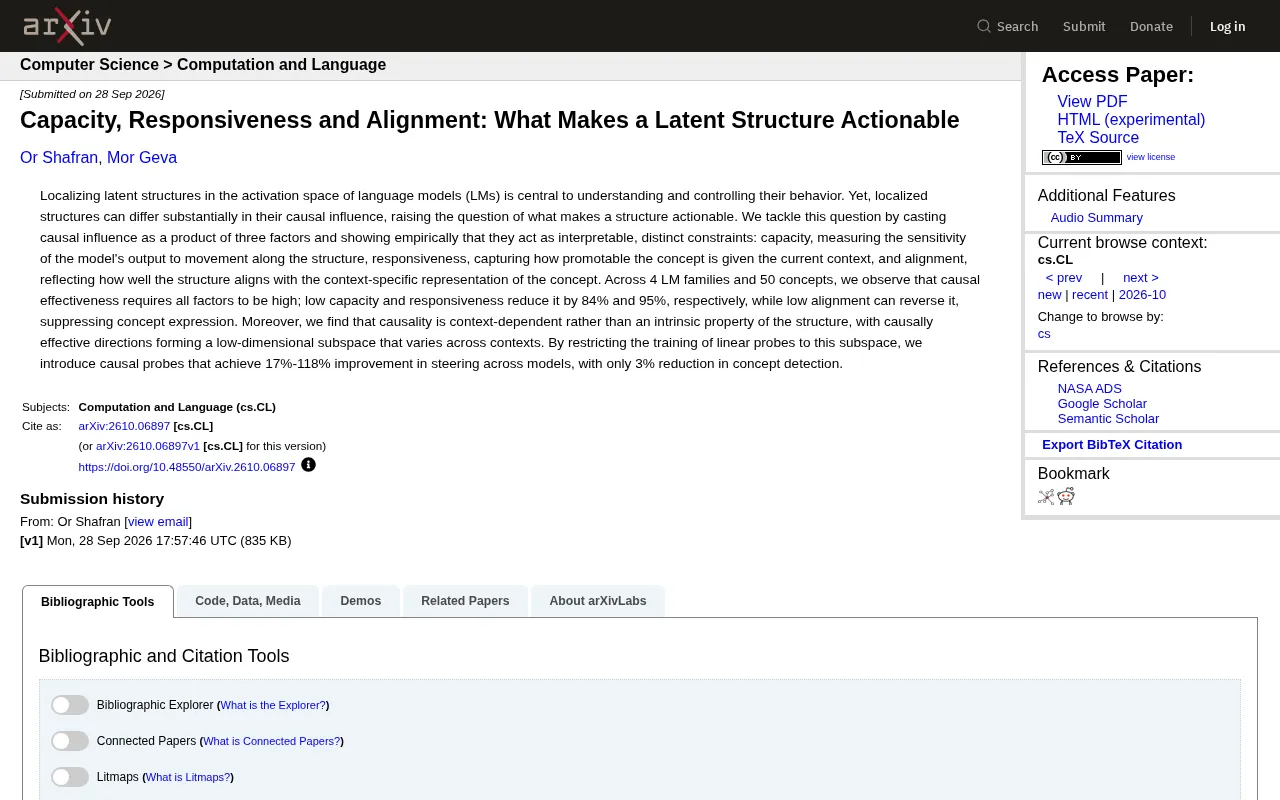
这篇论文系统回答了激活空间干预研究中一个长期悬而未决的问题:为什么有些"概念方向"能真正改变模型输出,有些却无效甚至适得其反?研究者将潜在结构的因果影响力建模为三个相互独立的因子——容量(输出对该方向的敏感度)、响应度(上下文对概念表达的支持程度)、对齐度(方向与当前语境中概念真实表征的匹配程度)——并在4个模型家族、50个概念上验证了三者缺一不可。低容量使效果下降84%,低响应度下降95%,低对齐度甚至会反转干预方向。基于此,论文提出"因果探针"方法,将探针训练约束在因果有效子空间内,实现了17%–118%的引导能力提升,而概念检测精度仅损失3%,为可解释性与模型控制研究提供了可量化的诊断框架。
为什么有些潜在结构能左右模型输出,有些却不能
在语言模型的激活空间中定位潜在结构(latent structure),一直是理解和控制模型行为的核心手段。研究者通过线性探针、方向向量等方式,试图找到代表某个概念(比如"情感""事实性")的方向,再通过干预这些方向来引导模型输出。
但一个长期被忽视的问题是:并非所有被定位到的结构都具有同等的因果影响力。同样是一条"概念方向",有的能显著改变模型输出,有的却几乎无效,甚至适得其反。这篇 arXiv 新论文(arXiv:2610.06897)正是围绕一个关键问题展开:到底是什么让一个潜在结构真正"可操作"(actionable)?
把因果影响拆成三个可解释的因子
论文的核心贡献,是把一个潜在结构的因果影响力建模为三个因子的乘积,并通过实验证明它们是相互独立、可解释的约束条件:
容量(Capacity)
容量衡量的是模型输出对沿该结构移动的敏感程度。简单说,当你沿着这个方向推动激活值时,输出会不会有明显变化。如果容量低,说明这个方向对输出的"杠杆"很弱。
容量这一概念可以类比于电路中的阻抗:即便信号方向正确,若通路阻抗过高,输出端依然感受不到有效驱动。在激活空间中,某个方向可能确实编码了某个概念,但如果模型的后续计算层对该方向的变化不敏感——例如被后续层的归一化或注意力机制所抑制——那么沿该方向施加的干预就无法传导到最终输出。这也解释了为何线性探针能"找到"某个方向(探针任务只需方向存在),却不代表该方向对模型的生成行为有实质性影响。容量低的方向在表示层面是"真实"的,但在功能层面是"哑"的。
响应度(Responsiveness)
响应度捕捉的是在当前上下文下,该概念有多容易被"推动"出来。它反映了上下文本身是否为这个概念的表达提供了空间。即便方向找对了,如果上下文根本不支持这个概念,干预也难以生效。
对齐度(Alignment)
对齐度反映的是该结构与概念在特定上下文中的表征对齐程度。方向可能大致正确,但如果与当前上下文中概念的真实表征存在偏差,干预效果就会打折扣——甚至反向。
实验揭示:三要素缺一不可
研究团队横跨 4 个语言模型家族、50 个概念 进行了系统验证,结论相当明确:因果有效性要求三个因子都处于高位。
具体的数据很有说服力:
- 低容量会使因果效果降低 84%
- 低响应度会使因果效果降低 95%
- 低对齐度则更危险——它不只是削弱效果,而是能够反转干预方向,直接抑制概念的表达
这意味着,当我们试图通过激活干预来引导模型时,哪怕方向大致正确,只要其中一个因子不达标,整个干预就可能失效或走向反面。这也解释了为什么过去很多"看似合理"的方向在实际 steering(引导)任务中表现不稳定。
因果性是上下文依赖的,而非结构的固有属性
论文另一个重要发现,是对一种常见假设的纠偏:因果性并不是某个结构内在、固定的属性,而是依赖上下文的。
研究者观察到,真正具有因果效力的方向会构成一个低维子空间,而这个子空间会随上下文变化而变化。换句话说,同一个概念在不同语境下,其可操作的方向可能并不相同。这对那些试图寻找"通用概念向量"的工作提出了挑战——不存在一劳永逸的方向,控制必须考虑语境。
这一发现与"表示工程"(Representation Engineering)领域的部分假设形成了张力。早期工作(如 Zou et al., 2023 的 RepE 框架)倾向于寻找跨上下文稳定的"控制向量",并将其视为可复用的干预工具。然而本文的结果表明,有效子空间随上下文漂移,意味着在一组提示上提取的方向,在语境切换后可能既无法检测、也无法操控目标概念。这对批量构建"概念库"的工程实践提出了挑战:控制向量不能脱离其提取时的语境使用,部署前需要验证目标场景下三个因子是否同时满足。
因果探针:把训练限制在有效子空间内
基于上述洞察,论文提出了一个实用的方法——因果探针(causal probes)。
思路很直接:既然真正有效的方向集中在一个低维子空间里,那就把线性探针的训练限制在这个子空间内,而不是在整个激活空间中自由搜索。
效果相当可观:
- 在不同模型上,steering(引导)能力实现了 17%–118% 的提升
- 而概念检测能力仅下降 3%
这是一个非常划算的权衡——用极小的检测精度损失,换来大幅提升的可控性。它说明"能检测"和"能操控"是两个不同的目标,而传统探针往往只优化了前者。
传统线性探针的训练目标是最大化概念分类精度,因此会在整个激活空间中寻找分离度最高的超平面,并不区分该方向是否具有因果影响力。这种"检测优先"的优化方式,往往会选中与概念高度相关但对输出无实际控制力的方向——例如模型仅用来内部记账、不影响生成决策的维度。因果探针则通过先识别具有高容量、高响应度和高对齐度的子空间,再将探针训练约束于其中,从根本上对齐了"找到概念"与"能够操控概念"这两个目标。17%–118% 的引导能力提升,与仅 3% 的检测精度损失之间的对比,直观说明了两个目标在全空间中本就存在结构性偏差。
对可解释性与模型控制研究的意义
这项工作的价值,在于它为"激活干预到底什么时候有效"提供了一个结构化的分析框架。过去研究者常常凭经验去找方向、做干预,成功与否带有一定运气成分。容量、响应度、对齐度这三个维度,把模糊的"有效性"拆成了可测量、可诊断的部分。
对于从事模型安全、行为对齐和可解释性的研究者来说,这个框架提供了几个实用的启示:
- 干预失败时,可以逐一诊断是三个因子中的哪一个出了问题;
- 不要指望找到脱离上下文的"万能概念方向";
- 在构建控制工具时,优先在因果有效子空间内训练探针,而非全空间搜索。
随着语言模型越来越多地被部署在需要可控、可审计的场景中,理解"什么样的内部结构真正能左右输出"将变得愈发重要。这篇论文把这个问题从直觉层面推进到了可量化、可操作的层面,是激活空间可解释性研究值得关注的一步。
相关推荐
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
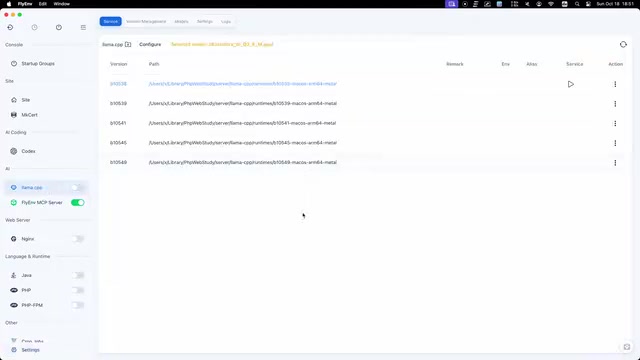
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
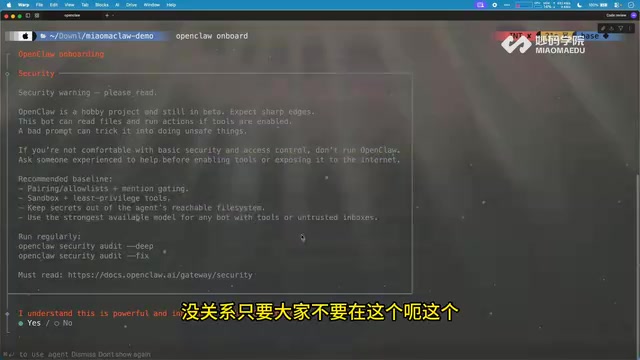
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
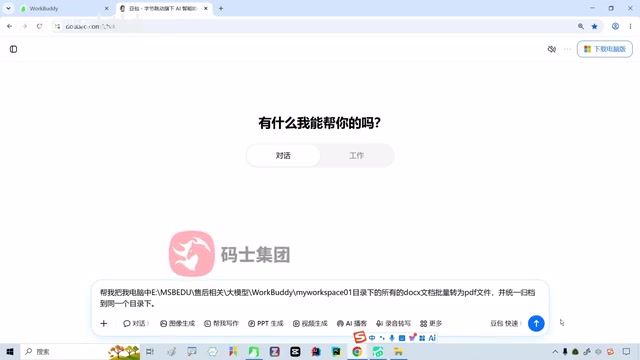
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。