长程记忆的代价:序列模型中的状态、上下文与稳定性复杂度

理论研究证明长程记忆预测所需状态数满足平方对数定律,分数记忆改变误差几何,临界性是高精度的必要代价。
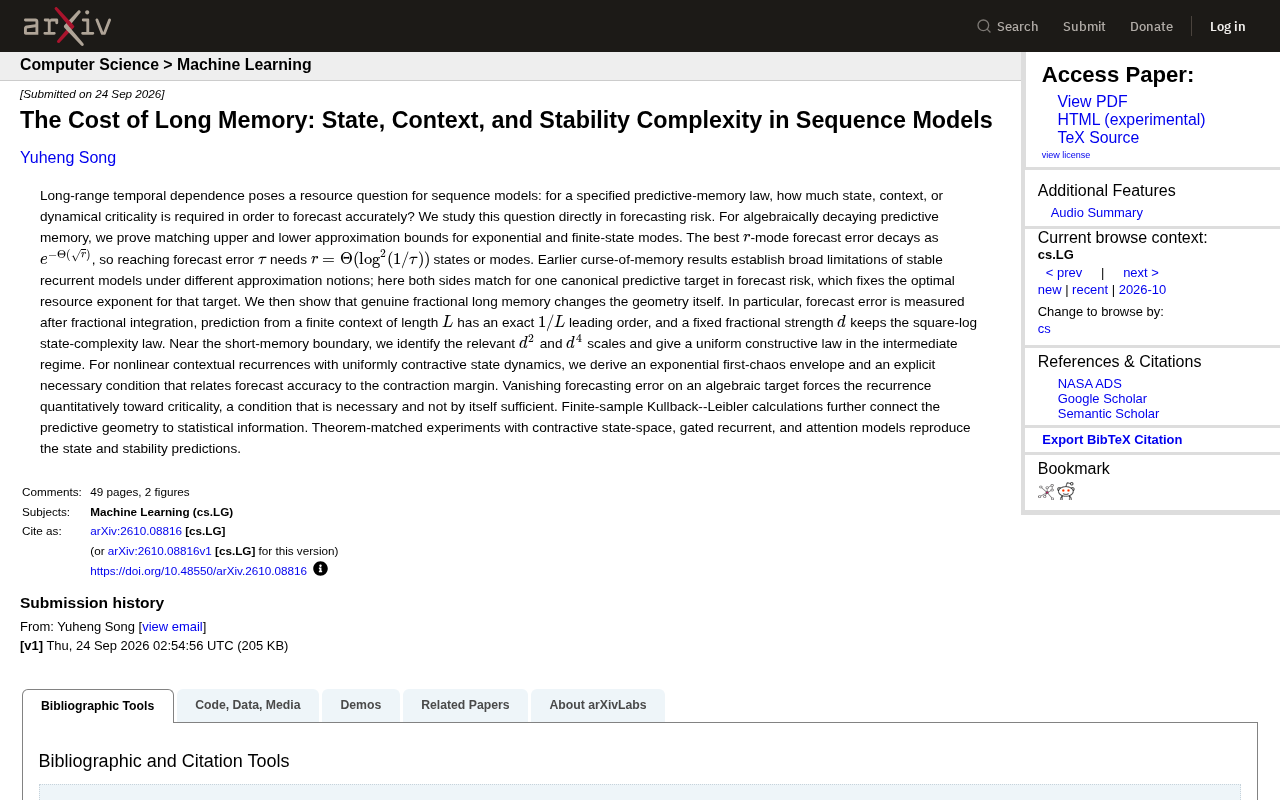
这篇理论论文从"预测风险"角度精确刻画了序列模型捕捉长程时间依赖所需的计算资源。核心结论有三:其一,对于代数衰减记忆目标,最优预测误差以 $e^{-\Theta(\sqrt{r})}$ 衰减,达到精度 $\tau$ 所需状态数为 $\Theta(\log^2(1/\tau))$,上下界紧致匹配;其二,引入分数积分后误差几何发生质变,有限上下文预测存在精确的 $1/L$ 领先阶误差,在 $d$ 固定时平方对数定律依然成立,并在短记忆边界附近识别出 $d^2$、$d^4$ 尺度;其三,对非线性收缩递归模型,趋近零误差定量迫使动态趋向临界性,这是必要而非充分条件。研究通过 KL 散度打通了近似理论与统计学习,并在三类主流架构上进行了定理匹配实验加以验证,为序列模型设计提供了严格的理论标尺。
一个被忽视的核心问题:长记忆到底要花多少"资源"
序列建模的核心挑战之一,是如何处理长程时间依赖(long-range temporal dependence)。无论是语言模型、时间序列预测还是状态空间模型,当需要捕捉遥远过去对当前预测的影响时,一个绕不开的问题浮出水面:为了达到指定的预测精度,模型究竟需要多少状态(state)、多长的上下文(context),或多强的动态临界性(dynamical criticality)?
这篇发表于 arXiv 的理论研究(arXiv:2610.08816)直接从"预测风险"(forecasting risk)的角度切入,试图为这个长期模糊的工程直觉给出精确的数学刻画。它不满足于经验观察,而是给出了可证明的上界与下界匹配结果,为特定预测目标锁定了最优的资源指数。
代数衰减记忆:平方对数状态复杂度定律
论文的第一个核心结论聚焦于代数衰减的预测记忆(algebraically decaying predictive memory)。对于这类预测目标,作者证明了指数模式和有限状态模式下的近似上下界完全匹配。
具体来说,最优的 $r$-模式预测误差以 $e^{-\Theta(\sqrt{r})}$ 的速率衰减。换言之,要把预测误差压到 $\tau$ 水平,所需的状态数或模式数为 $r=\Theta(\log^2(1/\tau))$。这就是文中反复强调的"平方对数状态复杂度定律"。
这一结果的意义在于,它把早期关于"记忆诅咒"(curse-of-memory)的宽泛限制往前推进了一步。此前的工作在不同的近似概念下证明了稳定循环模型的广泛局限性,而这里的贡献是:对于预测风险中的一个典型目标,上界和下界两侧完全吻合,从而固定了该目标的最优资源指数。这种"紧致"的刻画在理论上是相当有分量的。
所谓"代数衰减的预测记忆",是指过去时刻对当前预测的贡献随时间步长 $t$ 以幂律 $t^{-\alpha}$($\alpha > 0$)的方式衰减,而非指数式快速消退。这种衰减模式在实际数据中相当常见,例如金融时间序列的波动率自相关、自然语言中的词频分布,以及物理系统中的 $1/f$ 噪声等。与之对比,指数衰减记忆(如标准 RNN 的隐状态)衰减更快,信息保留时间有限。代数衰减意味着即使是数百步之前的信息也可能对预测贡献不可忽视的权重,这正是"长程依赖"问题困难的根本原因。"$r$-模式近似"是一种将预测问题投影到有限维基展开的框架,$r$ 可以理解为模型用于表示过去历史的有效自由度数量,类似于截断的基函数个数或状态空间的维度。平方对数定律 $r = \Theta(\log^2(1/\tau))$ 表明,精度每提升一个数量级,所需状态数仅以对数平方增长,这在计算复杂性上是相当温和的代价。
分数长记忆:几何本身被改变了
论文更有新意的部分,是对"真正的分数长记忆"(genuine fractional long memory)的分析。作者指出,当引入分数积分(fractional integration)后,问题的几何结构本身发生了变化。
几个关键发现值得留意:
- 有限上下文的 $1/L$ 主导项:在分数积分后度量预测误差时,从长度为 $L$ 的有限上下文做预测,存在一个精确的 $1/L$ 领先阶误差。这意味着上下文长度与精度之间存在明确的多项式关系,而非指数关系。
- 固定分数强度仍保持平方对数定律:当分数强度 $d$ 固定时,状态复杂度依然服从平方对数定律。
- 短记忆边界附近的尺度分析:在接近短记忆边界的区域,作者识别出相关的 $d^2$ 和 $d^4$ 尺度,并在中间区间给出了统一的构造性定律。
这部分揭示了一个重要洞见:长记忆并非只是"更难学"的量变问题,分数记忆会改变误差衰减的本质规律,上下文长度的作用在这里变得尤为关键。
分数积分(fractional integration)源于分数阶微积分,其核心思想是将经典的整数阶积分推广到实数阶 $d \in (0, 0.5)$。在时间序列领域,ARFIMA(自回归分数积分移动平均)模型正是通过分数差分算子 $(1-B)^d$ 来刻画长记忆特性,其中 $B$ 为滞后算子。当 $d > 0$ 时,序列的自相关函数以幂律 $k^{2d-1}$ 衰减,衰减速度比短记忆过程慢得多,且所有滞后的自相关之和发散——这是"真正的长记忆"区别于普通自回归过程的关键特征。参数 $d$ 被称为分数强度,它直接控制记忆的"持久性":$d$ 越大,过去信息对现在的影响越持久。该论文中"接近短记忆边界"是指 $d \to 0^+$ 的极限情形,此时长记忆特性逐渐消失,$d^2$ 和 $d^4$ 的尺度分析揭示了从长记忆向短记忆过渡时误差行为的精细结构。
非线性递归与"临界性"的必要条件
对于带有一致收缩状态动态(uniformly contractive state dynamics)的非线性上下文递归模型,论文推导出了一个指数型的"first-chaos envelope",并给出了一个显式的必要条件,将预测精度与收缩裕度(contraction margin)联系起来。
结论颇具启发性:在代数目标上让预测误差趋于零,会定量地迫使递归动态趋向临界性(criticality)。不过作者谨慎地指出,这是一个必要条件,而非充分条件——换句话说,趋近临界是达到高精度的代价,但光靠临界本身并不保证成功。
这呼应了深度学习领域长期以来关于"edge of chaos"(混沌边缘)的讨论:模型若想记住很久以前的信息,往往需要把动态系统推到稳定与不稳定的交界处,而这正是训练不稳定性的根源之一。该研究为这一经验现象提供了量化的理论支撑。
"edge of chaos"(混沌边缘)理论最早由 Langton 在研究元胞自动机时提出,后被 Sompolinsky 等人引入神经网络动力学分析。其核心观点是:动力系统在有序(稳定收缩)与混沌(指数发散)之间的临界区域,具有最强的信息处理和传递能力。在循环神经网络中,这对应于雅可比矩阵最大奇异值(谱半径)趋近于 1 的状态。收缩裕度(contraction margin)是衡量系统距临界点远近的量:裕度越大,系统越稳定,梯度消失越严重,长程信息越难保留;裕度趋于零则意味着系统趋近临界,理论上可以传递更长时间的信息,但同时带来梯度爆炸和训练不稳定的风险。本文将这一经验现象提升为可证明的数学必要条件,给出了精度 $\tau$ 与收缩裕度之间的显式定量关系,回答了"到底要靠多近临界点才能达到给定精度"这一具体问题。
从几何到统计信息,再到实验验证
论文还通过有限样本的 Kullback–Leibler 计算,把预测几何与统计信息联系起来,打通了近似理论与统计学习之间的桥梁。
更难得的是,作者并没有停留在纯理论层面。文中进行了"定理匹配"(theorem-matched)的实验,覆盖了三类主流架构:
- 收缩型状态空间模型(contractive state-space models)
- 门控循环模型(gated recurrent models)
- 注意力模型(attention models)
实验结果复现了理论预测的状态与稳定性规律。这种"理论预言—实验验证"的闭环,让这项工作的说服力大大增强,也让它对实际模型设计具备了一定的指导价值。
Kullback–Leibler(KL)散度是衡量两个概率分布差异的信息论工具,$\mathrm{KL}(P | Q) = \mathbb{E}_P[\log(P/Q)]$,可以理解为用分布 $Q$ 近似真实分布 $P$ 所损失的"信息量"(以比特或奈特为单位)。在统计学习中,KL 散度与最大似然估计和贝叶斯风险有深刻联系:最小化预测误差在某些设置下等价于最小化 KL 散度。将"预测几何"(即函数空间中的近似误差)与 KL 散度对接,意味着论文的结论可以从确定性近似理论直接翻译到有限样本的统计学习保证——即给定 $n$ 个观测样本时,需要多少状态才能达到统计意义上的精确预测。这一桥梁使理论结果不仅是数学上的存在性证明,也具备了可操作的样本复杂度含义,对理解实际训练中模型规模与数据量的权衡关系具有参考价值。
对工程实践的潜在启示
虽然这是一篇偏理论的论文,但它的结论对序列模型设计者并非遥不可及:
- 状态数的平方对数定律提示我们,追求极高精度时状态成本的增长虽然不是指数级,但也绝非线性,需要在精度与资源间做清醒权衡。
- 分数记忆的 $1/L$ 上下文定律说明,对于某些长记忆任务,单纯堆上下文长度的边际收益可能遵循多项式规律,这对注意力模型的上下文窗口扩展策略有参考意义。
- 临界性的必要条件则解释了为何长记忆模型往往伴随训练不稳定——这是追求长程依赖时无法回避的结构性代价。
总体而言,这项研究把"长记忆要花多少钱"这个工程直觉,转化为可证明的数学定律,为理解和设计序列模型提供了一个难得的理论标尺。
相关推荐
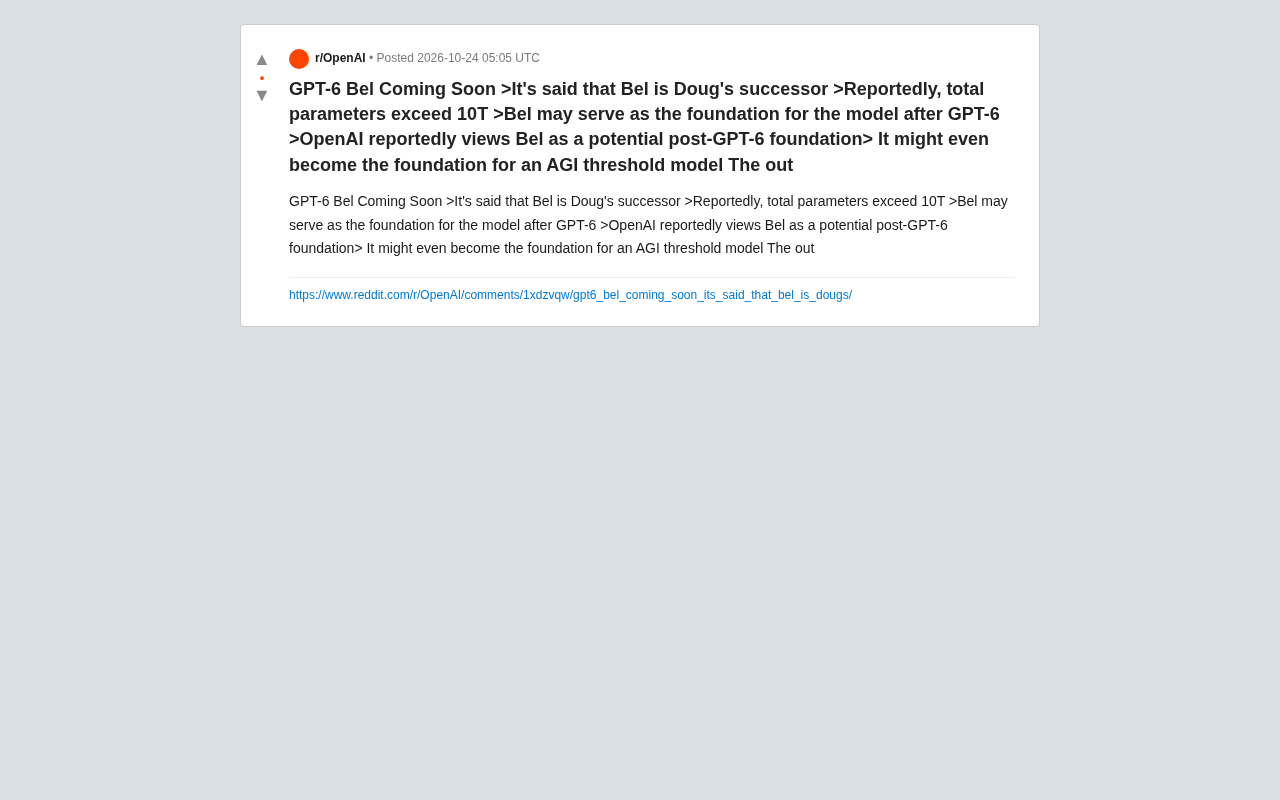
OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。
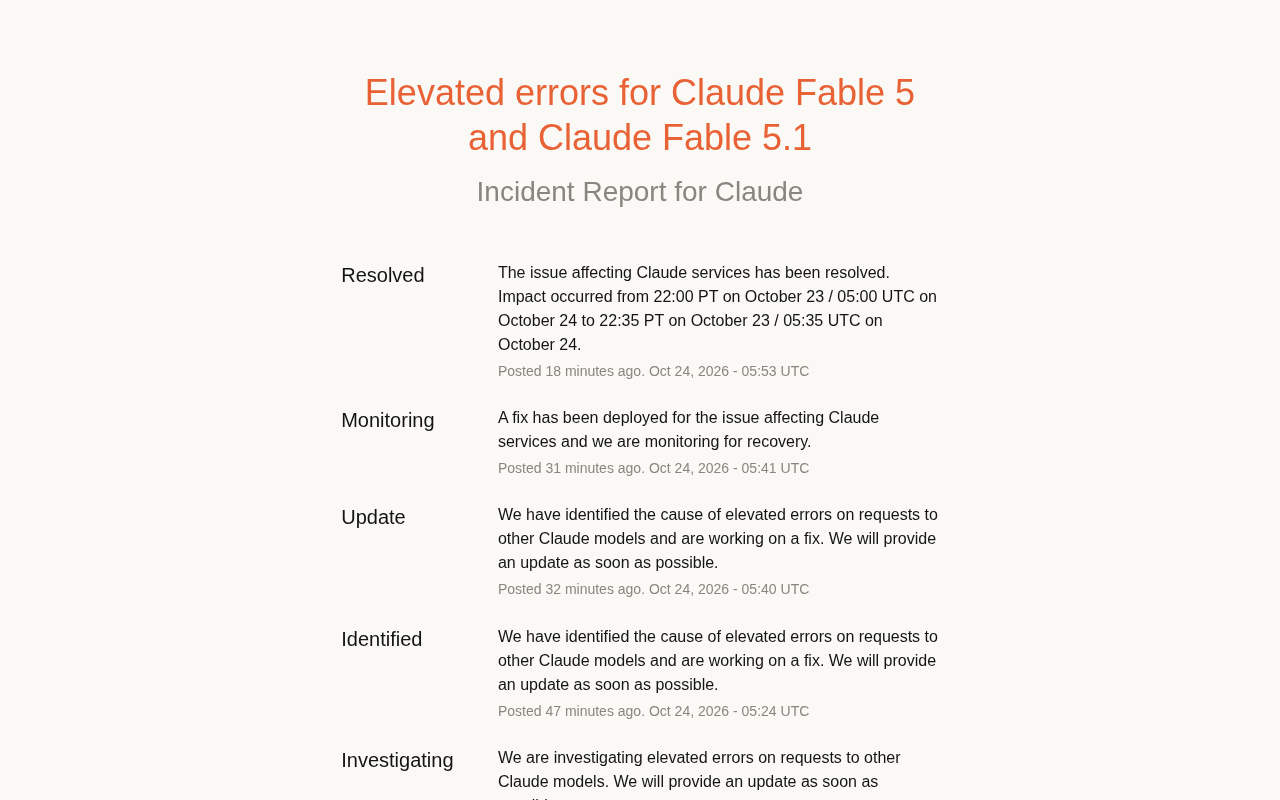
Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。