AI/BI仪表盘嵌入安全指南:多租户数据隔离与权限控制实践

引言:嵌入之外的安全难题
将Databricks的AI/BI仪表盘嵌入到面向客户的应用中,技术实现本身并不复杂。Databricks AI/BI仪表盘是Databricks在其Lakehouse平台上推出的原生商业智能可视化工具,支持无代码/低代码方式创建交互式报表和数据看板。与传统BI工具(如Tableau、Power BI)不同,它直接运行在Lakehouse架构之上,查询直接命中Delta Lake中的数据,无需额外的数据搬迁或副本创建。
Delta Lake是由Databricks开源的存储层技术,为数据湖带来了ACID事务、Schema强制执行和时间旅行(Time Travel)等数据仓库级别的可靠性保障。Lakehouse架构则是Databricks提出的新一代数据架构范式,旨在将数据湖的灵活性和低成本存储与数据仓库的高性能查询和数据治理能力统一在同一个平台上。这意味着AI/BI仪表盘直接查询Delta Lake中的数据时,既能享受列式存储和数据跳过(Data Skipping)带来的查询加速,又能确保数据一致性和版本管理。理解这一架构背景,有助于认识到为什么在Lakehouse层面实施安全策略比在外部BI工具中实施更为高效和可靠。
嵌入功能允许开发者通过iframe或SDK将仪表盘集成到第三方Web应用中,使终端用户无需登录Databricks即可查看数据可视化内容。iframe(Inline Frame)是HTML标准中用于在当前页面中嵌入另一个独立HTML文档的元素,是嵌入式BI最常见的集成方式。iframe天然提供了DOM隔离——嵌入内容与宿主页面运行在不同的浏览上下文中,但这也带来了跨域通信(Cross-Origin)的安全挑战。现代浏览器的同源策略(Same-Origin Policy)限制了宿主页面与iframe内容之间的直接交互,Content-Security-Policy中的frame-ancestors指令则控制了哪些域名被允许嵌入该内容。SDK嵌入方式通常封装了iframe创建、令牌注入、事件监听和尺寸自适应等底层逻辑,提供更友好的开发者体验和更精细的交互控制能力。开发者只需几步操作,就能将功能丰富的数据可视化界面呈现给终端用户。然而,真正的挑战不在于"如何嵌入",而在于"如何确保每位观看者只能看到被授权访问的数据"。
在多租户SaaS应用场景中,成千上万的客户可能共享同一个底层数据平台。多租户(Multi-tenancy)是现代SaaS架构的基石模式,指多个客户(租户)共享同一套软件实例和底层基础设施,但各自的数据和配置逻辑上彼此隔离。这种架构极大地降低了运维成本和资源消耗,但也将数据隔离的责任从物理层面转移到了逻辑层面。近年来GDPR、CCPA等数据保护法规的实施,使得多租户环境下的数据越权访问不再仅仅是技术问题,更可能引发巨额罚款和法律诉讼。一旦安全边界设计不当,某个客户就可能窥探到其他客户的敏感业务数据——这不仅是技术故障,更是严重的合规与信任危机。本文将深入探讨如何在AI/BI仪表盘嵌入场景下,构建面向每位观看者的安全防护体系。
核心挑战:从"能嵌入"到"安全嵌入"
嵌入容易实现,数据隔离才是关键
嵌入一个Databricks AI/BI仪表盘"相对直接",但当应用需要服务大量不同权限的用户时,安全问题随之显现。
设想一个典型场景:一家数据分析SaaS服务商为数百家企业客户提供业务洞察面板。每家企业只能看到自己的销售、运营与财务数据。如果仅依靠前端界面隐藏或简单的应用层过滤,攻击者完全可能通过篡改请求参数或直接访问API绕过限制,获取本不该看到的数据。
因此,安全的核心目标是实现数据行级与列级的精细化隔离,并将隔离机制下沉到数据平台层,而不是停留在应用表层。
多租户环境下的三种权限隔离模式
在多租户架构中,权限控制通常有以下几种典型模式:
- 独立数据库/Schema隔离:每个租户拥有独立的数据存储空间,隔离性最强,但运维成本较高。这种模式在合规要求极为严苛的行业(如金融、医疗)中较为常见,但随着租户数量增长,数据库实例的管理和资源开销会呈线性甚至超线性增长。在Databricks Lakehouse环境中,这种模式通常表现为每个租户拥有独立的Catalog或Schema,利用Unity Catalog的命名空间隔离来实现物理级别的数据分离。
- 共享表 + 租户标识过滤:所有租户数据存放在同一张表中,通过
tenant_id等字段区分,成本低但对安全过滤逻辑要求极高。一旦过滤条件在某个查询路径中被遗漏,就会造成跨租户数据泄露。 - 行级安全(Row-Level Security, RLS):在数据平台层面定义访问策略,根据当前用户身份自动过滤可见行。行级安全的核心思想是在查询执行引擎中自动注入过滤条件,使每个用户只能看到被授权的数据行。与应用层过滤相比,RLS在SQL执行计划层面生效,这意味着即使用户绕过应用逻辑直接执行SQL查询,也无法突破行级过滤的约束。在Databricks中,RLS通常通过行过滤器(Row Filter)函数实现——管理员为表绑定一个过滤函数,该函数接收当前用户的会话上下文并返回布尔值,数据库引擎在每次查询时自动应用该过滤器。具体而言,管理员创建一个接收列值作为参数的SQL UDF(用户定义函数),然后通过ALTER TABLE语句将其注册为表的行过滤器。当任何用户查询该表时,查询优化器会在逻辑执行计划中自动注入该过滤函数作为WHERE条件。这一过程发生在查询编译阶段,对Photon引擎和Spark SQL引擎都透明支持。Photon是Databricks自研的向量化查询引擎,使用C++编写,专门针对Delta Lake上的分析查询进行了深度优化。与传统的Spark SQL基于JVM的执行引擎相比,Photon通过利用现代CPU的SIMD(单指令多数据流)指令集、列式内存布局和自适应执行策略,在TPC-DS基准测试中实现了数倍的性能提升。在RLS场景中,Photon引擎能够将行过滤条件高效地融入向量化执行管道,避免逐行评估过滤函数的开销,使行级安全策略对查询性能的影响降至最低。从性能角度看,RLS过滤条件可以被下推(Predicate Pushdown)到存储层,利用Delta Lake的分区裁剪和数据跳过优化,避免全表扫描带来的性能开销,使得RLS在千亿行级别的大表上依然能保持可接受的查询延迟。这种机制对上层应用完全透明,无需修改任何查询语句。
对于AI/BI仪表盘嵌入场景,行级安全策略往往是兼顾成本效率与安全强度的最佳选择。
解决方案:构建端到端的嵌入安全链路
身份传递与嵌入令牌管理
实现每位观看者的数据隔离,第一步是将终端用户的身份可靠地传递到数据平台。常见做法是由应用后端在生成嵌入令牌(embedding token)时,携带经过验证的用户身份信息或租户标识。
嵌入令牌是一种服务端生成的短时效凭证,通常基于JWT(JSON Web Token)或类似标准实现。JWT由三部分组成:Header(声明签名算法,如RS256或HS256)、Payload(携带身份声明和元数据)和Signature(通过密钥对前两部分进行数字签名)。在嵌入令牌场景中,服务端使用私钥对令牌签名,Databricks平台使用对应的公钥验证签名完整性,从而确保令牌内容未被篡改。值得注意的是,JWT的Payload部分默认仅进行Base64编码而非加密,因此不应在其中放置高度敏感的信息(如密码),但身份标识、租户ID和权限范围等声明是安全的。令牌的exp(过期时间)和nbf(生效时间)字段共同约束了令牌的有效窗口,配合令牌刷新机制可以在安全性与用户体验之间取得平衡。在实际生产环境中,令牌刷新通常采用静默刷新(Silent Refresh)模式:在令牌到期前的一个窗口期内(例如到期前2分钟),嵌入SDK自动向后端发起刷新请求,后端验证用户会话仍然有效后签发新令牌,整个过程对用户透明无感。如果用户会话已失效,刷新请求将被拒绝,嵌入组件可以优雅地引导用户重新认证。
其核心流程是:应用后端在用户发起仪表盘查看请求时,向Databricks API发出令牌签发请求,将用户的身份标识、租户ID、权限范围等声明(claims)编码进令牌中,并设置较短的过期时间(通常为几分钟到几十分钟)。前端拿到令牌后用于初始化嵌入组件,Databricks平台在收到请求时解析令牌中的身份信息并据此执行权限校验。这种机制确保了身份断言由受信任的服务端完成,前端无法伪造或篡改权限声明。
这里有一条铁律:身份传递必须发生在受信任的服务端,绝不能让前端或用户可控的参数决定其数据访问范围。任何暴露在客户端的过滤逻辑都应被视为不可信。
借助Databricks Unity Catalog实现平台级安全
Databricks等现代数据平台提供了Unity Catalog等数据治理工具,支持在数据资产层面定义精细的访问策略。Unity Catalog是Databricks于2022年正式推出的统一数据治理层,为Lakehouse中的所有数据资产(表、视图、模型、文件等)提供集中式的元数据管理、访问控制和审计能力。它采用三层命名空间结构(Catalog → Schema → Table),支持基于ANSI SQL标准的GRANT/REVOKE权限模型。Unity Catalog的推出标志着Databricks从计算平台向完整数据治理平台的战略升级。在Unity Catalog之前,Databricks依赖Hive Metastore进行元数据管理,每个Workspace维护独立的元数据存储,跨Workspace的数据共享和统一权限管理极为困难。Unity Catalog引入了账户级(Account-level)的元数据管理,使得多个Workspace可以共享同一套数据资产和权限策略。其开放架构设计还支持管理非Databricks生态的外部数据源,包括通过Lakehouse Federation连接PostgreSQL、MySQL、Snowflake等外部系统的数据。2024年Databricks将Unity Catalog开源,进一步巩固了其作为开放数据治理标准的行业定位。
在行级安全方面,Unity Catalog支持通过动态视图(Dynamic Views)或行级过滤函数来实现——开发者可以定义一个SQL函数,该函数根据current_user()或session变量中的身份信息动态决定哪些行对当前用户可见。列级安全则通过列掩码(Column Masking)实现,可以对敏感字段进行脱敏或隐藏处理。列掩码函数的定义方式与行过滤器类似——管理员创建一个SQL UDF,根据用户身份决定返回原始值还是经过脱敏处理的值(如将身份证号显示为***-****-1234),然后通过ALTER TABLE SET COLUMN MASK语句将其绑定到特定列上。所有访问行为都会被记录到审计日志中,便于合规审查和安全溯源。Unity Catalog的审计日志通过与云平台的日志服务(如AWS CloudTrail、Azure Monitor)集成,提供了不可篡改的访问记录,支持按用户、按资产、按时间维度进行查询和告警配置。
将安全策略与用户身份绑定后,无论用户通过何种途径访问数据,底层平台都会自动执行一致的权限校验。这种"安全前置到数据治理层"的思路,相比在应用层层层设防,具备更强的一致性和防御纵深。即便应用层出现漏洞,数据平台仍然是最后一道坚固防线。
架构设计:安全应内建于系统而非事后修补
纵深防御的三层防护体系
健壮的嵌入式仪表盘安全体系应遵循纵深防御(Defense in Depth)原则,从外到内建立多重保护。纵深防御是源自军事战略的信息安全理论,由美国国家安全局(NSA)在网络安全领域推广应用。其核心理念是:不依赖任何单一的安全机制,而是在系统的不同层级部署多重独立的防护措施,使攻击者即使突破某一层防线,仍需面对后续层级的阻拦。这一原则也与零信任(Zero Trust)安全模型高度契合——永远不默认信任,始终验证。零信任架构由Forrester Research分析师John Kindervag于2010年提出,其核心假设是网络边界内外都不存在可信区域,每个访问请求都必须经过身份验证、授权和加密。Google的BeyondCorp项目是零信任架构的标志性工业实践,它取消了传统VPN的网络边界概念,改为基于设备信任状态和用户身份进行逐请求的访问决策。在嵌入式仪表盘场景中,零信任思维要求我们不仅仅在网络入口处设防,而是在每个数据访问点都执行独立的身份验证和权限校验。
具体到嵌入式仪表盘场景,三层防护体系如下:
- 应用层:验证用户登录状态与会话有效性,确保请求来源合法。这一层通常依赖OAuth 2.0、OpenID Connect等标准认证协议,结合CSRF防护和请求来源校验,防止未授权的访问请求进入系统。OAuth 2.0是授权框架的行业标准,定义了四种授权模式(授权码、隐式、密码凭证、客户端凭证),其中授权码模式配合PKCE(Proof Key for Code Exchange)扩展是当前Web应用的最佳实践。PKCE通过在授权请求中引入动态生成的code_verifier和code_challenge参数,有效防止了授权码拦截攻击,即使在无法安全存储客户端密钥的公共客户端(如单页应用)中也能保证安全性。OpenID Connect(OIDC)是构建在OAuth 2.0之上的身份认证层,增加了ID Token的概念,使应用不仅能获得访问令牌还能验证用户身份。在嵌入式仪表盘场景中,典型的认证流程是:终端用户在宿主应用中通过OIDC完成身份认证,应用后端获取ID Token后提取用户标识和租户信息,然后使用服务账号的OAuth客户端凭证调用Databricks API生成嵌入令牌。这种双层认证设计将用户认证(Authentication)和数据授权(Authorization)清晰分离,符合最小权限原则。CSRF(Cross-Site Request Forgery,跨站请求伪造)防护在嵌入场景中尤为关键:由于仪表盘运行在iframe中,攻击者可能构造恶意页面诱导用户浏览器向嵌入令牌生成接口发送伪造请求。常见防护措施包括将SameSite Cookie属性设置为Strict或Lax、在API请求中要求携带CSRF Token,以及验证HTTP Referer/Origin头。此外还需特别关注Clickjacking攻击——攻击者可能将合法嵌入页面覆盖在透明iframe之上诱导用户误操作,X-Frame-Options响应头和CSP的frame-ancestors指令是关键防线。
- 令牌层:在后端生成绑定用户身份的短时效嵌入令牌,防止令牌被盗用或滥用。令牌的短生命周期设计确保即使令牌被截获,攻击窗口也极为有限;同时,令牌中编码的身份声明由服务端签名保证不可篡改。在实践中,令牌安全还需要考虑令牌绑定(Token Binding)技术——将令牌与特定的TLS连接或客户端证书绑定,使被盗令牌在其他网络上下文中无法使用。此外,建议实现令牌撤销(Token Revocation)机制,当检测到异常访问模式时能够主动使已签发的令牌失效。
- 数据层:通过行级安全(RLS)和列级安全策略强制执行数据隔离,从根源上杜绝越权访问。这是整个安全链路中最关键的一环,因为它在数据引擎层面生效,对上层所有访问路径(API、SQL、仪表盘、AI查询)统一适用。
三层防护相互独立又彼此补充,任何单一层级的失效都不会直接导致数据泄露。
面向AI功能扩展的安全可扩展性
随着AI/BI能力持续增强,仪表盘将越来越多地集成自然语言查询、智能洞察推荐等功能。这意味着安全边界不仅要覆盖静态可视化图表,还需覆盖动态生成的查询请求。
当AI/BI仪表盘集成自然语言查询(Text-to-SQL)等功能时,安全边界面临全新挑战。Text-to-SQL技术利用大语言模型将用户的自然语言问题转化为结构化SQL查询,当前主流方案通常采用检索增强生成(RAG)架构,先检索相关的表结构和元数据信息,再由LLM生成SQL。RAG(Retrieval-Augmented Generation)通过将外部知识库的检索结果注入LLM的上下文窗口来增强生成质量。在Text-to-SQL场景中,RAG流程通常包括:首先将用户问题通过嵌入模型转化为向量,在包含表结构、列描述、示例查询的向量数据库中检索最相关的元数据片段,然后将这些片段与用户问题一起组装为提示词(Prompt)输入LLM生成SQL。在安全层面,RAG的检索阶段本身也需要受到权限控制——如果元数据检索未实施租户隔离,攻击者可能通过提问推断出其他租户的表结构和字段名称,为后续攻击提供信息基础。
传统仪表盘中,查询是预定义的,安全审计相对可控;但在自然语言交互模式下,用户的提问可能被大语言模型(LLM)转化为任意SQL语句,这引入了提示注入(Prompt Injection)和间接数据泄露等新型攻击向量。
安全风险主要来自两个方面:一是直接提示注入,用户在输入中嵌入恶意指令试图操纵SQL生成逻辑;二是间接信息推断,通过对比不同查询的返回结果推断出本不可见的数据特征(类似差分攻击)。差分隐私(Differential Privacy)是密码学和统计学交叉领域的一种数学框架,由Cynthia Dwork于2006年正式提出,其核心保证是:对数据集中任何单条记录的增删,不会显著改变查询输出的统计分布,从而使攻击者无法通过观察查询结果推断特定个体的信息。在BI场景中,差分隐私通常通过对聚合查询结果添加经过校准的随机噪声来实现,但在企业BI中的应用仍处于早期阶段,主要挑战在于平衡数据精度与隐私保护。
例如,攻击者可能通过精心构造的自然语言提问诱导模型生成跨租户查询——比如"显示所有客户的总收入"这样的提问,如果没有数据层面的安全约束,LLM可能生成不含tenant_id过滤条件的SQL语句。业界应对方案包括SQL白名单校验、查询结果的差分隐私处理,以及在LLM输出层增加SQL安全审计器,但这些应用层防护措施都具有被绕过的风险。更先进的方案还包括语义级SQL沙箱——在SQL执行前对生成的查询进行抽象语法树(AST)分析,检查是否包含跨Schema访问、DDL操作或聚合结果低于最小匿名化阈值(k-匿名性)等潜在风险模式,并在违规时拒绝执行或自动改写查询。
将安全策略统一到数据治理层,能让自然语言查询等AI功能天然继承既有的权限约束,避免因功能扩展而引入新的安全漏洞。无论LLM生成什么样的SQL,Unity Catalog的行级和列级安全策略都会在执行层面强制生效,从根本上阻断越权数据访问。这种"安全与查询生成解耦"的设计理念,是应对AI驱动的BI功能快速演进的关键架构保障。
结语
嵌入一个AI/BI仪表盘只是起点,为每位观看者提供安全、隔离、合规的数据视图,才是企业级应用的真正考验。安全不应是事后修补的行为,而应在架构设计之初就被纳入核心考量。
通过可靠的身份传递机制、Databricks Unity Catalog等平台原生治理能力以及纵深防御策略的有机结合,开发者才能在享受嵌入便利的同时,守住多租户环境下的数据安全底线。在AI能力持续渗透BI工具的今天,这种将安全锚定在数据治理层的架构思维,不仅适用于当前的嵌入场景,更为未来不可预见的功能扩展预留了坚实的安全基座。
核心要点
相关推荐
LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
开源视频生成模型 LTX2.5 本地部署实测:AMD 7900XTX 显卡在 Windows 11 环境下最低 8G 显存可运行,2 分钟生成 5 秒视频。附五套工作流对比与整合包、手动部署教程。
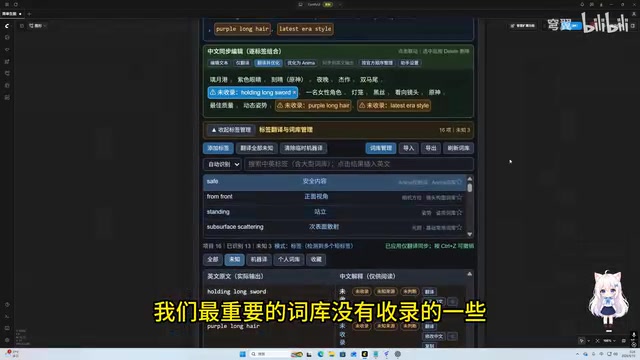
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。
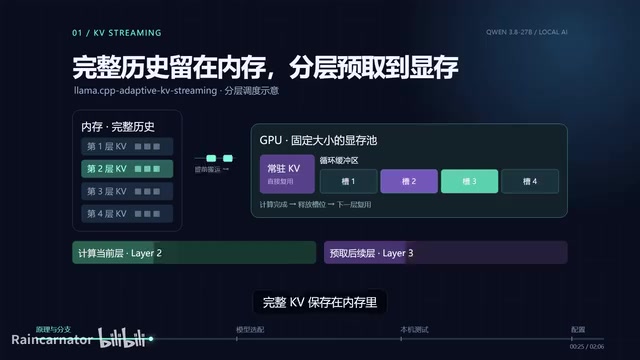
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。