ChatGPT不等于AI Agent:一张图看懂本质区别

ChatGPT止于回答,Agent通过思考-执行-观察循环自主完成目标任务。
文章区分了ChatGPT与AI Agent的本质差异:前者是对话模型,输出止步于回答;后者以目标为导向,通过“思考—执行—观察”的循环自主拆解并完成任务。Agent由三部分构成:LLM作为大脑负责推理决策,工具作为手负责影响真实世界,记忆作为日记本负责积累上下文,三者缺一不可。这一区分带来三重影响:评估标准从回答质量转向任务完成率,风险面因自主行动而扩大,产品形态从对话式助手迁移到任务执行体。文章最后指出,当前Agent落地的主要瓶颈不在模型能力,而在工具可靠性与权限边界。
ChatGPT不等于AI Agent:一张图看懂本质区别
很多人把ChatGPT和AI Agent混为一谈。YouTube创作者在"AI Agent系列Day 1"短片中用一个犀利的问题开场:"你是不是也觉得ChatGPT就是AI Agent?"答案是否定的——ChatGPT只负责"回答",而Agent负责"做事"。这个区分看似简单,却决定了我们如何理解下一代AI应用的形态。
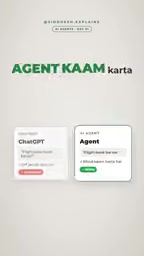
回答者与执行者的分水岭
ChatGPT的本质是一个对话模型:你问,它答。它擅长生成文本、解释概念、提供建议,但它的输出止步于"回答"这一动作。AI Agent则不同,它接收的是一个目标,而非一个问题。
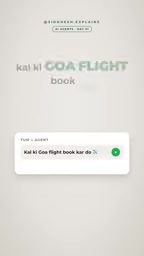
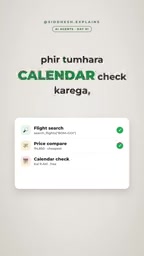
短片里举的例子很直观:你对Agent说"帮我订明天去果阿的机票",它不会只告诉你"可以去某某网站订",而是自己拆解任务——先搜索航班,再比价,然后检查你的日历,最后完成预订。整个过程无需你逐步指挥。
这种差异可以用一句话概括:ChatGPT是信息出口,Agent是行动主体。前者优化的是"说得对不对",后者优化的是"事情办没办成"。
思考—行动—观察:Agent的核心循环
Agent之所以能自主完成任务,靠的是一个不断重复的循环。短片将其拆解为三个动作:思考、执行、观察。
以订机票为例:Agent先思考"需要哪些步骤",然后调用搜索工具执行查询,观察到返回的价格和时刻后,再决定下一步是比价还是查看日历。这个循环持续运转,直到任务完成或遇到无法逾越的障碍。
这个机制的关键在于反馈。普通聊天模型一次生成就结束,而Agent会根据每次工具调用的结果调整后续策略——航班售罄就换一班,价格超预算就寻找替代方案。这种"边做边改"的能力,是它与静态问答系统的根本区别。
这种“思考—行动—观察”的循环源自控制论中的反馈回路思想,在AI领域常被称为ReAct(Reasoning and Acting)范式。ReAct的核心是让语言模型交替生成推理轨迹和动作指令,并将每次动作的环境反馈作为下一轮推理的输入。与一次性生成完整计划的静态方法不同,ReAct允许模型在信息不完整时动态修正路径,这正是Agent能够处理开放环境任务的理论基础。该范式最早由Shunyu Yao等人在2022年提出,此后成为构建工具调用型Agent的主流框架。
LLM是大脑,工具是手,记忆是日记本
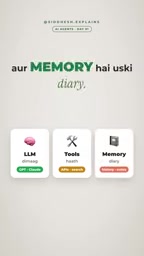
短片用一组比喻解释了Agent的构成,这组比喻相当准确:
- LLM是大脑:负责理解目标、拆解任务、做出决策。没有语言模型的推理能力,Agent就只是一个僵硬的脚本。
- 工具是手:搜索API、日历、支付接口、代码执行环境——Agent通过调用外部工具来影响真实世界。没有工具,它只能空想。
- 记忆是日记本:记录已经做过什么、得到了什么结果、用户的偏好是什么。没有记忆,Agent会在每一步重新开始,无法积累上下文。
这三者缺一不可。只有LLM没有工具,是ChatGPT;只有工具没有LLM,是传统自动化脚本;有了LLM和工具但没有记忆,Agent会在多步任务中迷失方向。
“工具”在技术实现上通常以函数调用(Function Calling)或工具调用(Tool Use)接口的形式存在。开发者用JSON Schema描述每个工具的名称、用途和参数,模型在推理时输出结构化的调用请求,由外部运行时执行后将结果返回给模型。OpenAI于2023年6月为GPT系列引入函数调用能力,Anthropic的Claude则通过“工具使用”协议实现类似机制。MCP(Model Context Protocol)是近年来出现的标准化尝试,旨在统一模型与各类外部工具、数据源之间的连接方式,降低为每个Agent单独编写适配器的工程成本。
为什么这个区分值得关注
理解ChatGPT与Agent的差异,不只是概念游戏。它直接影响我们如何评估和使用AI产品:
评估标准变了。 衡量聊天模型看的是回答质量,衡量Agent看的是任务完成率。一个Agent可能每一步推理都平淡无奇,但最终把事情办成了,这就是合格;反之,推理再漂亮,任务失败就是失败。
风险面扩大了。 聊天模型说错话,代价是误导;Agent做错事,代价可能是真的订错机票、发错邮件、改错文件。自主性越强,对权限控制和结果校验的要求就越高。
产品形态在迁移。 从"对话式助手"到"任务执行体",行业正在把语言模型嵌入到具体工作流中。订票、写代码、做调研、处理客服工单——这些场景的共同点是:目标明确、步骤可拆、结果可验证,恰好是Agent擅长的领域。
一个容易忽略的前提
短片中Agent订机票的例子听起来流畅,但现实中这类任务对系统的要求并不低:它需要可靠的航班搜索接口、结构化的日历数据、安全的支付授权,以及处理异常情况的能力。任何一环缺失,循环就会卡住。
这也是当前Agent落地的主要瓶颈——不是模型不够聪明,而是可调用的工具不够可靠、权限边界不够清晰。把LLM当大脑很容易,给它配一双靠谱的手、一本记得住的日记本,才是工程上的难点。
回到最初的问题:ChatGPT是AI Agent吗?不是。它是Agent的大脑组件之一,但离"能自己把事情做完"还差着工具、记忆和一个持续运转的执行循环。
Agent在执行真实操作时所需的安全授权,目前主要依赖OAuth等令牌机制和细粒度的权限范围(scope)控制。例如访问用户日历时只申请只读权限,发起支付时要求二次确认或设置金额上限。行业实践中常见的防护措施还包括:动作执行前的人工审批环节、沙箱环境隔离、操作日志审计以及可回滚的事务设计。这些机制针对的正是Agent自主性带来的“做错事”风险——模型可能因幻觉调用了不该调用的工具,或在参数理解偏差下执行了破坏性操作。权限最小化原则与结果可验证性是当前Agent工程规范的核心共识。
相关推荐
Gemini 4 Argonne 入门教程:从建站到Agent的实战
Gemini 4 Argonne 完整入门教程:演示在 Google AI Studio 一句话构建卡路里追踪应用、用超长上下文审阅 10 页技术文档、在 Anti-Gravity 作为编程 Agent 开发浏览器游戏,并讲解 API Key 获取、定价与各平台订阅门槛。
Cursor、Claude Code、Copilot怎么选?场景对照指南
Cursor、Claude Code、GitHub Copilot怎么选?按日常编码、大重构长任务、团队绑定现有IDE三种场景对照选择,附常见选型误区与组合使用建议。

DB Chat:用自然语言对话PostgreSQL,AI自动生成SQL
dbchat 让用户用自然语言对话 PostgreSQL 数据库,AI 代理自动生成 SQL 并返回实时结果。本文解析其 MCP Server + Next.js + AWS 全链路架构与防幻觉护栏设计。