Claude 4.5 vs Gemini 3 Pro:编程能力全面对决
Claude 4.5编程实战领先,Gemini 3 Pro知识推理占优,五大基准测试判定技术性平局。
基于ARC-AGI-V2、SWE-Bench、Terminal Bench 2.0、GPQA和MMLU五大基准测试,Claude 4.5在三项编程实战测试中均领先Gemini 3 Pro约5个百分点,展现出更强的抽象推理、Bug修复和系统交互能力;而Gemini 3 Pro在GPQA专业推理和MMLU通用知识测试中反超。最终判定为技术性平局,开发者应根据任务场景灵活选择工具。
引言:AI编程领域的巅峰对决
在AI大模型竞争日趋白热化的当下,编程能力已成为衡量模型实力的核心战场。近期,Claude Opus 4.5与Gemini 3 Pro在多个权威基准测试中展开了正面交锋,结果颇为耐人寻味——这并非一场一边倒的碾压,而是一场各有所长的技术博弈。
本文将基于ARC-AGI-V2、SWE-Bench、Terminal Bench 2.0、GPQA和MMLU五大基准测试的数据,深入分析两大模型在编程实战与知识推理两个维度上的真实表现。
评测体系:五大基准测试全面考察
此次对决采用了五个极具代表性的基准测试,覆盖了从抽象推理到实战调试的完整能力谱系。理解这些测试的设计逻辑,是读懂评测结果的前提。
- ARC-AGI-V2:考察面对全新问题时的「流体智力」,类似于让程序员从零设计一个从未见过的API
- SWE-Bench:在真实开源项目中定位并修复Bug的能力,堪称「Bug猎杀挑战」
- Terminal Bench 2.0:系统交互与脚本编写的终极考验
- GPQA:研究生级别专业问题的回答能力
- MMLU:横跨57个学科的通用知识广度测试
这套评测体系的设计思路值得肯定:它不仅关注模型「会不会写代码」,更关注模型在真实开发场景中的综合表现。
Claude 4.5编程实战表现:三项测试全面领先
ARC-AGI-V2:抽象推理能力的较量
ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence)由AI安全研究员François Chollet于2019年提出,其设计初衷是测量机器的「流体智力」——即在没有先验知识的情况下,面对全新问题的推理与泛化能力。与传统基准测试不同,ARC-AGI的题目刻意规避了可通过记忆训练数据来解答的模式,每道题都要求模型从少量示例中归纳出抽象规则并加以应用。V2版本在此基础上进一步提升了任务的组合复杂度与视觉空间推理难度,使其成为目前最难被「刷榜」的基准之一。值得注意的是,人类在该测试上的平均得分约为85%,而顶尖AI模型长期徘徊在30%-60%区间,这一差距本身就揭示了当前大模型在真正意义上的「举一反三」能力上仍存在显著瓶颈。
在这项流体智力测试中,Claude 4.5以超过6个百分点的优势拿下首局。这个差距在AI基准测试中相当显著,意味着在面对完全陌生的编程挑战时,Claude展现出了更强的创造性问题解决能力。
这项能力的实际意义在于:当开发者需要设计全新的系统架构、解决前所未有的技术难题时,Claude可能会提供更具创新性的方案。对于那些经常需要「从0到1」的技术团队来说,这个优势尤为关键。
SWE-Bench实战评测:真实世界的Bug修复效率
SWE-Bench(Software Engineering Benchmark)由普林斯顿大学研究团队于2023年发布,其核心创新在于将评测场景从「写一段代码」升级为「在真实开源项目中解决GitHub Issue」。测试集从Django、Flask、NumPy、Scikit-learn等主流Python开源项目中抽取了数千个真实Bug报告,要求模型在完整代码库上下文中定位问题根源并生成可通过单元测试的补丁。这种设计使得模型无法依赖孤立的代码片段生成能力,而必须具备代码库导航、跨文件依赖理解和回归测试意识等综合工程素养。业界普遍将SWE-Bench Verified(经人工验证的子集)视为衡量AI「能否真正替代初级工程师」的关键指标。
在这项真实项目Bug修复测试中,Claude再次领先约4.7个百分点。表面上看,5%的差距似乎不大,但放到实际开发场景中,这意味着每修复20个Bug,Claude就能比对手多成功解决一个。
日积月累下来,这直接转化为开发效率的提升——更少的加班调试时间,更快的项目交付节奏。对于每天与代码打交道的开发者而言,这是一个非常实际的生产力差异。
Terminal Bench 2.0:系统交互与运维的硬实力
Terminal Bench 2.0专注于评测AI模型在真实终端环境中完成系统级任务的能力,涵盖Shell脚本编写、进程管理、文件系统操作、网络配置、包管理以及多步骤自动化流程等场景。与纯代码生成测试不同,该基准要求模型在具有状态持久性的交互式环境中连续执行多条命令,并能根据中间输出动态调整后续操作策略。这种「感知-决策-执行」的闭环能力对于DevOps、CI/CD流水线搭建和云基础设施管理等场景至关重要。随着AI Agent和自动化运维工具的兴起,Terminal Bench 2.0的评测维度正在从「能否写出正确命令」向「能否在复杂系统环境中完成端到端任务」演进。
在命令行任务处理方面,Claude的成功率高出5.1%。这意味着在应用部署、服务器管理等运维场景中,Claude生成的脚本出错概率更低。
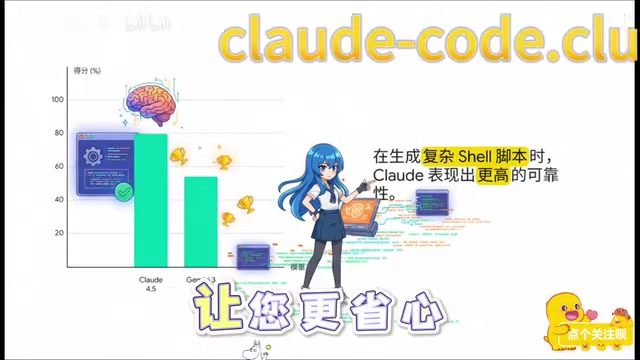
综合三项编程实战测试来看,Claude 4.5在核心软件工程任务上建立了稳定的领先优势,平均领先幅度约5个百分点。这不是偶然的波动,而是系统性的能力差异。
Gemini 3 Pro知识推理反击:学术与广度双重优势
GPQA评测:专业深度的学术推理
GPQA(Graduate-Level Google-Proof Q&A)由纽约大学研究团队设计,其名称中的「Google-Proof」揭示了这套测试的核心野心:题目难度之高,以至于即便允许使用搜索引擎,非专业人士的答题准确率也仅约34%,而领域专家的平均得分约为65%。测试题目覆盖生物学、化学、物理学等自然科学领域的前沿专业问题,每道题均经过博士级专家的多轮审核与验证。GPQA的设计哲学在于区分「检索式知识」与「推理式理解」——前者可以通过大规模预训练习得,后者则要求模型真正内化学科的底层逻辑并进行多步推断。
然而,比赛远未结束。进入知识整合领域后,Gemini 3 Pro发起了强有力的反击。在GPQA研究生级别专业问题测试中,Gemini得分高出近5个百分点。Gemini在此项测试中的领先,在一定程度上反映了其在科学推理链路构建上的训练优化方向——当任务涉及深度学术研究和专业推理时,Gemini就像一位经验丰富的学者,能够更准确地处理复杂的专业知识问题。
MMLU测试:知识广度的全面覆盖
MMLU(Massive Multitask Language Understanding)由加州大学伯克利分校于2020年发布,包含来自57个学科的约15,000道多项选择题,涵盖数学、法律、医学、历史、计算机科学等几乎所有主要知识领域。它曾是衡量大语言模型综合知识水平的「黄金标准」,推动了整个行业对模型知识广度的系统性关注。值得注意的是,随着顶尖模型的得分普遍突破90%,MMLU的区分度正在下降,部分研究者指出其多项选择题形式存在「选项偏差」问题,且高分可能部分来自训练数据污染。尽管如此,MMLU在横向对比中仍具参考价值,尤其是在评估模型知识覆盖的均衡性方面。
在横跨57个学科的通用知识测试中,Gemini依然保持领先。虽然差距不大,但这再次证明了在知识的广度和深度维度上,Gemini仍然是难以撼动的「知识库」。Gemini在此项测试中的持续领先,与其多模态训练数据的广泛覆盖策略密切相关。
这两项测试揭示了一个重要事实:Gemini在知识密集型任务上的优势同样不可忽视。当你需要模型扮演「百科全书」或「学术顾问」的角色时,Gemini的表现更为可靠。
最终判定:技术性平局背后的选择策略
综合五项测试的结果,这场对决的最终判定是技术性平局——没有哪一方被彻底击倒,双方各自在擅长的领域建立了优势。
Claude 4.5 vs Gemini 3 Pro实用选择指南
根据测试数据,可以提炼出一个清晰的选择策略:
选择Claude 4.5的场景:
- 日常编码与调试工作
- 需要创新性解决方案的新项目
- 系统部署与运维脚本编写
- 大型代码库的Bug定位与修复
选择Gemini 3 Pro的场景:
- 深度学术研究与专业分析
- 海量文档资料的总结与整合
- 跨学科知识查询与推理
- 需要广泛背景知识支撑的任务
深层思考:打造最强AI编程工具箱
这场对决给我们最大的启示是:AI工具的选择已经从「找一个最好的」转变为「打造一个最强的工具箱」。
对于核心软件开发工作——编码、调试和抽象推理,Claude 4.5确实暂时领先了一步。但在知识整合与专业推理领域,Gemini 3 Pro依然占据优势地位。真正的赢家,是那些懂得根据不同任务场景灵活切换工具的开发者。
当然,在AI领域瞬息万变的竞争格局中,今天的领先优势可能很快就会被追平甚至反超。两大模型都在快速迭代,下一轮的「冠军争夺战」或许就在不远的将来。保持关注,持续学习,才是应对这个时代最好的策略。
核心要点
- Claude 4.5在三项编程实战测试(ARC-AGI-V2、SWE-Bench、Terminal Bench 2.0)中均领先Gemini约5个百分点,在核心软件工程任务上优势明显
- Gemini 3 Pro在知识整合领域发起反击,GPQA专业推理测试领先近5个百分点,MMLU通用知识测试同样保持领先
- 最终判定为技术性平局:Claude擅长编码调试与创新性问题解决,Gemini擅长深度学术研究与跨学科知识推理
- 实用选择策略:编程实战选Claude,知识研究选Gemini,关键在于根据任务场景灵活搭配工具
- AI编程工具的竞争格局仍在快速变化,开发者应关注构建多元化的AI工具箱而非押注单一模型
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。