#大模型对比
共 24 篇相关文章

Claude的宪法与DeepSeek的自由:AI教育方式之争
B站视频用“中式教育”比喻Claude的宪法AI与DeepSeek的开源自由,解析AI安全对齐与开放生态的路线分歧、审查机制及地缘限制。
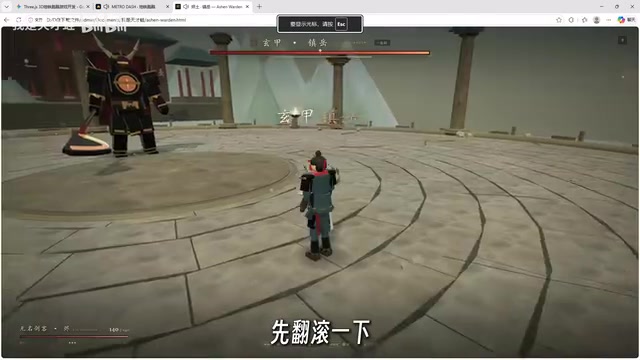
DeepSeek 4.1 Flash对决Gemini 4 Argon:六大3D实测谁更强?
B站UP主实测DeepSeek 4.1 Flash与Gemini 4 Argon六大3D能力:跑酷游戏、Boss战、照片生成3D世界、NPC路径规划、文字动画与分镜动画。双方各胜三题,DeepSeek建模扎实,Gemini交互流畅,谁才是性价比之王?

ChatGPT、Claude、Gemini 十月对决:GPT-6 与 Claude 5.5、Gemini 4 怎么选
GPT-6、Claude 5.5 与 Gemini 4 Argon 在十月密集发布,本文梳理三家模型阵容、公开基准数据、订阅与 API 定价,并按编码、写作、生态整合等场景给出选择建议。

实测Claude Opus 5.5、GPT-6 Astra与Gemini 4 Argon:三项目定高下
实测Claude Opus 5.5、GPT-6 Astra与Gemini 4 Argon在3D游戏、Blender建模与Notion克隆三个真实编码项目中的表现:基准分数接近,真实差距被放大,Opus质量最高、Astra性价比最佳、Argon尚未同档。

四大AI模型混战:Opus 5.5、Gemini 4 Argon、Muse Wonder谁赢了?
Meta Muse Wonder、Google Gemini 4 Argon、Anthropic Opus 5.5与OpenAI GPT-6 Astra四大模型混战,三张榜单三个冠军。本文拆解各模型的真实强项、成本、幻觉率与作弊争议,给出客观选型建议。
Gemini 4 Argon 对比 GPT-6 Astra:19项基准测试深度解析
Gemini 4 Argon 在 19 项官方基准测试中以 14 胜 4 负 1 平击败 GPT-6 Astra,但 GPT-6 包揽所有终端类测试胜利。深度解析知识工作、长上下文、编程与计算机操作各维度的真实差距,给出选型建议。

Muse Wonder对比Claude Opus 5.5:同价不同命,任务分工才是关键
Muse Wonder与Claude Opus 5.5 API定价完全相同(4/20/0.2美元每百万token),但基准表现和适用场景截然不同。独立评测Opus智力指数58比52领先,Wonder在SWE-Marathon和法律任务反超,每任务成本4.52美元低于5.98美元。本文通过规格、基准、成本、生态和安全五个维度给出任务分配建议。
Muse Wonder 对比 Claude Opus 5.5:同价不同命,谁更适合你的工作流
Muse Wonder 与 Claude Opus 5.5 定价完全相同:4美元输入、20美元输出、0.20美元缓存,均为100万上下文。但基准测试、每任务成本和工具生态差异显著。本文从规格、基准、成本结构、工具生态和数据条款五个维度全面对比,给出具体任务路由建议。
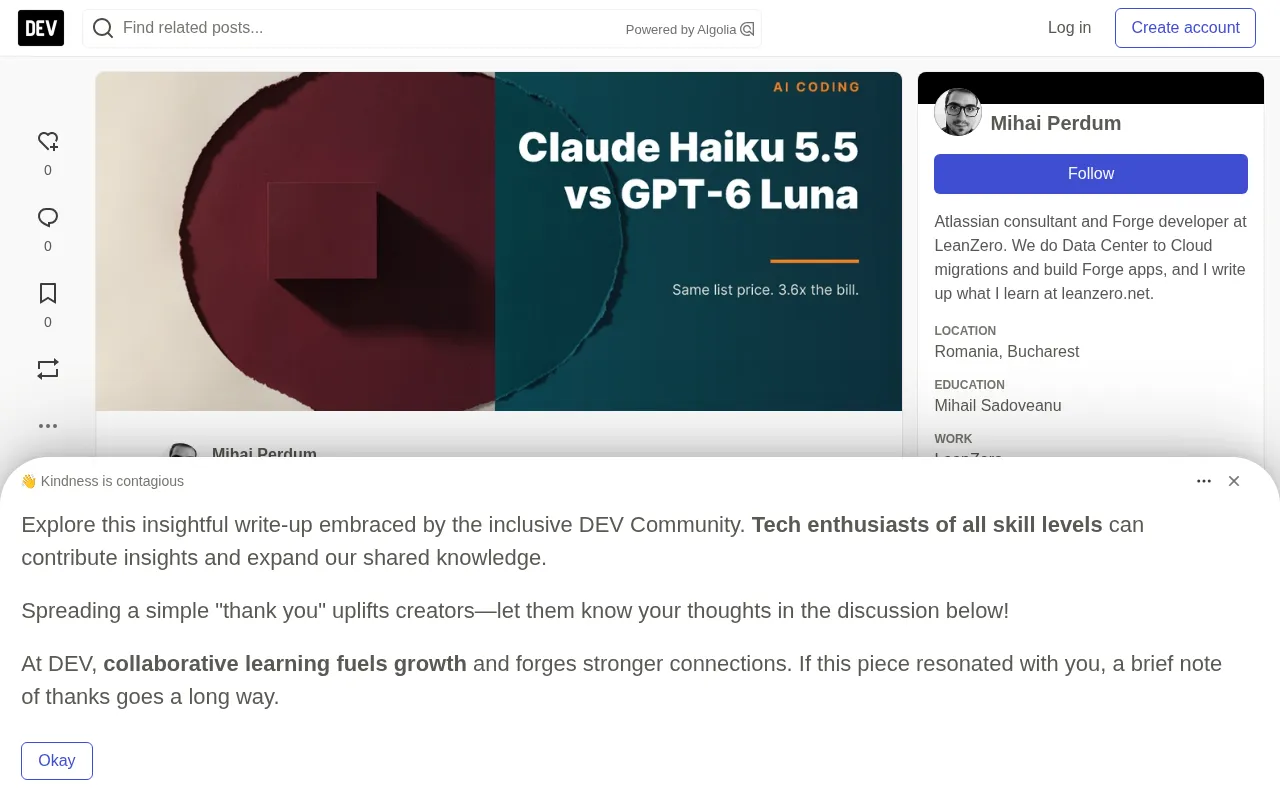
Claude Haiku 5.5 对决 GPT-6 Luna:同价不同费的智能体编码实测
LeanZero 用两套智能体编码基准实测 Claude Haiku 5.5 与 GPT-6 Luna:标价完全相同,账单却相差 3.6 倍。Haiku 两战全胜,Forge 上 0.9661 对 0.395,关键在 10 万 token 价格台阶与历史回填失败。

GPT-6与Claude Opus 5.5同台辩论:为合群该迎合别人吗?
B站赛博辩论局让GPT-6 Sol与Claude Opus 5.5同台辩论「为合群是否要迎合别人」。本文复盘正反方立论、自由辩论与评委裁决,并分析两大模型在概念辨析与逻辑推演上的真实表现。

实测120道选型问题:ChatGPT、Perplexity与Gemini推荐重合率仅14%
一项Reddit实测用120道工具选型问题对比ChatGPT、Perplexity和Gemini,发现42%的问题四个引擎推荐零重合,中位重合率仅0.14。本文解析AI在选型推荐上的一致性问题及其对采购决策的启示。
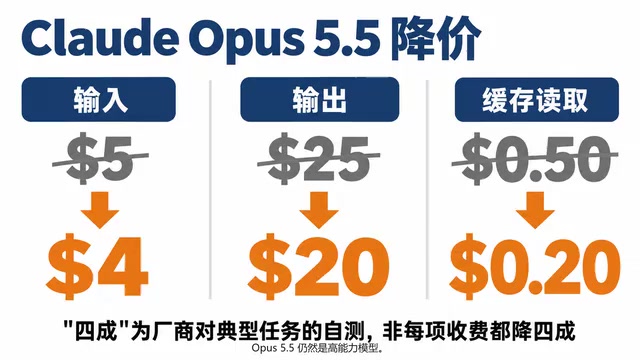
Claude Opus 5.5对比GPT-6:同样的钱能办成多少事?
Claude Opus 5.5对比GPT-6 Sol/Luna深度解析:两家API价格全面下调,Opus任务成功率40%但单次成本更高,Sol更省却在知识工作上退步。同样的月费究竟能办成多少合格的事?

GPT-6 Sol/Luna 实测对比 DeepSeek:文章排版还原谁更强
GPT-6 Sol、GPT-6 Luna 与 DeepSeek V4.1 实测对比,围绕文章排版复刻任务从速度、token 消耗、还原度和平台样式保留四个维度评测,看看这几款热门大模型的真实生产力表现谁更强。

GPT-6 Sol、Claude Opus 5.5、Grok 4.7:前沿模型价格战全解析
Grok 4.7、Claude Opus 5.5、GPT-6 Sol 三款前沿大模型48小时内接连发布并打响价格战。本文详解各家输入输出报价、缓存定价策略,并给出不同工作负载下的API选型决策指南。

Grok 4.7 vs MiMo V2.6 Pro/Flash 三模型实测对比
Grok 4.7 与小米 MiMo V2.6 Pro/Flash 三模型横向实测:涵盖 3D 建模、游戏交互、Web 页面、折纸与写作任务。Grok 4.7 Token 消耗大速度慢,MiMo Flash 意外强于 Pro,性价比突出。
Claude与GPT操控机械臂绘画对决:谁更胜一筹?
一位开发者让Claude Fable 5.1与GPT 6 Astra分别操控同一台SO-101机械臂完成单色填充绘画任务,对比两款大模型在具身智能与动作控制上的表现。本文解析实验设计、评测维度及其对AI具身能力评估的启示。
GitHub项目速览:GPT-5.4与Claude Opus 4.6对比资料的价值几何
GitHub 出现 GPT-5.4 与 Claude Opus 4.6 对比资料项目 loki-mamv/gpt54-vs-opus,本文分析该项目现状,并探讨如何理性看待第三方大模型对比资料及模型选型建议。
 产品体验
五大AI模型做游戏实测对比:零基础编程谁最强
实测DeepSeek R1、Claude Sonnet 3.7、ChatGPT o3 Mini、Grok 3、通义千问五大AI模型零基础做贪吃蛇游戏,从基础功能到自定义弹球机制,全面对比各模型编程能力与设计感,帮你找到最适合AI游戏开发的工具。
 产品体验
AI编程实测:GPT-5、Gemini 2.5 Pro、Kimi K2、Grok4爬虫任务全部失败
使用Cursor IDE对GPT-5、Gemini 2.5 Pro、Kimi K2和Grok 4进行静态网页爬虫实测对比,四款顶级大模型全部失败,Claude以126页成绩领先。深度分析各模型失败原因及对开发者的启示。
 产品体验
Claude Opus 4.8深度解析:判断力、诚实度与性价比全面评测
深入解析Claude Opus 4.8的核心升级:判断能力提升、诚实反馈机制优化、Fast Mode成本降至三分之一。对比DeepSeek、GPT-5.5等竞品,分析Opus 4.8在AI编程和长上下文推理场景中的实际价值。