GPT-6 Sol/Luna 实测对比 DeepSeek:文章排版还原谁更强

GPT-6 Sol在公众号排版复刻测试中以速度快、成本低、还原度高夺得综合第一。
本文以「公众号排版复刻」为测试场景,横向对比了 GPT-6 Sol、GPT-6 Luna 与 DeepSeek V4.1 三款模型的实际表现。测试涵盖速度、token 消耗、排版还原度及平台样式保留四个维度。结果显示,GPT-6 Sol 在速度和 token 消耗上全面领先,排版还原度也最高,是综合最均衡的选择;Luna 降价明显,适合高频成本敏感场景,但指令遵循出现小失误;DeepSeek V4.1 速度和消耗垫底,但在最终样式保留环节追平 Sol。三款模型在多图排版上均存在明显短板,反映出当前大模型处理复杂视觉布局的普遍局限。
近期大模型市场掀起新一轮价格战。据B站UP主翔子的实测分享,Anthropic 发布了 Opus 5.5,性能相比上一代大幅提升且价格几乎腰斩;OpenAI 紧随其后推出 GPT-6 Sol 与 GPT-6 Luna 两个模型,性能提升幅度虽不及 Anthropic,但降价力度更猛——价格据称仅为上一代模型的十分之一。
本文以一场围绕「文章排版复刻」的真实测试为切入,横向对比 GPT-6 Sol、GPT-6 Luna 与 DeepSeek广告 V4.1 的实际表现,看看这几款热门模型在具体生产力场景中的差距究竟有多大。
测试方法:一场排版还原的硬仗
这次评测的核心任务并不是常规的知识问答,而是更贴近实际工作流的排版复刻。测试者先给三个模型同一篇已排版好的文章,让它们学习并复刻这套排版风格,再把这套风格套用到一篇未经排版的原文上。
评测维度相当具体:一是排版还原度,看模型能否复现原文的色调、装饰元素、文字间距和多图布局;二是任务执行速度;三是 token 消耗;四是最关键的落地环节——能否把成品复制粘贴到公众号平台后样式完整保留。三个模型均运行在测试者自建的自动排版 skill 中,思考强度均选择较高档位(Sol 与 DeepSeek 选 Max,Luna 选 High),以贴近日常使用习惯。
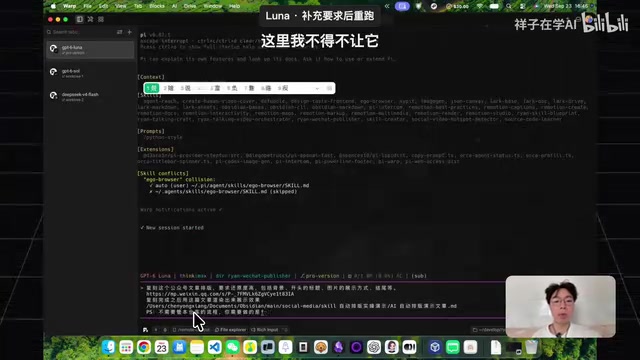
值得一提的是,Luna 在测试初期出现了小状况:它没有严格按照提示词执行,而是读取了 skill 里的其他要求并直接套用了现成模板,导致测试者不得不让它重新开始,并在提示词中追加补充说明才走上正轨。这个细节其实反映出模型在复杂指令环境下对上下文的取舍差异。
「排版复刻」在公众号生产流程中是一项高频但繁琐的任务:运营者通常需要维持品牌视觉一致性,将同一套色彩、字距、分割线和图文布局风格反复套用到新内容上。传统做法依赖人工逐段调整,而将这一过程交给大模型自动化处理,要求模型不仅能理解自然语言指令,还需具备对 HTML/CSS 样式代码的精确生成与还原能力。测试中使用的「自动排版 skill」本质上是一套预设工作流,将用户提供的范例文章和待排版原文打包送入模型,由模型输出可直接粘贴至公众号编辑器的富文本或 HTML 代码。这类任务对模型的代码生成精度、长上下文理解和指令遵循能力均有较高要求,与通用问答场景存在显著差异。
速度与成本:Sol 全面领先
速度层面三者拉开了明显差距。GPT-6 Sol 最快,体感只需四五分钟就完成任务,拿下满分五分;Luna 耗时约为 Sol 的三倍,接近二十分钟,得三分;DeepSeek 最慢,花了差不多半小时,仅得两分。
在 token 消耗上,排序与速度基本一致。Sol 消耗最低,得五分;Luna 的消耗略超 Sol 的两倍,得 3.5 分;DeepSeek 比 Luna 还要更高一些,得三分。
这一结果与前文提到的价格趋势形成有趣对照:OpenAI 虽然在性能提升上不算激进,但把 Sol 打磨成了一个「又快又省」的模型。对于高频调用的生产场景,速度和 token 消耗直接换算成实际成本,Sol 的效率优势会被进一步放大。
还原度:Sol 观感最佳,多图排版是共同短板
排版还原是这次测试最见功力的环节。GPT-6 Sol 在整体色调、装饰元素和文字间距上复刻得相当到位,唯独多图排版与原文差距较大,综合得四分。
GPT-6 Luna 的整体观感不错,但段落之间加了不少分割线,导致文章整体显得比较碎,加上多图同样没还原好,得三分。DeepSeek 的观感也可以,但开头莫名出现了一个省略号(可能是本应放置文字或元素却未显示),多图排版也没做出来,得三分。
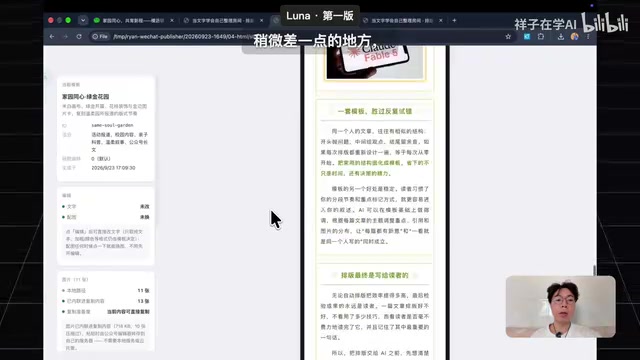
三个模型在多图排版上不约而同地翻车,说明这仍是当前大模型处理复杂视觉布局的普遍难点。在测试者要求它们统一返工修复后,情况有所改善:Sol 不仅做出了多图排版,图片旁的装饰性文字也补齐了;Luna 和 DeepSeek 虽然把多图排版做了出来,但都没能加上装饰性文字。这个补测环节进一步印证了 Sol 在细节完整度上的领先。
多图排版之所以成为大模型的共同短板,与其底层实现机制密切相关。公众号的多图并排布局通常依赖 CSS Flexbox 或 Grid 布局,以及特定平台对内联样式的支持限制。大模型在生成此类代码时,既需要推断原文的视觉意图,又要在平台样式白名单的约束下选择兼容写法,任何一处属性不被支持都可能导致图片堆叠或错位。此外,图片旁的装饰性文字往往需要绝对定位或浮动布局,这在公众号受限的渲染环境中更难稳定复现。因此多图排版考验的不只是模型的代码能力,也是它对目标平台渲染规则的「隐性知识」储备。
落地环节:粘贴到平台后的样式保留
再好的排版,如果复制到平台后样式崩了也是白搭。这一项 Sol 表现最稳,复制到平台后样式基本完整保留,得五分。
DeepSeek 同样把样式基本保留下来,得五分——在这个环节反倒追平了 Sol。Luna 整体看起来还行,但结尾部分有些样式乱掉,得四分。
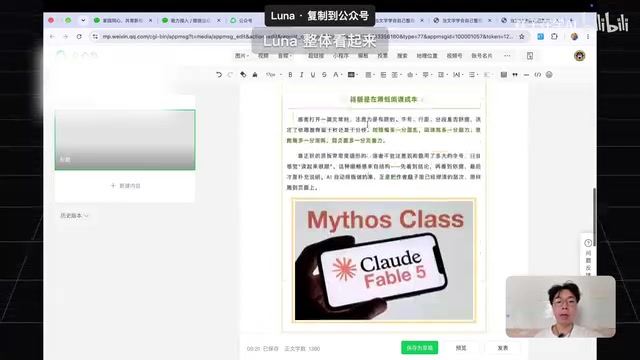
有意思的是,DeepSeek 虽然在速度和 token 上垫底,但在样式保留这个最终落地环节上并不逊色。对于不那么在意执行速度、更看重结果稳定性的用户来说,这仍是一个可参考的选择。
综合评价:Sol 是当前最均衡的选择
综合速度、成本、还原度和落地四个维度,GPT-6 Sol 无疑是这次测试的赢家。它性能相比上一代有所提升,执行速度更快,价格还有下降——即便是 Plus 用户,也完全可以把它当作日常主力模型使用。
Luna 这次的价格降幅同样可观,如果是高频使用场景,性价比也很高,适合作为成本敏感型任务的备选。DeepSeek V4.1 在样式保留上表现扎实,但速度和 token 消耗偏高,更适合对时效要求不高的场景。
需要客观看待的是,这只是单一测试者围绕「公众号排版复刻」这一特定场景得出的结论,评分带有一定主观性,也不能代表模型在编程、推理、长文本等其他能力维度上的全部表现。但它至少给我们提供了一个真实的生产力视角:在价格战愈演愈烈的当下,用户真正关心的已经不只是跑分,而是模型能否又快又省地把活干漂亮。
相关推荐

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。
PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。
合理使用为何惠及所有人?OpenAI 发布多方案例解读
OpenAI 公开多份法院简报摘录,汇集创作者、学者、无障碍倡导者与法律专家的观点,解读合理使用如何支撑 AI 训练与创新,并分析其对开发者与内容从业者的实际影响。