Claude Code 2.0深度实测:多智能体协同全自动写项目

Claude Code 2.0 围绕多智能体协同、自动权限管理和真机调试完成系统性重构,向全自动软件工程平台进化。
Anthropic 发布的 Claude Code 2.0 在三条主线上完成了系统性升级。其一,跨窗口消息路由机制让多个 Agent 能够自动感知关联并精准传递语义增量,多智能体分布式协作从概念跑通至可演示阶段。其二,Auto Mode 成为默认权限模式,后台风险分类器对危险命令的拦截率达 89%,远超人类疲劳状态下的 13.6%,同时新增 Concise 极简模式和用量超额自动续跑功能以控制成本。其三,桌面端集成原生 iOS 模拟器与隔离沙箱浏览器,实现左侧写代码、右侧实时预览的真机调试体验。此外,五档代码审查体系将高档位 bug 减除率从 17% 提升至 25%,Artifacts 通过嵌入 MCP 连接器从静态前端预览升级为可读写真实业务数据的动态应用。整体方向是从「辅助补全」走向「工程化生产」。
苦等数月的 Claude Code 2.0 正式推送,Anthropic 这次没有停留在小修小补,而是围绕多终端协同、自动化权限管理和真机调试三条主线做了系统性重构。从 B 站 UP 主的实测来看,这已经不只是一个代码生成助手,而是朝着「全自动软件工程总控台」的方向进化。下面把这套 2.0 的核心升级逐一拆解。
跨窗口消息路由:多智能体协同的雏形
以往用 Claude Code 写代码,前端开一个终端、支付接口开另一个终端,字段一改就得在窗口之间反复手动搬运。2.0 引入了跨会话消息路由机制:当你告诉「支付会话」把 UserName 改成 UserDisplayName,Claude 会通过 List Agents 自动扫描全局活跃终端,再用 Send Message 精准投递,并且只传递最核心的语义增量,尽量不浪费多余 Token。
更关键的是它能在后台自主感知关联性——一旦前端会话的改动触发后端连锁反应,Claude 会自动发起跨终端联动。官方演示中,两个独立 Agent 在各自终端里「有来有回」地下起了国际象棋,直观地展示了多智能体分布式协作的能力已经跑通。
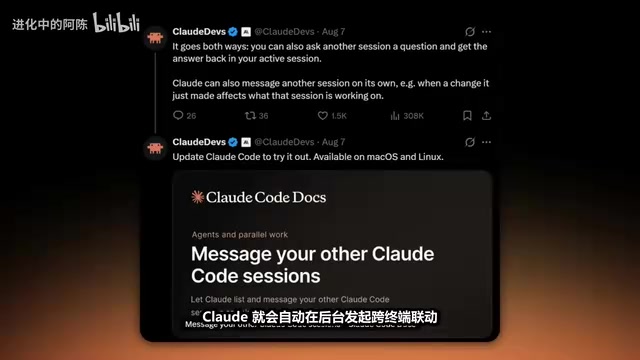
这个能力的意义在于,它把单点 AI 编程从「一个助手对一个任务」升级为「多个 Agent 分工协作」,更接近真实团队的开发形态。当然,从演示效果到复杂工程的稳定落地之间还有距离,实际项目中的可靠性仍需长期验证。
多智能体系统(Multi-Agent System)的核心思想是将复杂任务拆解后分配给多个专用 Agent 并行处理,各 Agent 通过消息传递协调状态。传统的单 Agent 架构面临上下文窗口限制——当代码库足够庞大时,单次会话无法容纳所有相关文件与历史,任务交接只能靠人工复制粘贴。跨会话消息路由通过维护一张全局 Agent 注册表,允许任意会话以「发布-订阅」或「点对点」模式投递消息,类似于微服务架构中的消息队列(如 Kafka、RabbitMQ),但面向的是 AI 会话而非服务进程。「只传语义增量」的设计至关重要:大语言模型按 Token 计费,如果每次联动都把全量上下文广播给所有 Agent,成本会呈指数上涨;只传字段变更的最小语义单元(如「UserName → UserDisplayName」)则将通信成本压缩到最低。
Auto Mode 默认权限:拦截率是人类的六倍
命令行操作里最让人血压升高的,是 AI 每改一个文件、每跑一行命令都要人工确认。2.0 直接把 Auto Mode 设为默认权限模式,由后台的风险分类器自动研判命令风险,而这些安全拦截调用不消耗用户的用量配额。
官方公布的一组数据颇有冲击力:在对 1053 名付费专业开发者的测试中,人类在疲劳写代码时对破坏性危险命令的拦截率仅有 13.6%,而 Auto Mode 的机器拦截率达到了 89%,团队交付 PR 的效率提升约 25%。红队进行了 720 次极端提示词注入攻击,官方称实现了零漏防。
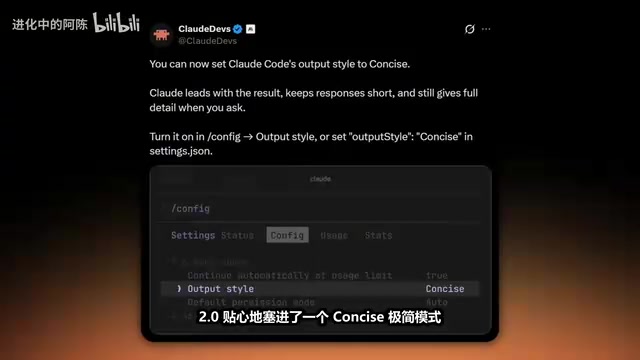
针对 Token 账单,2.0 新增了 Concise 极简模式——在配置文件里把 Output Style 改成 Concise,Claude 会砍掉「好的没问题」这类客套话,直接输出代码结果,长周期工程能省下可观的用量。此外还有用量超额自动续跑功能:额度用满后勾选自动继续,等配额重置后它会自动恢复现场,把剩下的代码写完。
底层架构上,桌面端启动速度提速约两倍,CLI 工具优化了内存垃圾回收逻辑,在任务执行期间冻结 GC、空闲时批量清理,显存与内存峰值大幅降低。
风险分类器是 Auto Mode 的核心安全组件,其本质是一个经过专项训练的分类模型,负责在命令执行前对其潜在危害进行多维度评估——涵盖文件系统破坏性(如 rm -rf)、网络外传行为、权限提升指令等类别。「拦截调用不计入用量配额」的设计值得关注:这意味着安全审查层被刻意置于计费边界之外,从激励机制上鼓励 Auto Mode 尽可能频繁地触发审查,而非因担心成本而放松过滤。提示词注入攻击(Prompt Injection)是此类系统最常见的对抗手段——攻击者将恶意指令藏入代码注释、文档内容或 API 返回值,试图欺骗 Agent 执行越权操作。官方红队以 720 次攻击声称零漏防,若数据属实,表明其防御机制在输入解析阶段已做了额外隔离,而不仅依赖主模型的指令跟随能力。
原生 iOS 模拟器与沙箱浏览器:真机调试所见即所得
移动端开发者会对这一升级格外兴奋。Claude Code 桌面端右侧无缝集成了原生 iOS 模拟器:左边敲 Swift 代码,右边立刻实时编译运行,可以自己点进界面翻页、验证 UI 渲染与按钮交互,彻底告别在编辑器和模拟器之间反复横跳。
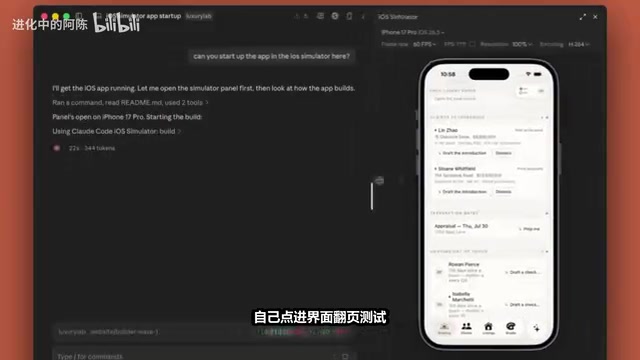
桌面端还内置了一套隔离沙箱浏览器,Claude 能自主打开官方文档、技术社区或设计稿抓取一手上下文,并支持在隔离凭证下持久化登录。遇到 UI 不满意,可以直接在屏幕截图上圈选位置、标注修改意见,Claude 就能按图施工;输入 design 还能生成可编辑的交互画布,拖拽调整后反向生成前端代码,尝试填平设计与研发之间的沟通鸿沟。
对于习惯纯文本或无障碍开发的用户,2.0 还提供屏幕阅读器模式,一键切成线性文本流、菜单编号化,并在关键节点用提示铃声提醒人工介入。
五档代码审查与动态 Artifacts
2.0 全面重构了 Code Review 体系,划分出五个深度档位:Low 档急速扫描,便宜到每次 Git Push 都能跑;Medium 档做多维度交叉比对;High 档拉起子 Agent 分别扮演「找 bug 的侦探」和「校验修复的审核员」;X-High 能顺藤摸瓜排查下游依赖模块的隐性问题;顶配 Ultra 模式则调动一整支专家评审团独立复现 bug。
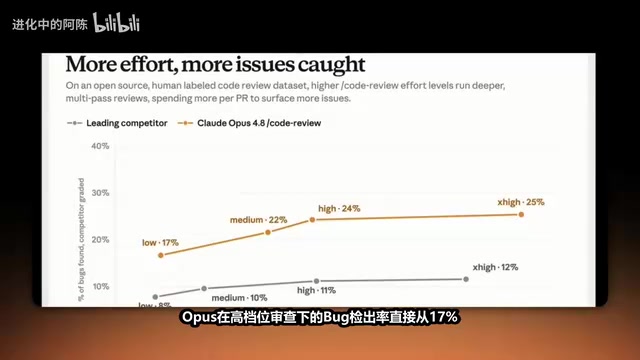
实测数据显示,Opus 在高档位审查下的 bug 减除率从 17% 提升到 25%,官方称领先竞品 12% 的水平。
Artifacts 也从静态前端预览升级为动态应用。2.0 把 MCP 连接器嵌了进去,生成的 Artifacts 能通过 MCP 实时拉取企业数据库和动态 API,从「漂亮的静态画板」变成能真正处理业务、发起云端读写的全功能应用。
MCP(Model Context Protocol)是 Anthropic 主导推出的开放协议,定义了 AI 模型与外部数据源、工具之间的标准化交互接口,类似于为大模型设计的「USB 协议」。在此之前,每个第三方集成都需要定制化的插件或 API 封装,维护成本高且互不兼容。MCP 将连接逻辑标准化后,理论上任何支持该协议的数据库、SaaS 平台或内部服务都能被 Artifacts 直接调用,无需额外适配层。将 MCP 嵌入 Artifacts 的意义在于改变了「生成物」的性质:过去 AI 产出的前端代码是静态的演示原型,数据硬编码在代码里;接入 MCP 后,Artifacts 能在运行时动态拉取真实业务数据,使其具备了替代部分轻量级内部工具(如数据看板、审批表单)的潜力。
从代码助手到工程总控台
配合下一代 Opus 5 与 Sonnet 5,Claude Code 2.0 完成了从代码生成助手到全自动软件工程平台的质变:多 Agent 协同、真机调试、全套代码审查闭环。这些能力叠加,意味着 AI 编程正从「辅助补全」走向「工程化生产」。
需要提醒的是,本文数据主要来自 B 站 UP 主对官方演示的实测转述,部分性能与安全数字为 Anthropic 官方口径,实际生产环境中的表现仍有待更广泛的用户验证。但方向已经足够清晰——AI 编程的工业化竞赛,正在进入更激烈的下半场。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。