Claude Code额度消耗快?上下文窗口管理技巧省35%

Claude Code 额度消耗快源于上下文管理,自动化清理可省 35% token。
文章指出 Claude Code 额度消耗快的根源在于上下文窗口管理:每轮对话都重发全部历史,导致 token 成本随会话长度线性增长,且上下文过满还会引发 AI 失忆。作者通过三步自动化方案——用 status.md 保存进度、按任务节点(commit/测试通过)而非上下文大小触发清理、关闭闲置工具并将长命令移出 CLAUDE.md——将清理时机准确率从 1/4 提升到 9/10。对照实验中,同样完成 20 项任务,使用该工具的一组 token 消耗减少 35%,API 成本从 5.94 美元降至 3.91 美元,且任务越长节省越明显。最小起步方案是建立 status.md 并在任务完成后用 /clear 开新会话。
Claude Code额度消耗快?上下文窗口管理技巧省35%
用 Claude Code 写代码,很多人都会遇到同一个困惑:刚开始对话时额度几乎不动,聊着聊着,明明只让它改一行代码,却一下子掉了 10%。据 YouTube 频道分享的实测经验,问题的根源不在模型本身,而在于 Context Window(上下文窗口)的管理方式。作者通过一套自动化的上下文管理工具,在完成同样 20 项任务的前提下,把 token 消耗降低了约 35%,API 成本从 5.94 美元降到 3.91 美元。
为什么额度消耗得这么快?
每一轮对话都在重读全部历史
Claude Code 的上下文窗口本质上是一段临时记忆——它记录了你在这个会话里说过什么、打开过哪些文件、运行过什么命令。上下文越丰富,AI 越能准确理解需求。问题在于,AI 并不会"自己记住"这些内容:每次你发送一条消息,Claude Code 都会把从第一条消息开始的整个会话历史重新发给模型。会话越长,每条消息的成本就越高。
据 Anthropic 官方文档的说明,token 用量会随上下文规模增长,Claude Code 需要读取的内容越多,消耗的 token 就越多。这也解释了为什么在开了一整天的会话里,哪怕只问一个简单问题,消耗的 token 也和整个会话长度相当。
Token 与上下文窗口的关系:Token 是模型处理文本的基本单位,约等于 0.75 个英文单词或半个汉字。上下文窗口(Context Window)指模型单次能处理的最大 token 数,Claude 目前主流版本为 200K。每次请求,输入 token 数 = 系统提示 + 工具定义 + 全部对话历史 + 当前消息。因此,会话历史越长,每次请求的输入 token 就越多,即使当前消息很短。输出 token 也计入成本但通常较少。API 计费按输入和输出 token 分别计价,输入 token 价格较低,但长会话下输入 token 量级巨大,成为主要成本。
上下文满了,AI 还会"失忆"
消耗额度只是问题的一面。当上下文接近上限时,Claude 会开始遗忘最早的指令,出错频率上升。作者把上下文窗口称为"最需要管理的东西",而 Anthropic 官方推荐的应对方式也很直接:用 /clear 开启新会话。
从手动清理到自动化的三步演进
第一步:写一个自动保存进度的工具
频繁开新会话虽然有效,但有两个麻烦:手动操作太繁琐,而且旧会话的记忆不会跟着过来,一切都要重新交代。作者的做法是让 Claude 自己写一个技能:当上下文达到 200k 时,先把当前正在做的事写入 status.md 文件,再清理会话;新会话读取这个文件后就能接着干活。
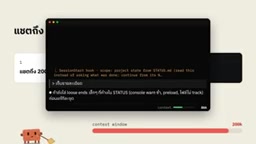
这个工具解决了一部分问题,但还不够好。作者记录了 4 次清理中有 3 次是在任务进行到一半时触发的,工作被打断,体验很割裂——AI 能恢复记忆,但人记不住刚才聊到哪了。
第二步:不再按大小清理,改按任务节点清理
更关键的问题是:清理后上下文回涨得极快,重新输入第一条消息就可能消耗几万 token。于是作者改变了触发条件——不看上下文大小,而是看后台任务是否完成了一个阶段,比如代码已 commit、测试已通过,或者话题切换时再清理。清理前先让 Claude 总结刚才做了什么,新会话先读总结。
效果很明显:清理的时机准确率从原来的 1/4 提升到接近 9/10。
后台任务与异步执行:Claude Code 支持在后台运行长时间任务(如构建、测试、代码检查),这些任务不阻塞对话。当后台任务完成一个阶段(如编译成功、测试通过),意味着一个逻辑工作单元结束,此时上下文中的中间状态(如错误日志、调试信息)可以安全丢弃。按任务节点清理正是利用这一信号:在任务边界处清理,避免打断进行中的思维链,同时确保关键结果已持久化(如写入 status.md 或 commit)。这比单纯按 token 数量清理更符合工作流语义,减少了“清理后立刻需要重新加载”的浪费。
第三步:关掉没用的连接器和工具
上下文膨胀快的另一个原因,是开启了大量并不使用的 connector、skill 和 tool——每一个被启用的工具,其名称和描述都会随每条消息一起发送,白白消耗 token。作者让 Claude 自动关闭未使用的工具,这与 Anthropic 的建议一致:用 /mcp 查看并关闭不用的 MCP server 或连接器。
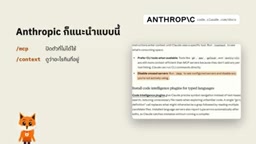
同一思路还适用于配置文件:把长命令从 CLAUDE.md 移到 skill 中,因为 CLAUDE.md 每次对话都会加载,而 skill 只在用到时加载,且建议控制在 200 行以内。另外,/clear 不消耗额度,而 /compact 需要读取整个会话才能生成摘要,本身就会产生消耗。
MCP、Connector 与 Skill 的区别:MCP(Model Context Protocol)是 Anthropic 推出的开放协议,允许 Claude 连接外部工具和数据源(如数据库、API)。Connector 是预置的集成(如 GitHub、Slack),本质也是 MCP server。Skill 是用户自定义的指令包,通常以文件形式存在,按需加载。每个启用的 MCP server 或 connector 都会在每条消息中携带其工具定义(名称、描述、参数 schema),这些定义消耗 token。Skill 则不同:Claude 只在判断需要时读取 skill 文件,不常驻上下文。因此,将长命令从 CLAUDE.md(每次加载)移到 skill(按需加载)能显著减少常驻 token。
实测对比:同样 20 项任务,省下 35%
作者用同一模型、同样的提示词做了两组对照实验,各跑 20 项任务:
- A 组:像大多数人一样,在一个长会话里连续对话。上下文从 12K token 开始随任务增长,到第 16 项任务时 Claude Code 不得不自行压缩会话。
- B 组:接入这套上下文管理工具,每完成一项任务就开新会话,上下文呈锯齿状,最高 124K。
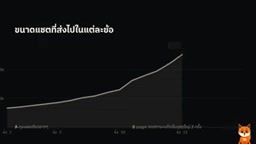
结果是 20 项任务全部完成、测试全部通过,但 B 组 token 用量少约 35%——A 组若计为 100,B 组只用了 65。按 API 价格换算,成本从 5.94 美元降到 3.91 美元。你可能没注意到,前 8 项任务两组的消耗完全相同,差距从第 9 项、会话开始变长时才出现——任务越长,节省越明显。
作者还对比了自己 7 天前后的真实使用数据:token 输入量下降 62%,最膨胀的会话从 974K 降到 267K。不过作者坦承,这两周的工作内容并不相同,数字只能反映趋势,并非精确的同比结果,且整个测试只跑了一轮。
落地建议:不必装工具也能起步
作者给出的最小可行方案很简单:建一个 status.md 文件,每次任务完成后清理会话,仅此一项就能省下不少。更进一步,可以把这套逻辑做成每次会话自动运行的 hook,并持续迭代——比如会话闲置超过一小时、缓存过期后,首条消息的成本约翻倍,就提醒清理;大任务完成后也提醒清理。
作者还分享了一个有趣的插曲:系统上线后 token 仍一度冲到 396K,最后发现是后台某个程序跳过了记录步骤——用来解决问题的系统,自己先出了问题。这也提醒我们,自动化工具本身需要被验证。
这套方法的核心思路并非某个具体工具,而是把上下文当作需要主动经营的资源:在任务节点清理、精简常驻配置、关闭闲置工具。正如作者所说,真正要做的,是把被臃肿上下文和无效后台任务吃掉的额度拿回来。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。