Claude Fable 5.1实测:一句话生成Minecraft、Garry's Mod、马里奥64
近期,一位B站UP主对Anthropic最新发布的Claude Fable 5.1模型进行了一次极限压力测试:在Claude Code环境中,用**单条提示词(one-shot prompt)**分别生成《我的世界》(Minecraft)、《盖瑞模组》(Garry's Mod)和《超级马里奥64》三款风格迥异的经典游戏。测试结果令人震撼,UP主甚至给出了自己评测生涯中的首个9.9分。
Claude是Anthropic公司开发的大语言模型系列,该公司由前OpenAI研究人员Dario Amodei和Daniela Amodei于2021年创立,核心理念是开发更安全、可解释的AI系统。Claude系列以其长上下文窗口能力著称,早期版本已支持100K tokens的上下文,远超当时GPT-4的8K/32K限制。Fable 5.1是Claude系列在代码生成领域的最新迭代,相比前代模型(如Claude 3.5 Sonnet),其在代码理解、架构规划和长序列生成一致性上进行了专项优化。值得注意的是,Anthropic在模型训练中强调Constitutional AI(宪法AI)方法——这是一种无需大量人类标注反馈的对齐技术,通过让模型学习遵循一系列明确的价值原则(如无害性、诚实性)来进行自我修正。在代码生成场景中,这种训练范式的影响体现为模型会更主动地添加输入验证、异常处理和边界检查代码,虽然有时可能导致生成的代码偏向保守,但在生成大规模项目时有助于减少运行时崩溃。
所谓one-shot prompt(单次提示),是指用户仅向AI模型发送一条完整的指令,模型在不经过多轮对话修正的情况下一次性完成全部任务。这与传统的AI辅助编程工作流形成鲜明对比——后者通常需要开发者反复与模型交互,逐步迭代代码。单次提示对模型的要求极高,因为它需要模型在一次推理过程中完成需求理解、架构设计、代码编写、模块集成等所有环节,任何一步出错都无法通过后续对话补救。从提示词工程(Prompt Engineering)的角度看,成功的单次游戏生成提示通常需要高度结构化:明确指定技术栈(如Three.js+Cannon.js)、定义核心游戏机制的优先级、描述预期的文件组织结构,甚至提供关键算法的伪代码提示。提示词的质量对生成结果的影响往往不亚于模型能力本身,这也是为什么同一模型在不同测试者手中表现可能差异巨大。
本文将梳理这次实测的完整过程,并从AI代码生成能力的角度分析Fable 5.1的真实水平与局限。
测试环境:Claude Code搭配Ultra Code模式
本次测试全部在Claude Code中完成,模型切换为Fable 5.1,并将运行档位调至最高的Ultra Code模式,以充分释放模型的编码性能。
Claude Code是Anthropic推出的面向开发者的命令行编程工具,它允许Claude模型直接在终端环境中读写文件、执行命令、运行项目,而不仅仅是在聊天窗口中输出代码片段。与GitHub Copilot等嵌入IDE的代码补全工具不同,Claude Code的定位更接近一个「AI开发代理」(AI Coding Agent),它能理解项目上下文、自主规划文件结构、执行构建命令并根据错误输出自动修正——这种端到端的开发能力是本次测试能够实现的基础设施前提。Ultra Code模式是其最高性能档位,通常意味着模型会消耗更多计算资源(更多token额度、更长的上下文窗口、更深的推理链),以获得更高质量的代码输出。在推理成本方面,Ultra模式下单次生成可能消耗数十万token的输出额度,按Anthropic的API定价换算,仅模型推理成本就可能达到数十美元——这也解释了为何此类深度测试并非所有用户都能轻易复现。这种模式特别适合需要生成大规模、多文件项目的复杂任务。
测试方法非常直接:将预先准备好的完整游戏需求提示词一次性粘贴发送,等待模型自动生成可运行的本地项目,再通过localhost打开体验。
有意思的是,整个流程没有多轮迭代、没有人工修bug——每款游戏都是单条prompt一次成型。这也是本次测试最具冲击力的地方:它检验的不是AI辅助编程的效率,而是模型从零到可玩产品的端到端代码生成能力。
Minecraft克隆「Hune」:体素沙盒的高度还原
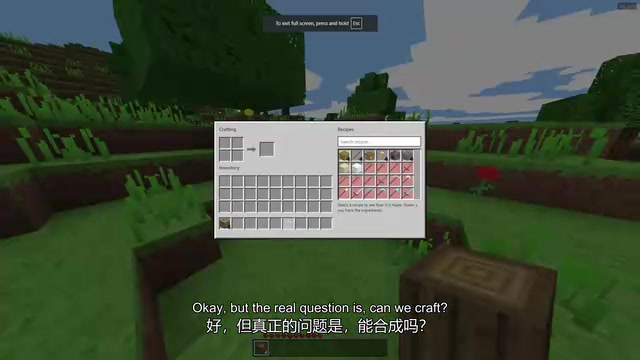
生成的体素沙盒游戏被命名为「Hune」,进入创造模式后,UP主的第一反应是「这是我见过最疯狂的一次性Minecraft克隆」。
要理解这一成果的含义,需要先了解体素引擎的技术复杂度。体素(Voxel)是三维空间中的最小立方体单元,类似于二维图像中的像素。Minecraft风格的体素引擎看似简单,实际上涉及大量技术挑战:需要高效的区块(Chunk)加载与卸载机制来管理内存;需要贪心网格合并(Greedy Meshing)算法减少渲染面数;需要实现方块面剔除(仅渲染暴露在空气中的面)来优化性能;还需要光照传播系统来计算每个方块的亮度。
体素引擎的核心挑战在于平衡视觉效果与性能开销。一个标准的Minecraft风格体素引擎通常采用分层架构:最底层是区块管理系统,将无限世界切分为16x16x256的区块单元,通过视距裁剪(Frustum Culling)只加载玩家周围可见区块;中间层是网格优化系统,使用贪心网格合并算法将相邻同类型方块的面合并为大平面,将渲染调用从数十万次降至数千次;顶层是光照系统,通常采用类似洪水填充的光照传播算法,从光源出发递归计算每个方块的光照等级。此外,还需实现八叉树(Octree)或类似的空间划分结构来加速碰撞检测。
值得注意的是,本次生成的「Hune」运行在浏览器环境中,这意味着它很可能基于WebGL(或WebGPU)和JavaScript/TypeScript技术栈实现。浏览器端的3D渲染面临额外约束:JavaScript的单线程特性限制了区块生成的并行能力(虽然可通过Web Worker缓解),WebGL相比原生OpenGL/Vulkan的API开销更大,且浏览器的内存管理不如原生应用灵活。在这些限制下仍能实现流畅的体素渲染,通常需要使用实例化渲染(Instanced Rendering)技术——将同类型方块的变换矩阵批量传入GPU进行一次绘制调用,而非逐个方块提交渲染命令。Three.js框架中的InstancedMesh类就是为此设计的。Fable 5.1能一次性生成包含这些系统的可运行引擎,说明其对图形学和游戏引擎架构有深入的知识图谱编码。
从实测表现看,Fable 5.1在细节还原上确实惊人:
- 地形生成:具备正常的程序化地形,甚至出现了「巨型山脉」和真实的洞穴生成
- 方块系统:钻石剑外观与功能都还原到位,玻璃可以透视
- 交互体验:挖掘手感被评价为「非常令人满足,和Minecraft一模一样」,斧头挖掘速度更快、造成伤害更高
- 生存模式:昼夜循环、游泳、生物(鸡、猪)都已实现,甚至能通过搜索栏查找方块
- 合成系统:完整实现了合成台功能
其中,程序化地形生成(Procedural Terrain Generation)是游戏开发中的经典技术,其核心思想是通过数学算法(而非手动建模)自动创建地形。Minecraft使用的是基于Perlin噪声和Simplex噪声的多层叠加算法——这种技术称为分形布朗运动(Fractal Brownian Motion, FBM),通过将多个不同频率(octave)的噪声函数按递减权重叠加,在不同尺度上创造细节:低频噪声控制大陆和海洋的整体轮廓,中频噪声塑造山脉和丘陵的形状,高频噪声添加地表的微小起伏。Perlin噪声由Ken Perlin于1983年为电影《Tron》发明,其改进版Simplex噪声在高维空间计算效率更高。洞穴生成则通常使用Perlin Worm算法(模拟蠕虫在3D空间中运动的轨迹形成隧道)或3D噪声阈值切割(当三维噪声值低于特定阈值时将该位置设为空气)。真正的Minecraft还叠加了生物群系(Biome)系统——根据温度和湿度参数划分不同区域,影响地形高度、植被分布和方块类型。Fable 5.1能在一次性生成中实现这些算法,说明模型对过程式生成的数学基础和工程实现都有深入理解。
当然也存在明显缺陷:水流不流动,只是单个静态方块;火把摆放略有错位;沙子破坏后不会下落。水流模拟在Minecraft中使用的是元胞自动机(Cellular Automaton)算法——每个水方块根据周围邻居的状态决定下一帧的流向和液面高度,这需要实现复杂的状态更新逻辑和边界处理,是体素游戏中公认的高难度特性。沙子的重力下落则涉及方块实体化(将静态方块临时转换为受物理影响的实体)的机制。这些缺陷表明模型在一次性生成中对次要系统的覆盖存在优先级取舍。但对于一次性生成的产物而言,这些瑕疵已被UP主认为「无伤大雅」。
Garry's Mod物理沙盒「Construct」:物理引擎的真实运作
第二款生成的物理沙盒游戏名为「Construct」,规模明显超出预期——地图比UP主此前测试时大得多,背景有完整的场景,还专门设置了一个「跌落测试中心」。
最让人意外的是游戏内文本渲染质量。UP主指出,过去AI生成的游戏文字往往扭曲、别扭,而这次的UI文本「看起来非常棒」。这个进步的背后涉及一个微妙的技术点:在WebGL 3D场景中渲染清晰的文字一直是个棘手问题。常见方案包括将文字预渲染为纹理贴图(容易在缩放时模糊)、使用SDF(Signed Distance Field,有符号距离场)字体渲染(可在任意缩放下保持锐利边缘)、或直接使用HTML/CSS覆盖层(简单但难以与3D场景交互)。Fable 5.1可能选择了最后一种方案或更成熟的文本渲染库,这从侧面反映出模型在技术选型上的务实判断力——选择最可靠的实现路径而非最炫技的方案。
物理系统方面,工具枪、焊接枪、推进器、气球、绳索、复制、喷漆等Garry's Mod招牌功能一应俱全。物体可以抓取、冻结、旋转、缩放。UP主用金属桶焊接推进器尝试「起飞」,虽然过程中箱子被撞碎、载具反复失败,但最终还是靠焊接座椅和推进器组合搭出了能飞的载具。
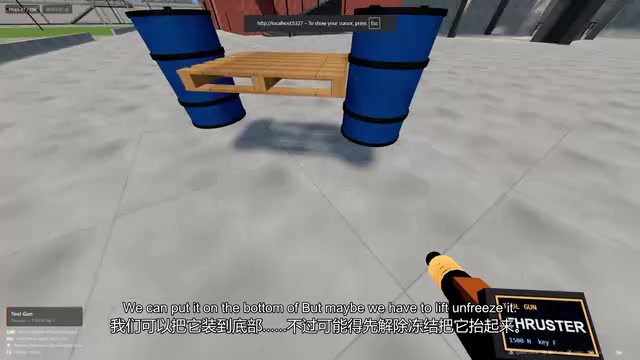
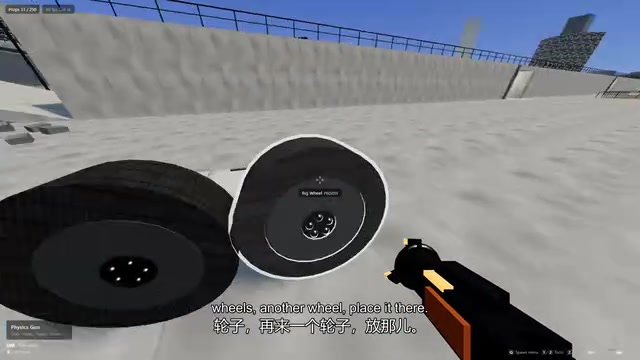
随后他又尝试给冰箱装轮子做成汽车,遇到了轮子半径不够、重量分布失衡等物理问题——但这恰恰说明物理引擎是真实运作的,而非简单的动画模拟。
物理引擎中的刚体(Rigid Body)假设物体在受力时不会变形,这大幅简化了计算复杂度。每个刚体具有质量、转动惯量、位置、速度、角速度等物理属性,引擎在每帧中求解牛顿运动方程更新这些状态。碰撞检测分为粗略阶段(使用AABB包围盒或空间哈希快速筛选可能碰撞的物体对)和精确阶段(使用GJK/EPA算法计算实际碰撞点和穿透深度)。GJK(Gilbert-Johnson-Keerthi)算法通过闵可夫斯基差判断两个凸形是否相交,EPA(Expanding Polytope Algorithm)则在GJK确认相交后计算最小穿透向量。碰撞响应阶段需要计算冲量(impulse)来调整物体速度,同时考虑摩擦系数和弹性系数。
约束系统是物理沙盒的核心:焊接约束通过设置无限大的刚度将两物体连接,使它们像一个整体运动;绳索约束限制两个连接点的最大距离但允许自由旋转,常用位置约束而非力约束实现;铰链约束只允许沿特定轴旋转,如车轮与车身的连接。这些约束通过拉格朗日乘数法或投影法(如Position Based Dynamics, PBD)在物理迭代中求解,每帧可能需要多次迭代(通常8-20次)来收敛约束满足程度,确保物体间的连接关系被维持。在浏览器环境中,这些计算通常由Cannon.js、Ammo.js(Bullet物理引擎的WebAssembly移植版)或Rapier.js等库完成。相比游戏工业中常用的Havok或NVIDIA PhysX引擎,浏览器端物理引擎在求解精度和性能上存在差距,但对于原型验证已经足够。Garry's Mod生成结果中轮子与车身的质量分布问题能真实体现,证明引擎在进行基于力矩的动力学计算而非简单播放动画。
最终,UP主靠推进器加斜坡完成了「飞车」壮举,称这是「目前见过最强的一次性提示词生成结果」。
超级马里奥64重现:从后空翻到Boss战的完整关卡
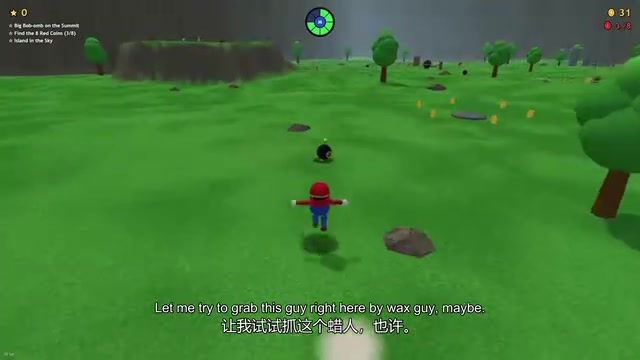
第三款是UP主此前挑战失败过的《超级马里奥64》。这一次Fable 5.1生成的版本表现出乎意料地完整。
《超级马里奥64》于1996年由任天堂发布,是3D平台跳跃游戏的开山之作,由传奇制作人宫本茂领衔设计。它在Nintendo 64主机上首发,彻底定义了3D游戏的操控范式——其自由视角摄像机系统、360度模拟摇杆操控、渐进式移动速度(走路→小跑→冲刺)等设计在当时都是革命性的创新。游戏中马里奥拥有超过20种不同的移动状态(行走、奔跑、跳跃、后空翻、侧翻、踢墙跳、俯冲、滑行、游泳等),这些状态之间的切换由复杂的有限状态机控制,其流畅的动作衔接至今被3D游戏设计教材反复引用。
有限状态机(Finite State Machine, FSM)是游戏开发中最常用的行为控制模式。在马里奥这样的动作游戏中,角色的每个动作(站立、行走、跳跃、下蹲、后空翻等)是一个状态,状态之间通过触发条件(输入、物理条件)进行转换。例如,从'站立'到'后空翻'的转换需要检测:当前状态为站立→按下蹲键进入下蹲状态→在下蹲状态下按跳跃键→切换到后空翻状态。实现时通常使用switch-case结构或面向对象的状态模式(State Pattern),每个状态包含Enter(进入时初始化动画和物理参数)、Update(每帧更新逻辑)、Exit(清理资源)三个回调函数。复杂的动作系统还会使用分层状态机(Hierarchical FSM,上层状态控制地面/空中/水中模式,下层状态控制具体动作)或行为树(Behavior Tree)来处理更复杂的决策逻辑。
特别值得一提的是,《超级马里奥64》的三段跳(Triple Jump)系统是状态机设计的经典案例:游戏需要记录连续跳跃的次数和时间间隔,只有在前两次跳跃后快速起跳才能触发第三段的超高跳跃,这需要在状态机中引入计时器和历史记录等额外变量。原版有超过20种状态和100多个状态转换规则,能一次性生成接近原版体验的系统,说明Fable 5.1对经典游戏设计模式有深入的训练数据覆盖。值得注意的是,《超级马里奥64》的源代码于2019年被社区逆向工程完整反编译,相关代码和技术分析在互联网上广泛流传,这些公开资料很可能是Fable 5.1训练数据的一部分,有助于模型学习到原版游戏的精确实现细节。
初始版本存在控制方向相反的小bug,简单调整后即可正常游玩。实测中发现的功能包括:
- 3D动作系统:后空翻、转向、踩踏Goomba头部都能正常触发
- 关卡设计:具备完整的可攀爬山地关卡、红币收集、移动平台
- Boss战:需要绕后抓取并投掷的经典Boss机制被还原
- 火炮系统:需要炸弹小子开启的火炮、瞄准发射机制均已实现
- 收集与通关:能够收集星星并完成整个关卡
UP主全程通关后评价这是「一个真正好玩的游戏」,操作手感和关卡节奏都相当扎实。这里的「手感」(Game Feel)是游戏设计中一个重要但难以量化的概念,它涉及输入延迟、动画过渡曲线、摄像机跟随算法、粒子特效反馈、屏幕震动等多个细节的协同配合。AI能生成让人类测试者感到「手感好」的操作体验,说明模型不仅理解了代码逻辑,还在某种程度上编码了游戏设计的美学经验。
AI一次性代码生成能力的意义与边界
这次实测虽然带有明显的娱乐性质,但背后反映出的技术信号值得关注。
端到端产品生成能力的突破
过去我们评价AI编程模型,更多看它能否补全函数、修复bug、辅助重构。而Fable 5.1展现的是从一段自然语言需求直接产出可运行、可交互、带完整游戏循环的复杂应用——这涉及渲染、物理、UI、游戏逻辑等多个系统的协同实现。
生成一个完整的可运行游戏,代码量通常在数千到数万行之间,涉及渲染模块、输入处理、物理计算、游戏状态管理、UI系统、音效系统等多个相互依赖的子系统。这要求模型在生成过程中始终维持对整体架构的认知——前面定义的数据结构必须与后面的使用方式一致,函数接口必须在调用处和定义处匹配,全局状态的修改必须在所有相关模块中保持同步。这种跨系统的一致性维护在软件工程中称为「架构完整性」(Architectural Integrity),即使在人类团队开发中,随着代码规模增长也经常出现接口不匹配、状态不同步等问题,需要架构师持续审查维护。
长距离依赖(Long-range Dependency)是大语言模型生成长文本的核心挑战。在代码生成场景中,这体现为前后代码的一致性维护:在文件开头定义的类接口必须与1000行后的调用代码匹配;全局变量的初始化顺序必须符合依赖关系;模块间的API契约必须在不同文件中保持一致。Transformer架构虽然通过自注意力(Self-Attention)机制理论上可以关联任意距离的token,但实际上存在两个核心限制:一是注意力权重随距离增加呈现统计性衰减(尽管理论上没有硬性距离限制);二是上下文窗口越长,每个位置需要与更多位置计算注意力,导致有效注意力信号被稀释——这被称为「注意力稀释」(Attention Dilution)问题。
Claude系列模型通过多项技术缓解这一问题:扩展的上下文窗口(Claude 3.5已支持200K tokens)提供更大的「工作记忆」容量;改进的位置编码方案(如旋转位置编码RoPE或线性偏置ALiBi)帮助模型更好地感知token间的相对距离;推测Fable 5.1还可能采用了分层注意力机制或稀疏注意力策略,让模型先关注宏观代码结构(如类定义、函数签名)再细化实现细节。此外,Anthropic可能在训练阶段引入了「代码规划」(Code Planning)任务——要求模型在生成代码前先输出架构大纲和模块依赖图——这种链式思维(Chain-of-Thought)训练策略有助于模型在长序列生成中维持全局一致性。本次测试中三款游戏都能一次成型,证明Fable 5.1在长序列生成中的规划和一致性维护能力达到了新的水平。
三款风格迥异的游戏都能一次成型,说明模型的长上下文规划与代码组织能力有了实质提升。
仍需正视的现实局限
从测试可见,模型的产物在物理细节(水流不流动、沙子不下落)、边界情况(控制反向、载具重量失衡)上仍有明显缺陷。这些游戏是「高度还原的原型」,而非「可发布的成品」。从原型到产品之间的鸿沟在游戏行业中被称为「最后10%问题」——让游戏基本可玩可能只需要30%的工作量,但打磨到发布品质所需的bug修复、性能优化、用户体验调整、平台适配、辅助功能支持等工作往往占据70%甚至更多的开发时间。AI目前能高效完成前30%,但后70%仍然高度依赖人类判断。
此外,本次测试仅来自单一UP主的实测演示,缺乏系统性benchmark对照。AI代码模型的评测通常使用标准化benchmark,主流数据集包括HumanEval(OpenAI发布的164道Python编程题,测试函数级代码生成)、MBPP(谷歌的1000+基础编程题库)、CodeContests(竞赛级算法题)、以及更新的LiveCodeBench(使用竞赛平台新题避免数据泄露)等。这些benchmark侧重单函数级别的功能正确性,评估指标是pass@k(生成k次中至少一次通过所有测试用例的概率)。然而,这类基准测试存在明显局限:它们无法评估跨文件依赖管理、架构设计合理性、长期代码维护性等工程实践能力,也无法衡量生成代码的可读性、可扩展性和性能表现。
学术界和工业界正在积极探索更全面的评测框架:SWE-bench(由普林斯顿大学提出)使用真实GitHub issue作为任务,要求模型在完整代码仓库中定位问题并提交修复补丁;DevBench评测完整应用的构建能力;BigCodeBench测试API调用和工具使用;WebArena则在真实网页环境中评估代码代理的交互能力。本次UP主的游戏生成测试实际上属于一种非正式的端到端产品级评测,是对传统benchmark的有效补充,但因其不可控变量过多(提示词质量、主观评价标准、单次测试的随机性等),「碾压所有基准测试」的说法应视为营销话术而非严谨结论。
另一个容易被忽视的问题是知识产权。AI模型的训练数据必然包含大量开源游戏代码和引擎实现,生成结果可能无意中复现了受版权保护的代码片段或受专利保护的算法实现。例如,Minecraft的具体方块交互逻辑、马里奥的特定动作参数等都可能涉及知识产权边界。目前法律界对AI生成代码的版权归属尚无定论,开发者在商业化使用AI生成的游戏代码时需要格外谨慎。
对开发者的实际启示
AI已经能够将「概念验证」和「快速原型」的成本压缩到极低。以往需要数天搭建的游戏demo,如今一条提示词、几分钟等待即可获得可玩版本。这对独立开发者、教育演示、创意验证等场景具有实际价值。在Game Jam(限时游戏开发比赛,通常48-72小时)场景中,AI辅助原型生成可以让开发者将更多时间投入到创意设计和玩法打磨上,而非基础框架搭建。在教育场景中,学生可以通过观察AI生成的完整游戏代码来学习引擎架构和设计模式,这比从空白文件开始更容易建立整体认知。
但从原型到打磨完善的商业产品,人类工程师的深度介入依然不可替代。网络多人同步、反作弊系统、跨平台适配、无障碍设计、长期运营支持等「非功能性需求」目前仍远超AI的能力边界。更重要的是,游戏的核心魅力——创意灵感、情感共鸣、文化表达——这些「为什么要做这个游戏」的问题,仍然需要人类创作者来回答。
结语
Claude Fable 5.1在这次三款游戏的一次性生成测试中,交出了一份足以让评测者惊叹的答卷。它清晰地展示了当前顶尖AI代码模型在复杂应用端到端生成上的进步,也暴露了在物理精度和边界处理上的现实局限。对于关注AI编程发展的人而言,这类实测比抽象的benchmark数字更能直观感受模型能力的真实边界。而对于整个软件开发行业来说,「一条提示词生成一个可玩游戏」不再是演示噱头,而是正在快速逼近实用门槛的新工作范式——它不会取代开发者,但会深刻改变开发的起点和节奏。
相关推荐
开源AI的真相:你拿到的只是蛋糕,不是配方
海外博主深度揭秘开源AI真相:你下载的只是权重(蛋糕),而非训练数据与代码(配方)。文章拆解开放权重与真正开源的差异,剖析Meta、阿里、DeepSeek的商业策略,以及中美欧三国政府如何用营收门槛与算力上限重画开放边界。
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
DSH-SUBAGENT-UI插件:DeepSeek Harness子代理管理神器
DSH-SUBAGENT-UI 是 DeepSeek Harness Web 客户端插件,提供子代理总览、搜索、本地分类与完成快照功能,数据存本地不侵入原会话,一条命令即可安装,助力多子代理工作流高效管理。