Claude Fable 5/5.1报错事件:30分钟故障复盘
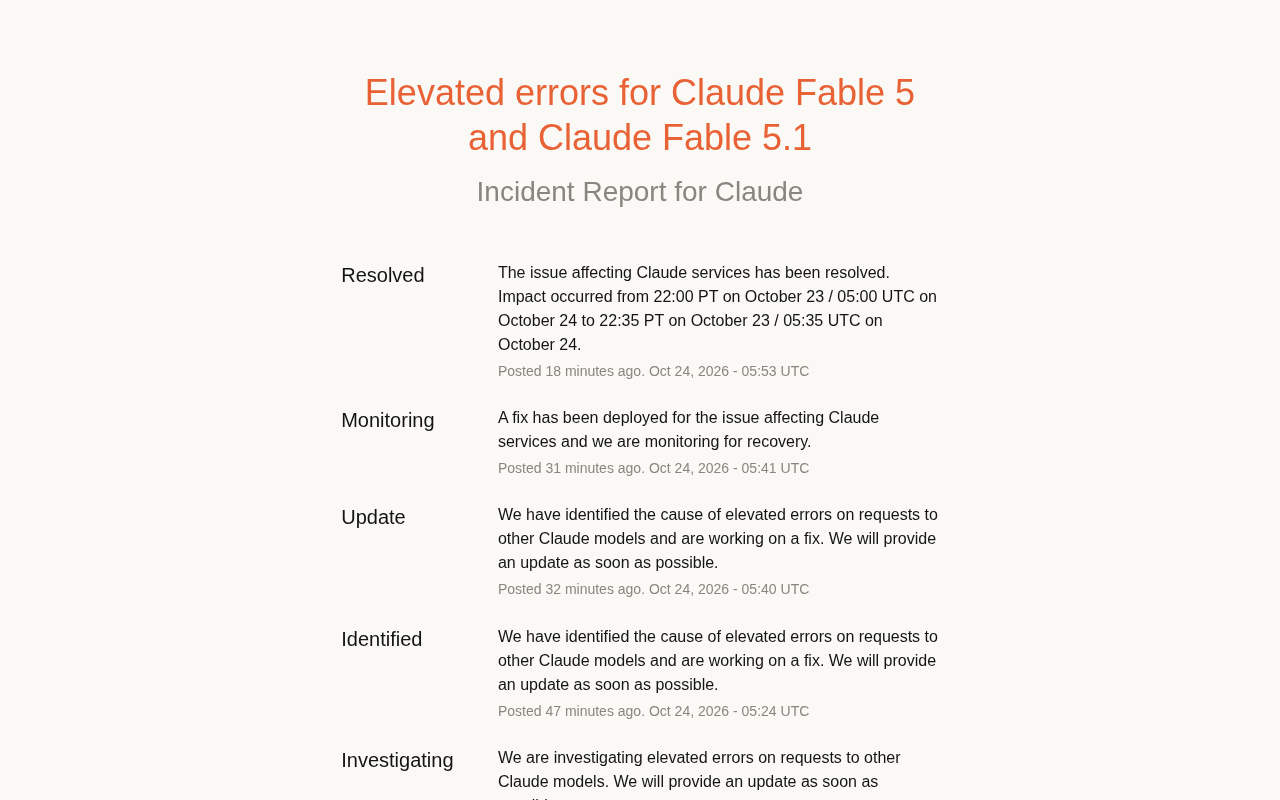
Claude Fable 5/5.1 错误率升高约35分钟,官方17分钟完成修复部署。
文章梳理了 Claude Fable 5 与 Fable 5.1 一次约 35 分钟的错误率升高事件。据官方状态页,故障始于 10 月 23 日 22:00 PT,05:16 UTC 首次通报 Investigating,8 分钟后升级为 Identified,05:41 UTC 部署修复并进入 Monitoring,05:53 UTC 标记 Resolved。状态更新提到「其他 Claude 模型」也出现错误率升高,说明问题并非单一模型。文章建议开发者配置状态页 RSS/Webhook 告警、请求级重试与指数退避、多模型路由以及用户侧降级体验,并指出大模型服务因共享算力池与调度层,故障更可能源于公共依赖而非单模型缺陷。
事件概览:一次被快速解决的API故障
根据官方状态页披露的信息,Claude Fable 5 与 Claude Fable 5.1 两个模型在近期出现了一轮「错误率升高」(elevated errors)的服务异常。状态页时间线显示,故障从太平洋时间 10 月 23 日 22:00(即 UTC 10 月 24 日 05:00)开始,到 22:35 PT / 05:35 UTC 结束,全程约 35 分钟。有意思的是,官方在 05:41 UTC 部署修复并进入监控阶段,05:53 UTC 正式标记为「已解决」(Resolved)。从「发现」到「修复上线」仅约 17 分钟,这在依赖复杂推理链的大模型服务中属于相当快的响应速度。
对于正在使用 Claude 构建产品的开发者而言,这次事件的核心信息并非「宕机」本身,而是错误传播范围:状态页更新中明确提到「其他 Claude 模型的请求也出现错误率升高」,说明问题并非完全局限于 Fable 5 系列单点,而是存在向相邻服务扩散的迹象。
故障时间线还原
从 Investigating 到 Identified 的 8 分钟
05:16 UTC,官方首次以「Investigating」状态对外通报,表示正在调查 Claude 模型请求的错误率上升问题。8 分钟后的 05:24 UTC,状态升级为「Identified」,意味着工程团队已经定位到根因,并着手修复。这个阶段是整个事故处理中最关键的一环——多数云服务故障的真正耗时往往不在修复,而在于从海量日志中锁定故障源。
「Investigating」「Identified」「Monitoring」「Resolved」是主流云服务状态页通用的状态机术语:Investigating 表示已确认异常并开始排查;Identified 表示已定位根因并确定修复方案;Monitoring 表示修复已上线、正在观察指标是否恢复;Resolved 表示异常消除并关闭事件。这套状态划分的意义在于把「知道出事了」与「知道为什么出事」区分开,便于外部用户判断预期恢复时间。对依赖状态页做自动化的团队来说,状态迁移事件本身就是可订阅的信号,比正文描述更结构化,适合直接映射到内部告警等级。
修复部署与监控窗口
05:40 UTC,官方再次更新,确认已识别原因并正在推进修复。仅 1 分钟后(05:41 UTC),修复被部署上线,状态转入「Monitoring」。随后 05:53 UTC 发布「Resolved」,并给出了完整的故障影响区间。这种「先部署、再观察、后关闭」的流程符合成熟 SRE 实践,也解释了为什么最终影响时长被精确框定在 35 分钟内。
SRE(Site Reliability Engineering)实践中的「先部署、再观察、后关闭」源于一个基本判断:修复上线不等于故障结束。部署只是改变了系统状态,指标是否真正回归基线仍需一个观察窗口,通常以错误率、延迟分位数等 SLI 恢复到正常区间并稳定若干分钟为准。这也解释了为何官方在 05:41 UTC 部署修复后并未立刻标记解决,而是等到 05:53 UTC 才关闭事件——监控期既是验证期,也是为可能的回滚留出缓冲。
对开发者的实际影响与应对
从公开信息看,这次故障没有披露具体的错误码分布、受影响请求比例,也没有说明是否与特定区域或特定调用方式相关。这意味着使用 Claude API 的团队需要依靠自身的错误监控来判断业务是否被波及。对于将 Claude 作为核心推理引擎的产品,建议在架构层面保留三类兜底:其一是请求级重试与指数退避,其二是多模型路由(在 Fable 系列异常时切换至其他可用模型),其三是对用户侧的错误提示与降级体验。
另一个值得关注的细节是故障通告的粒度。状态页在 16 分钟内连续更新四次,从 Investigating 到 Identified 再到 Update,信息密度较高。开发者可以将状态页的 RSS 或 Webhook 接入告警系统,而不是依赖人工刷新,这样能在官方首次通报时即触发内部响应流程。
指数退避(exponential backoff)指重试间隔按指数增长,例如 1s、2s、4s、8s,并通常叠加随机抖动(jitter)以避免大量客户端在同一时刻集中重试造成「重试风暴」。对大模型 API 而言,这一点尤其重要:推理请求本身占用 GPU 时间较长,若故障期间客户端密集重试,反而会加剧排队与超时。多模型路由则是把请求按可用性动态分发到不同模型或供应商,需在业务层预先定义好能力降级映射,否则故障发生时临时切换往往来不及验证输出质量是否可接受。
从这次事件看大模型服务的稳定性挑战
大模型服务的故障与传统 API 有本质区别:推理服务的负载具有强突发性,单个请求可能消耗数秒的 GPU 时间,且不同模型往往共享底层算力池。当 Fable 5 与 Fable 5.1 同时报错,并波及「其他 Claude 模型」时,合理的推测是资源调度层或共享依赖组件出现了问题,而非单一模型的代码缺陷。官方未公布根因细节,因此这一判断仍属推测。
对开发者而言,这次 35 分钟的故障是一个温和的提醒:再成熟的大模型平台也无法保证 100% 可用性。把「模型不可用」当作常态来设计系统,比事后追责更有价值。具体做法包括在非关键路径使用缓存结果、为长任务设计断点续跑、以及在 SLA 层面与业务方对齐可接受的降级标准。
大模型推理服务通常共享 GPU 算力池、批处理调度器与鉴权/限流网关等基础设施。所谓「共享依赖组件」可能包括模型权重加载服务、请求排队与批处理层、token 计费与配额系统等。当多个模型同时出现错误率升高时,故障点更可能位于这些公共层,而非某个模型的推理代码。这也是推断「资源调度层或共享依赖」出问题的依据:单模型缺陷一般不会同时影响多个不同模型家族。
常见问题
Q:这次故障影响了哪些模型? A:官方标题指向 Claude Fable 5 与 Claude Fable 5.1,但状态更新中提到「其他 Claude 模型」的请求也出现错误率升高,说明影响范围可能更广。
Q:故障持续了多久? A:根据官方 Resolved 通告,影响区间为 10 月 23 日 22:00 PT 至 22:35 PT,约 35 分钟。
Q:需要做什么后续操作吗? A:官方未提示需要用户侧操作。建议检查自身监控中该时段的错误率,评估是否需要对重试策略或模型路由做调整。
相关推荐
OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。
SQL Agent模式选择层实测:Opus竟输给Sonnet,投票机制零收益
开源项目 schemagate 在 BIRD 与 Spider 2.0 上实测 SQL Agent 模式选择层:Opus 在 Spider 2.0 上输给 Sonnet,投票机制留出集收益为零,BigQuery 分片表击穿选表逻辑,基准测试还暴露了权限校验 bug。