OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
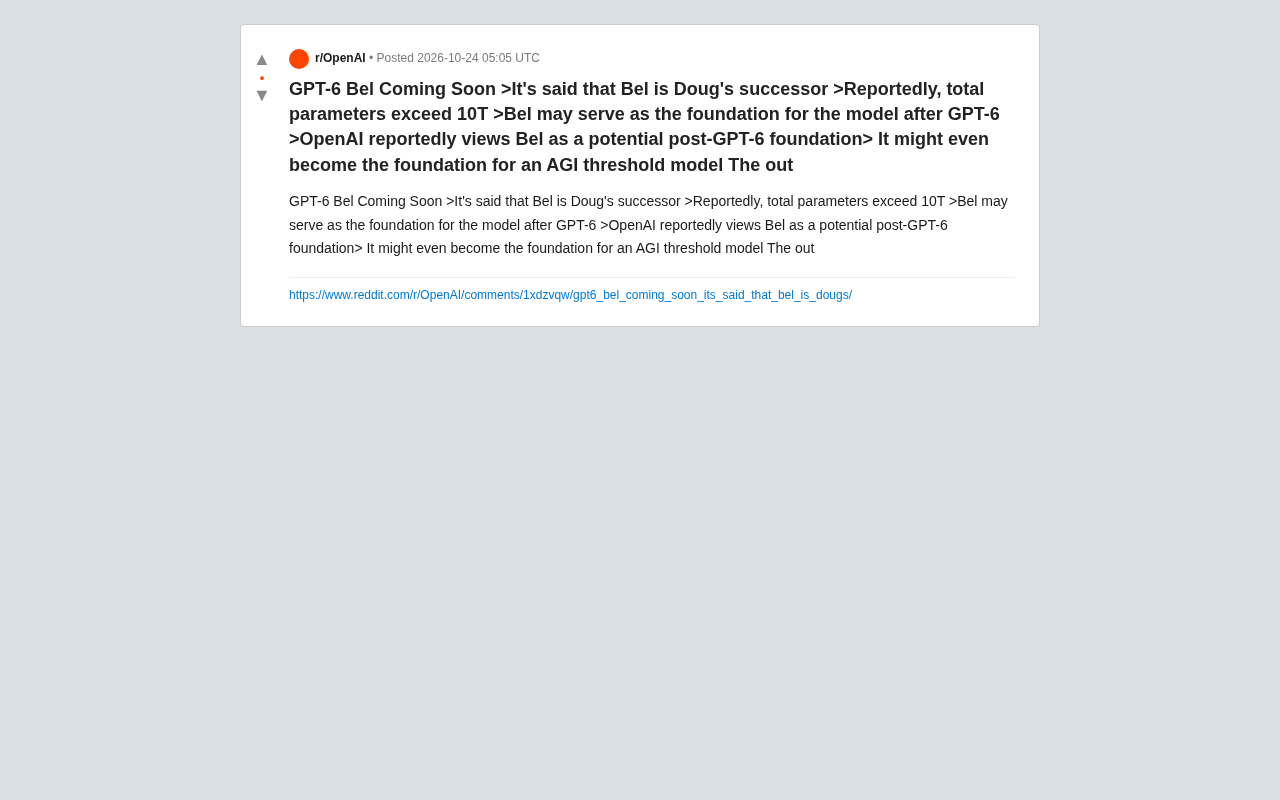
Reddit爆料称OpenAI新模型Bel参数超10万亿,或为GPT-6后基础模型及AGI门槛候选。
文章围绕Reddit上一则关于OpenAI新模型“Bel”的爆料展开分析。爆料称Bel总参数量超10万亿,是内部项目“Doug”的继任者,并被定位为GPT-6之后的基础模型,甚至被视为AGI门槛模型的基座。作者对关键信息逐一拆解:指出“继任者”暗示技术继承性,10T参数可能对应MoE稀疏架构,参数量不等于能力;“AGI门槛模型”是模糊的战略表述而非技术承诺。文章强调该爆料仅有单一来源,措辞模糊且内容截断,可信度有限,但与OpenAI近期技术路线不矛盾。最后讨论了对行业的潜在影响,包括基础模型竞赛加速、后GPT-6叙事开启以及AGI话语权争夺,建议保持关注但不过度解读。
一则来自Reddit的爆料,掀开了OpenAI下一代模型的冰山一角
近日,Reddit上出现了一条关于OpenAI内部新模型的爆料帖,信息量极大却又语焉不详。帖子称,一个代号为“Bel”的新模型即将问世,其总参数量据传超过10万亿(10T),并可能作为GPT-6之后的基础模型,甚至被OpenAI内部视为迈向AGI门槛的基座。
这条消息目前只有单一来源,Reddit原帖内容零散且缺乏细节,但其中提到的几个关键信息点——继任关系、参数规模、战略定位——恰好触及了当前大模型竞赛中最敏感的神经。
关键信息拆解:Bel是什么?
代号“Bel”与“Doug的继任者”
原帖提到“Bel是Doug的继任者”。这里的“Doug”很可能指的是OpenAI内部某个模型项目或代号。如果这一说法成立,Bel并非从零开始的新项目,而是接替已有技术路线的迭代产物。这种内部代号更替的表述方式,在OpenAI过往的模型开发中并不罕见——从GPT-3到GPT-4,每一代基础模型背后都有多个并行实验和内部代号。
“继任者”的措辞暗示Bel可能继承了Doug的技术积累,而非彻底另起炉灶。这对于理解Bel的定位很重要:它大概率是一个基础模型(foundation model),而非面向终端用户的产品型号。
10万亿参数:一个需要冷静看待的数字
爆料称Bel的总参数量超过10T。作为参照,GPT-4的参数规模外界普遍推测在万亿级别(具体数字未公开),而10T意味着参数规模可能再上一个数量级。
但参数量的膨胀并不自动等同于能力提升。当前行业更关注的是稀疏激活(如MoE架构)、训练数据质量和推理效率。10T总参数很可能对应的是一个混合专家模型,实际激活参数远低于总数。单纯用“参数量”来衡量模型能力,本身就是一种过时的叙事框架。这一点在解读爆料时需要保持清醒。
混合专家模型(MoE) 是一种稀疏激活架构,其核心思想是将模型分解为多个“专家”子网络,每个输入仅激活其中少数专家。这样,模型总参数量可以非常庞大(例如10T),但每次前向传播实际参与计算的参数(激活参数)远小于总数,从而在保持推理效率的同时扩展模型容量。MoE的关键设计包括专家路由机制(决定输入分配给哪些专家)和负载均衡策略(防止专家利用不均)。当前主流大模型如GPT-4、Mixtral等均采用或疑似采用MoE架构,因此10T总参数很可能对应一个激活参数在千亿级别的MoE模型,而非稠密模型。
“GPT-6之后的基础模型”与AGI门槛
帖子中最具想象力的部分是:OpenAI据称将Bel视为“GPT-6之后的潜在基础模型”,甚至可能是“AGI门槛模型”的基座。
这里有两层含义。第一,Bel的发布时间可能在GPT-6之后,或者至少是并行推进的下一代架构。第二,OpenAI内部对“AGI门槛”的讨论仍在持续,而Bel被赋予了跨越这道门槛的候选者角色。
提一嘴,“AGI门槛模型”是一个模糊的表述。OpenAI从未公开定义过AGI的具体技术标准,内部对AGI的判定标准也随着模型能力演进不断调整。因此,这一说法更像是一种战略定位的描述,而非技术规格的承诺。
AGI(通用人工智能) 指具备与人类相当或超越人类的广泛认知能力、能完成多种任务的人工智能系统。然而,AGI尚无公认的技术定义或评估标准,不同机构对其门槛有不同解读。OpenAI内部常将AGI视为一个渐进目标,其判定可能涉及在多数经济价值工作中超越人类、具备自主学习和跨领域迁移能力等模糊条件。因此,“AGI门槛模型”更多是一种战略叙事,用以描述模型能力的潜在跃升,而非可量化的技术规格。这种表述既反映内部雄心,也服务于公众沟通和监管对话。
消息可信度评估:单一来源的局限性
必须明确:目前所有关于Bel的信息均来自Reddit上的这一条帖子,没有第二个独立来源佐证。Reddit的AI爆料板块历来是真假消息混杂之地,此前也有过多次“内部消息”最终被证伪的案例。
从信息特征来看,帖子使用了“据说”(It's said)、“据传”(Reportedly)等模糊措辞,且原文在“The out”处戛然而止,明显是截断或未完成的内容。这降低了信息的完整性和可信度。
不过,这条爆料与OpenAI近期的技术路线也有可对照之处。OpenAI一直在推进更大规模的基础模型训练,且Sam Altman多次公开提及下一代模型将带来“显著跃升”。Bel的传闻至少在这个大方向上不矛盾。
对行业意味着什么?
如果Bel的传闻部分属实,几个趋势值得关注:
基础模型的竞赛仍在加速。 10T参数级别的模型意味着训练成本、算力需求和工程复杂度都将进入新的量级。能够参与这一级别竞赛的玩家将进一步减少。
“后GPT-6”的叙事已经开始。 无论Bel最终以什么名字发布,OpenAI显然在为GPT-6之后的技术路线做准备。基础模型的迭代周期正在从“年”向“季度”压缩。
AGI话语权的争夺。 将某个模型定位为“AGI门槛模型”,既是技术判断,也是叙事策略。在监管压力和公众期待之间,OpenAI需要为下一代模型找到一个既能支撑估值、又能回应质疑的定位。
保持关注,但不必过度解读
Bel的爆料目前只是一个未经证实的信号。它可能指向一个真实存在的大型基础模型项目,也可能只是内部讨论的碎片被放大。对于关注AI进展的读者来说,有价值的做法是跟踪后续是否出现更多独立来源的交叉验证,而不是对单一爆料下结论。
大模型行业的竞争已经进入深水区,真正的分水岭不在于参数数字的大小,而在于模型能力能否在真实场景中兑现。Bel最终是什么,只能等OpenAI自己揭晓。
相关推荐
Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。
SQL Agent模式选择层实测:Opus竟输给Sonnet,投票机制零收益
开源项目 schemagate 在 BIRD 与 Spider 2.0 上实测 SQL Agent 模式选择层:Opus 在 Spider 2.0 上输给 Sonnet,投票机制留出集收益为零,BigQuery 分片表击穿选表逻辑,基准测试还暴露了权限校验 bug。