Claude多模型报错风波:官方修复与监控中
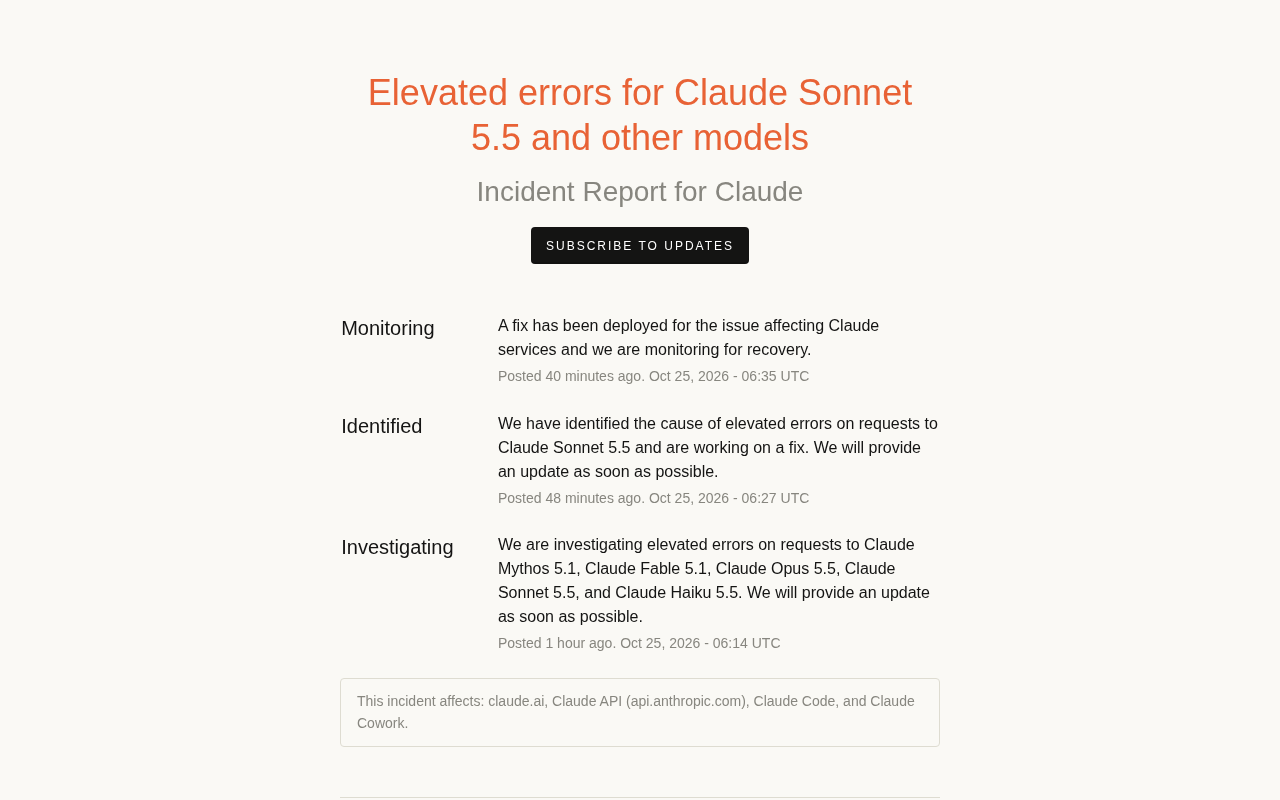
Claude 五个模型同时报错,官方 21 分钟内完成修复部署。
Anthropic 官方状态页披露,Claude Mythos 5.1、Fable 5.1、Opus 5.5、Sonnet 5.5 与 Haiku 5.5 多个模型同时出现请求错误率升高。通报在 UTC 06:14 至 06:35 间经历 Investigating、Identified、Monitoring 三个阶段,约 21 分钟即完成根因定位与修复部署。文章指出,跨型号同时受影响通常指向共享基础设施问题,而非单一模型缺陷,路由层、API 网关或跨模型配置变更都可能是故障放大器。对依赖 Claude API 的开发者而言,此次事件提示应开启状态页订阅、准备跨供应商降级方案,并结合自建监控指标判断是否触发应急预案,因为多模型并不等于多保险。
Anthropic 旗下 Claude 系列模型遭遇了一次不小的风波。根据官方状态页披露,Claude Mythos 5.1、Claude Fable 5.1、Claude Opus 5.5、Claude Sonnet 5.5 以及 Claude Haiku 5.5 多个模型同时出现请求错误率升高的状况,从发现到修复,整个过程持续不到半小时。
事件时间线:从调查到修复的三次通报
官方状态页的通报节奏相当紧凑,三则更新集中在 UTC 时间的 06:14 至 06:35 之间。
06:14 UTC,状态页首次发布「Investigating」通报,确认正在调查多个 Claude 模型请求错误率升高的问题,涉及上述五个模型。
06:27 UTC,状态更新为「Identified」,表示已定位到 Claude Sonnet 5.5 请求错误的根本原因,并正在着手修复,同时承诺尽快提供更新。
06:35 UTC,状态转为「Monitoring」,宣布修复方案已部署,正在监控恢复情况。
从首次通报到宣布修复部署,前后仅约 21 分钟。对于一次影响多个主力模型的线上故障而言,这样的响应速度值得关注。不过状态页并未说明具体的影响范围、错误率数值或受影响的用户比例。
状态页通报中使用的 Investigating、Identified、Monitoring 等术语,源自业界通行的故障事件分级流程。Investigating 表示已确认异常存在但原因未明;Identified 意味着根因已定位并开始处置;Monitoring 则代表修复措施已上线、进入观察期。完整的生命周期通常还会包括 Resolved(确认恢复)与 Postmortem(事后复盘)阶段。这套措辞并非 Anthropic 独有,AWS、Google Cloud、Cloudflare 等主流云服务的状态页普遍采用类似术语体系,便于用户快速判断故障所处阶段并决定是否启动应急预案。理解这些状态词的语义差别,有助于开发者避免把“已定位”误读为“已恢复”。
多模型同时出错的背后:共享基础设施的影子
这次事件最引人注意的地方,是故障的波及面。从通报的措辞来看,Sonnet 5.5 被单独指出为「已定位原因」的模型,而其余模型在初次通报中被一并列出。
这种多型号同时受影响的模式,通常指向共享的底层基础设施问题,而非单个模型自身的缺陷。模型路由层、API 网关、推理集群的公共组件,或者某些跨模型的配置变更,都可能成为故障的放大器。
你可能没注意到,规模更小的 Haiku 5.5 与旗舰级的 Opus 5.5 被放在同一份故障通报中,说明此次受影响的范围跨越了不同层级的模型服务。这对依赖 Claude API 构建产品的开发者来说,是一个现实提醒:即使选择了不同型号的模型做负载分配或降级方案,也未必能完全规避平台级的故障风险。
文中提到的模型路由层,是指位于用户请求与具体模型实例之间的调度组件。它负责根据请求内容、负载情况、可用容量等因素,把流量分派到合适的推理集群或模型版本上。API 网关则承担鉴权、限流、计费与请求转发等职责,是所有模型调用共同经过的入口。推理集群通常由大量 GPU 节点组成,节点调度、显存管理、批处理队列等公共组件一旦异常,就会同时波及多个模型。正因如此,跨型号的多模型故障往往并非各模型自身缺陷,而是这些共享组件或跨模型配置变更所致——这也是文章强调“多模型不等于多保险”的技术依据。
开发者应当吸取的教训
对于把 Claude 集成到生产环境的团队,这次事件提供了几个可以落地的思路。
第一,状态页的订阅机制值得开启。本次事件从调查到修复的通报间隔很短,订阅状态更新能帮助团队在第一时间获知故障,而不是等到用户反馈才被动响应。
第二,跨供应商的降级方案仍然必要。当同一平台内多个模型同时出错时,仅靠模型间的切换无法解决问题,需要提前准备备用的推理服务商或本地模型兜底。
第三,故障通报的粒度有限。官方通报并未给出错误率的具体数字与影响面,团队应结合自身的监控指标(如请求失败率、超时率)来判断是否需要触发应急预案,而非单纯依赖平台方的描述。
跨供应商降级方案通常指在架构中同时接入两家及以上模型服务商,并通过统一抽象层封装调用接口,当主供应商出现故障或延迟升高时,自动或手动将流量切换至备用供应商。与之配套的常见做法包括:设置请求失败率与超时率的告警阈值、采用熔断机制在连续失败时快速停止向故障源发请求、以及用队列和重试策略平滑瞬时抖动。需要注意的是,不同供应商的模型在输出风格、上下文长度与计费方式上存在差异,降级方案需要提前做兼容性测试,而不是故障发生时才临时启用。
小结
这次 Claude 多模型报错事件,从「Investigating」到「Monitoring」仅用了二十余分钟,体现了平台方较快的响应节奏。但对开发者而言,真正的价值不在于赞叹修复速度,而在于意识到平台级故障的不可预测性,并据此完善自身的容错架构。多模型不等于多保险,跨平台冗余与实时监控才是更可靠的防线。
相关推荐
StaffDeck开源数字员工平台:DeepSeek Harness驱动多Agent团队
StaffDeck是一款GPL 3.0开源的企业级数字员工平台,基于DeepSeek Harness驱动,支持多Agent组建AI团队,内置知识库、Skills、SOP广场,并可接入飞书、微信、钉钉等渠道,兼容主流模型协议,三端客户端免费使用。
开源魔兽寻路修复实录:1332行代码填平三年老坑
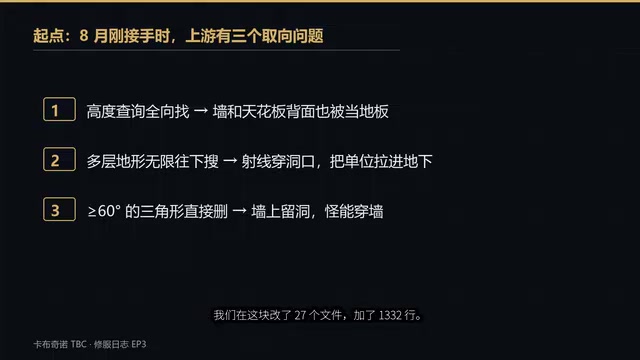
开源魔兽世界修服日志EP3实录:怪物卡闪避、穿墙、悬空、怪不来四大乱象的根因在寻路网格生成层。大肥鱼团队累计改27个文件、加1332行代码,用off mesh自动补连、按格给参数、高度换算向上取整三步修完整条bug链。
DeepSeek 4.1 Flash实测:开源最强模型与DeepInfer的野心
DeepSeek 4.1 Flash 实测解析:开源最强模型在视频生成、3D 游戏、找青蛙测试中的真实表现,以及 DeepInfer 推理引擎公开的缓存命中率、毛利率与华为芯片支持意味着什么。