CLM-8B:对比式语言模型如何实现9倍提速

CLM用双编码器+向量缓存将决策变为相似度检索,比传统生成式模型快最多9倍。
斯坦福与英伟达联合提出的CLM(对比式语言模型)以80亿参数实现了比同规模生成式模型最高9倍的推理提速。其核心思路类比CLIP:用双编码器分别将"当前情境"和"候选动作"映射到同一嵌入空间,决策结果即余弦相似度最高的动作,彻底绕开了逐token生成的自回归开销。更关键的是缓存机制——候选动作集合只需编码一次,后续每步仅需对情境做一次嵌入并与缓存向量做点积,在1000个候选项测试中耗时仅44毫秒,而生成式基线需要579毫秒。代价是各选项独立编码,模型无法在候选项之间进行横向比较,对需要细粒度权衡的复杂决策任务可能存在质量损失。
一种全新的决策范式
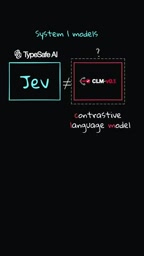
当业界还在围绕生成式(JEPA/Jev风格)模型展开讨论时,来自斯坦福与英伟达研究团队的一款新模型打破了惯性思路。它叫 CLM(Contrastive Language Model,对比式语言模型),参数规模为 80 亿,与大多数主流模型克隆版本相当,但其工作机制完全不同。研究者声称,CLM 的推理速度最高可比传统生成式模型快 9 倍。
问题在于:同样是 80 亿参数,为什么能快出接近一个数量级?答案不在于模型更大或算力更强,而在于它根本不按老办法"生成"答案。
生成式模型的性能瓶颈
要理解 CLM 的优势,先得看清传统生成式决策模型的开销来自哪里。在一个生成式(Jev 风格)模型中,每一次调用都需要把"当前情境"和"所有可选项"一起送进模型处理。
这意味着可选项越多,模型每一步要读取和处理的内容就越多。决策空间一旦扩大,计算量随之线性甚至更快地膨胀。在需要从上千个候选动作中做选择的场景下,这种"全量读入"的方式会迅速成为延迟瓶颈。
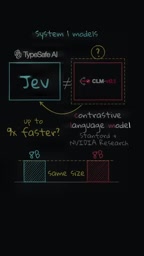
这里的"生成式决策模型"特指以自回归方式输出动作描述或动作 token 的架构,区别于扩散模型等其他生成范式。Jev(Joint Encoder-Value)风格的模型在强化学习与 LLM 结合的研究中较为常见,其特点是把所有候选动作文本拼接到上下文中,让模型在整个序列上做一次前向传播后再从中抽取得分。这导致输入长度随候选数量线性增长,而 Transformer 的自注意力计算复杂度是序列长度的平方级,因此候选项数量翻倍可能带来超过两倍的计算开销。这也是为什么在工具调用、API 路由等需要从数百甚至数千个候选中选择的场景下,生成式路径的延迟往往难以接受。
CLM 的核心机制:像 CLIP 一样做决策
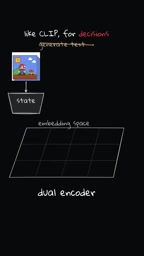
CLM 最直观的类比是 CLIP——只不过 CLIP 用于图文匹配,而 CLM 用于决策匹配。它的关键在于:CLM 从不生成答案。
具体做法是采用双编码器结构:一个编码器负责读取"当前情境",另一个编码器分别读取"每一个可能的动作"。最终的决策结果,就是那个在嵌入空间中与情境距离最近的动作。换句话说,决策被转化成了一次向量相似度的检索问题,而不是一次逐 token 的文本生成。
缓存复用带来的提速
真正让速度拉开差距的是缓存机制。在许多决策场景中,可选动作集合从一步到下一步通常不会频繁变化。CLM 利用了这一点:它把这些动作只编码一次并缓存下来。
于是每进入新的一步,模型要做的仅仅是对当前情境做一次嵌入计算,再与缓存好的动作向量做点积(dot product)。这是一次极其轻量的运算。
在 1000 个候选选项的测试中,CLM 的耗时约为 44 毫秒,而生成式模型需要 579 毫秒——这正是约 9 倍差距的来源。
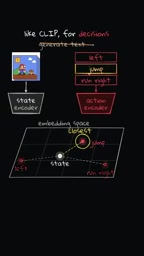
CLIP(Contrastive Language-Image Pre-Training)是 OpenAI 于 2021 年发布的多模态模型,其核心思想是用两个独立编码器分别将图像和文本映射到同一嵌入空间,通过最大化匹配对的余弦相似度、最小化非匹配对相似度来完成训练。这种对比学习范式(Contrastive Learning)的本质是"判别"而非"生成"——模型学习的是如何区分和排序,而不是如何逐步合成输出。CLM 将这一范式平移到决策领域:情境扮演图像的角色,候选动作扮演文本的角色,"最优决策"就是余弦相似度或点积得分最高的那个动作向量。这种迁移的前提假设是:一个好的决策可以用"情境与动作在语义空间中的接近程度"来衡量,而无需模型去"想清楚"整个推理链条。
速度之外的代价
任何架构选择都有取舍,CLM 也不例外。因为每个选项都是独立编码的,CLM 在处理过程中从不把多个选项放在一起横向比较。
这与生成式模型形成鲜明对比:后者在一次前向传播中能够看到所有选项的全局信息,从而进行相互参照和权衡。CLM 的"各自编码"虽然换来了缓存和检索的高效率,但也牺牲了选项之间的直接交互能力。在那些需要在候选项之间进行细粒度比较、相互制约才能做出最优判断的任务上,这一点可能会影响决策质量。
对工程实践的启示
CLM 的思路反映了一个更广泛的工程趋势:当决策可以被重构为"检索最近邻"问题时,用对比学习+向量缓存替代逐步生成,往往能带来数量级的延迟改善。对于动作空间大、候选项相对稳定、且对实时性要求高的应用——如智能体选路、工具调用路由、推荐式决策等——这种架构尤其有吸引力。
不过,是否采用 CLM 式方案,取决于任务对"选项间交互"的依赖程度。如果决策高度依赖候选项之间的相互比较,生成式路径可能仍不可替代;如果决策主要是"情境与动作的匹配度",那么 CLM 提供的速度收益会相当可观。
注:以上内容基于 YouTube 单一来源的介绍,具体性能数字(44ms vs 579ms、9 倍提速)均为视频中引用的研究方声称值,建议以官方论文和基准测试为准。
这一架构与近年来向量数据库(如 Faiss、Pinecone、Weaviate)生态的兴起高度契合。当动作嵌入被预先计算并存入向量索引后,推理阶段的"情境→最近邻动作"检索可以进一步借助近似最近邻(ANN)算法加速,使候选集规模扩展到百万量级仍保持毫秒级响应。这意味着 CLM 式方案天然具备与现有检索基础设施集成的潜力,工程团队可以复用已有的向量搜索工具链,而不必为决策模块单独维护一套生成推理服务。对于动作空间在运行时会缓慢扩展(如新增工具或 API)的场景,只需对新增项做增量编码并插入索引,无需重新处理全量候选集,进一步降低了维护成本。
相关推荐

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。

本地模型为何在Doom游戏决策中击败Jev AI API?
YouTube视频对比显示,本地模型GLiNER在Doom游戏中以12毫秒响应和8.8次/秒决策频率,大幅超越Jev AI API的2.5次/秒,得分翻倍。