CO₂Jump:解决文图联合生成不一致的自纠正采样方法
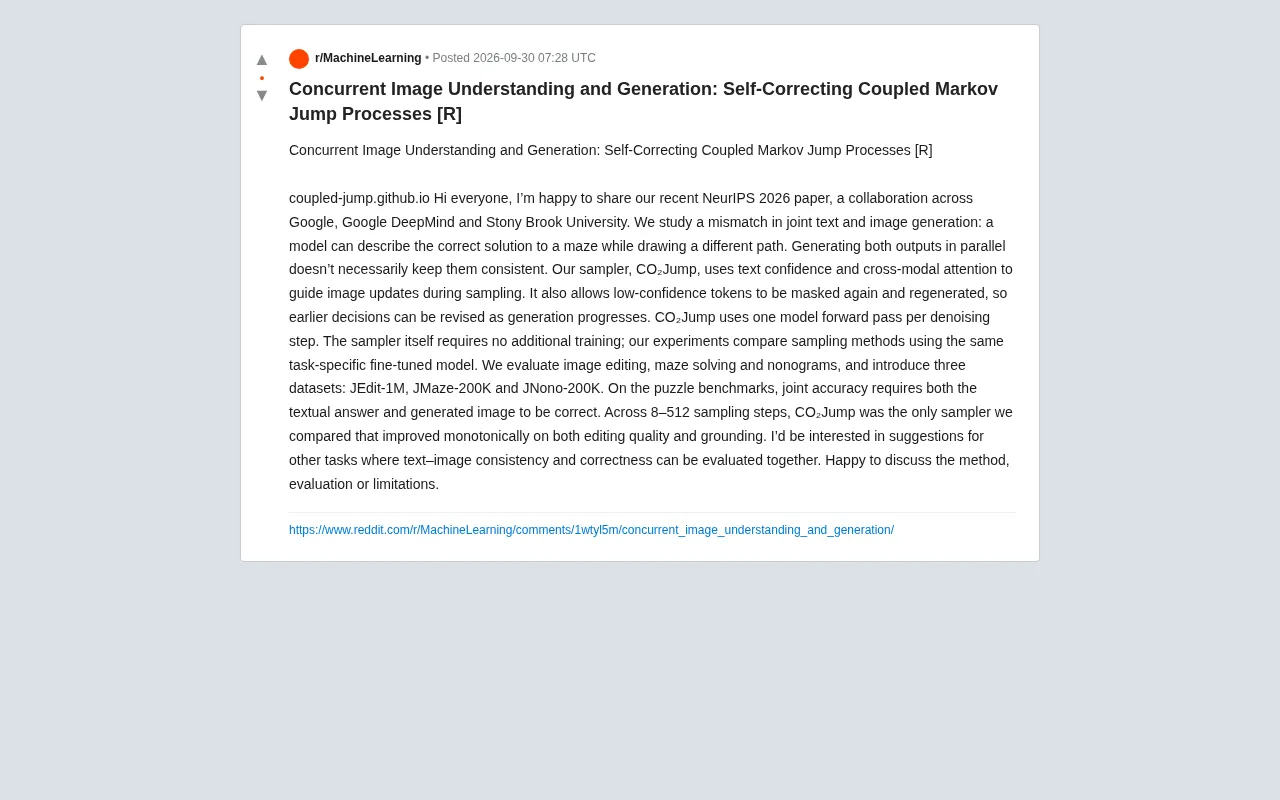
CO₂Jump通过文本置信度引导图像自纠正,解决多模态联合生成中文图不一致问题。
来自Google、Google DeepMind与石溪大学的NeurIPS论文提出CO₂Jump采样方法,专门解决文本与图像联合生成时「说一套画一套」的跨模态不一致问题。其核心机制是利用文本置信度与跨模态注意力引导图像生成,并允许低置信度token被重新掩码再生成,从而实现自纠正。该方法基于耦合马尔可夫跳跃过程,无需额外训练、每步仅需一次前向传播,可即插即用于已微调模型。研究团队同时发布了JEdit-1M、JMaze-200K、JNono-200K三个联合评测数据集,并在实验中证明CO₂Jump是8至512采样步范围内唯一在编辑质量与语义grounding两个维度上均单调提升的采样器。
在文本与图像的联合生成任务中,存在一个长期被忽视的问题:模型可以用文字准确描述出迷宫的正确解法,却在图像里画出一条完全不同的路径。文字与图像各自说得头头是道,合在一起却互相矛盾。来自 Google、Google DeepMind 与石溪大学(Stony Brook University)合作的一篇 NeurIPS 论文,正是针对这个「跨模态不一致」问题提出了新的采样方法 CO₂Jump。
联合生成为何会「说一套画一套」
直觉上,如果让模型同时输出文字答案和对应图像,两者应当保持一致。但现实并非如此。研究者指出,并行生成文本与图像并不能自动保证二者的语义对齐——文字分支和图像分支在采样过程中各自独立演化,缺乏有效的相互约束,最终导致「文字正确、图像错误」或反之的情况。
这种不一致在需要严格逻辑对应的任务里尤为致命。以迷宫求解为例,衡量标准不应只是文字答案对不对,而是文字答案与生成图像是否同时正确。原文将这一指标称为 joint accuracy(联合准确率),只有文本答案和生成图像都正确才算通过,这对模型的跨模态协调能力提出了更高要求。
CO₂Jump 的核心机制
CO₂Jump 的设计思路是让图像生成过程「听取」文本分支的意见。具体而言,它利用文本置信度(text confidence)与跨模态注意力(cross-modal attention)来引导图像在采样过程中的更新,使图像逐步向文本所描述的正确结果靠拢。
更关键的是它的自纠正(self-correcting)能力。传统扩散或掩码生成一旦确定了某个 token,往往难以回头修改。CO₂Jump 允许低置信度的 token 被重新掩码并再次生成,这意味着早期做出的决策可以随着生成推进被修正。这种「可撤销」的特性,正是它得名「自纠正耦合马尔可夫跳跃过程」的原因。
从工程角度看,CO₂Jump 每个去噪步骤只需一次模型前向传播,计算开销可控。更值得关注的是,采样器本身不需要额外训练——实验中对比的各种采样方法使用的是同一个针对任务微调的模型。也就是说,CO₂Jump 是一种即插即用的推理阶段改进,无需重新训练模型即可提升一致性。
「耦合马尔可夫跳跃过程」这一名称来源于随机过程理论。马尔可夫跳跃过程(Markov Jump Process)是一类状态在连续时间内发生离散跳变的随机过程,与扩散模型中常见的连续噪声不同,它更自然地对应离散 token 的掩码与恢复操作。在掩码生成模型(如 MaskGIT 等架构)中,生成过程可以被建模为:从全部被掩码的状态出发,逐步「揭露」token,直至生成完整序列。CO₂Jump 的创新在于将文本和图像两条生成链耦合在同一个跳跃过程中,而非让它们独立演化——文本分支的置信度信号会通过跨模态注意力机制影响图像分支的跳跃方向,使两条链在概率层面互相约束。允许 token 被重新掩码(即从「已揭露」跳回「被掩码」状态)正是跳跃过程双向性的体现,这在标准的单向去噪流程中是不被允许的。
评测任务与数据集
为了系统验证方法,研究团队在三类任务上展开评估:图像编辑(image editing)、迷宫求解(maze solving)和数织(nonograms)。这三类任务的共同点在于,文本与图像的正确性可以被联合、客观地衡量。
配合这些任务,团队还发布了三个数据集:
- JEdit-1M:面向图像编辑任务,规模达百万级;
- JMaze-200K:迷宫求解数据集,约 20 万样本;
- JNono-200K:数织谜题数据集,约 20 万样本。
这些数据集为「文图一致性 + 正确性」的联合评测提供了标准化的基准,也为后续研究者复现和扩展留出了空间。
数织(Nonogram,又称 Picross)是一种逻辑谜题:在网格中,每行和每列都标有数字提示,指示该行/列中连续填色方格的长度与顺序,玩家需根据这些约束推断每个格子是否应被填色,最终拼出一幅像素图案。这类任务对联合评测极为友好:文本输出可以是解题步骤或最终的填色坐标序列,图像输出则是对应的视觉网格——两者的正确性都有唯一客观答案,且可以自动化验证。相比迷宫求解,数织的约束传播更为复杂,要求模型在全局范围内维持行列之间的逻辑一致性,因此对跨模态协调能力的考验更加严苛,也使得「文字说对了但图画错了」的不一致现象更容易暴露。
实验结果:唯一单调提升的采样器
实验最有说服力的结论出现在谜题基准上。在 8 到 512 个采样步数的范围内,CO₂Jump 是所有对比采样器中唯一能在编辑质量(editing quality)与语义 grounding 两个维度上都实现单调提升的方法。
这一点意义重大。许多采样方法在增加采样步数后会出现质量波动甚至退化,而 CO₂Jump 展现出稳定、可预测的性能曲线——步数越多,结果越好,且不牺牲另一维度。对于实际部署而言,这种可控性往往比单点最优成绩更有价值。
局限与展望
作者在分享中保持了开放态度,主动征集其他可以联合评估「文图一致性与正确性」的任务建议,并表示愿意讨论方法、评测与局限。这说明当前的三类任务虽然设计巧妙,但覆盖范围仍有限——它们都属于有明确正确答案的结构化任务,对于更开放、更主观的生成场景(如创意插画、自由问答配图),如何定义和衡量一致性仍是开放问题。
总体而言,CO₂Jump 提供了一个不依赖额外训练、计算开销友好的思路,把「跨模态自纠正」引入联合生成的采样过程。对于关注多模态模型可靠性的研究者和工程师来说,这是一个值得跟进的方向。
相关推荐
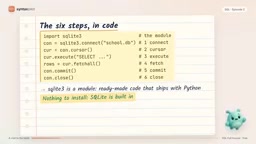
Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。
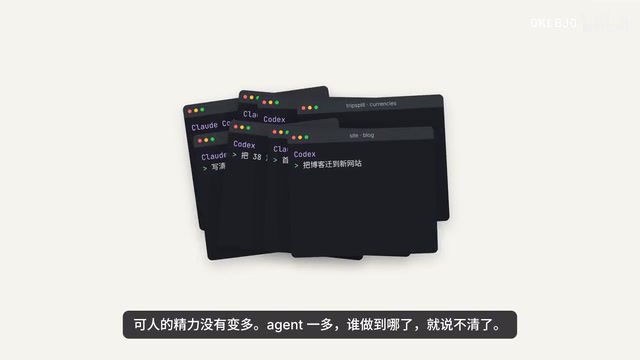
Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。
AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。