CodeMode:让AI代理写代码代替调用工具,token成本直降90%
CodeMode 让 AI 代理编写代码在沙箱中运行,一次往返返回结果,降低 token 成本高达 90%。
传统 AI 代理逐个调用工具并将每个结果塞回上下文,导致 token 消耗大、效率低,尤其在多步骤任务中上下文迅速膨胀。CodeMode 提出让代理编写一个小程序,在沙箱中执行,只返回最终答案,从而实现一次往返交互。据来源称,该方法可将 token 成本降低高达 90%,同时减少信息过载带来的错误。实现需要沙箱环境和代码生成能力,并注意安全与错误处理。适用场景包括多步骤数据处理、上下文受限等任务,简单任务可能不适用。
传统AI代理在调用工具时,往往采用“一次一个”的方式,并将每个结果都塞回上下文。如果任务涉及10张发票,这可能会引发数十次工具调用和成千上万行无关数据。CodeMode 提出了一种截然不同的思路:让代理编写一个小程序,在沙箱中运行,只返回最终答案。这样仅需一次往返,token消耗大幅减少。据 YouTube 来源介绍,这种方法有望将 token 成本降低高达 90%。
传统代理的困境:逐个调用工具导致上下文膨胀
大多数 AI 代理的工作流程是:接收用户请求,决定调用某个工具,等待结果,将结果添加到上下文,再决定下一步。这种循环在简单任务中尚可应付,但面对多步骤、多数据源的任务时,问题迅速放大。
以处理发票为例,代理需要从多个来源获取信息,可能涉及数据库查询、API 调用、文件读取等。每次调用都会产生结果,而每个结果都被完整地粘贴回上下文窗口。代理需要“记住”所有中间结果,以便后续步骤使用,但这导致上下文迅速膨胀。
据来源描述,10 张发票就可能需要数十次调用,并引入数千行代理根本不需要的数据。这些冗余信息不仅消耗 token,还可能干扰模型的推理,降低准确性。
CodeMode 的解决思路:编写程序,沙箱执行
CodeMode 的核心思想是转变代理的角色:从“工具调用者”变为“程序员”。代理不再逐个调用工具,而是生成一段代码,这段代码封装了必要的工具调用逻辑,并在沙箱环境中执行。
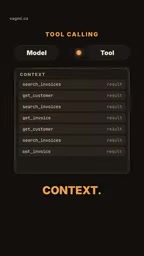
具体来说,代理会分析任务,编写一个程序,该程序可能包含对多个工具的调用、数据过滤、聚合等操作。然后,这个程序在安全的沙箱中运行,直接产出最终结果。代理只接收这个结果,而不是所有中间数据。
这种方法的关键优势在于:代理只需与沙箱进行一次往返交互,而不是多次工具调用往返。同时,代理的上下文只包含最终答案,避免了无关数据的污染。
沙箱(Sandbox) 是一种隔离的运行环境,允许代码执行但限制其对主机系统资源的访问。在 AI 代理场景中,沙箱通常通过容器化技术(如 Docker)或轻量级虚拟机实现,确保代理生成的代码不会危害系统安全。沙箱会限制 CPU、内存、网络和文件系统访问,并可能设置超时机制。对于 CodeMode,沙箱需要支持多种编程语言(如 Python、JavaScript),并提供标准库和必要的依赖,以便代理编写的程序能调用工具接口。同时,沙箱应记录执行日志,便于调试和审计。
一次往返,token 消耗大幅降低
CodeMode 带来的最直接好处是 token 成本的显著下降。据来源称,成本可降低高达 90%。这主要源于两个因素:一是减少了交互次数,二是避免了将大量中间结果塞入上下文。
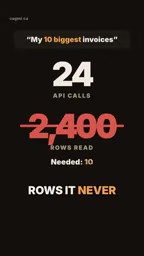
传统模式下,每次工具调用都需要将结果发送给模型,模型再生成下一步动作,这涉及多次 API 调用和大量 token 消耗。而 CodeMode 模式下,代理生成代码后,代码在沙箱中执行,只有最终结果返回给模型。如果任务复杂,这种差异会非常明显。
此外,由于上下文更干净,模型可能表现得更稳定,减少因信息过载导致的错误。
实现要点:沙箱与代码生成
要采用 CodeMode,需要为代理提供一个沙箱环境,并允许它生成可执行代码。沙箱应具备资源限制和安全隔离,防止恶意代码影响主机系统。同时,代理需要具备代码生成能力,这通常依赖于强大的语言模型。
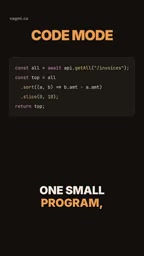
来源建议:“给你的代理一个沙箱,让它写代码。”这暗示了实现路径:集成代码解释器或类似工具,让代理能够编写并运行代码。目前,一些平台已经提供了代码执行能力,但通常用于数据分析,而非替代工具调用。CodeMode 将其扩展为通用的工具调用模式。
代码解释器(Code Interpreter) 是大型语言模型(LLM)的一种扩展能力,允许模型生成并执行代码以完成数据分析、文件处理等任务。典型实现如 OpenAI 的 Advanced Data Analysis(原 Code Interpreter),它在沙箱中运行 Python 代码并返回结果。CodeMode 借鉴了这一思路,但将其从数据分析扩展到通用工具调用:代理不再直接调用工具 API,而是生成调用这些 API 的代码。这要求代码解释器能够访问工具接口(如通过 SDK 或 HTTP 请求),并将执行结果以结构化形式返回给模型。
潜在挑战与适用场景
尽管 CodeMode 前景可观,但也面临挑战。代码生成可能出错,需要沙箱具备错误处理和重试机制。安全风险也需要仔细评估,尤其是当代理可以执行任意代码时。此外,并非所有任务都适合代码模式,简单任务可能直接调用工具更高效。
适用场景包括多步骤数据处理、需要聚合多个工具结果的任务、以及上下文长度受限的情况。对于需要频繁调用工具且中间数据量大的代理,CodeMode 可能带来显著的效率提升。
上下文窗口(Context Window) 是 LLM 单次处理的最大 token 数量(包括输入和输出)。传统代理模式中,每次工具调用的结果都追加到上下文,迅速消耗窗口容量,可能导致关键信息被截断或模型注意力分散。CodeMode 通过将中间数据保留在沙箱中,仅将最终结果返回上下文,显著降低了上下文占用。这对于上下文窗口有限的模型(如 8K 或 16K token)尤为重要,使其能处理更复杂的多步骤任务。
总结
CodeMode 提供了一种创新的代理设计模式,通过让代理编写代码并在沙箱中执行,大幅减少 token 消耗和交互次数。据来源介绍,成本可降低高达 90%。对于构建高效 AI 代理的开发者来说,这值得关注和尝试。
相关推荐
MCP 是什么?让 AI 接入所有工具的开放标准
MCP(Model Context Protocol)是让 AI 应用统一接入各类工具的开放标准。本文解析 MCP 的 Host、Server、Client 三角色,Tools、Resources、Prompts 三构建块,一次工具调用的完整链路,以及在 n8n 中的双向用法与安全风险。
MCP图解:AI Agent如何连接你的应用
MCP图解:AI Agent如何连接你的应用
从电商客服机器人场景出发,图解MCP(Model Context Protocol)如何解决AI应用与外部工具的M×N集成困境,对比REST API直连的缺陷,解析Tools/Resources/Prompts三大原语、Host-Client-Server三层架构、stdio与streamable HTTP传输,以及认证授权、凭证管理与prompt injection防护要点。
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。