开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
ApexW 用紧凑状态与 Triton 内核在优化器基准中快 1.5 倍,但小张量与自动模式仍是短板。
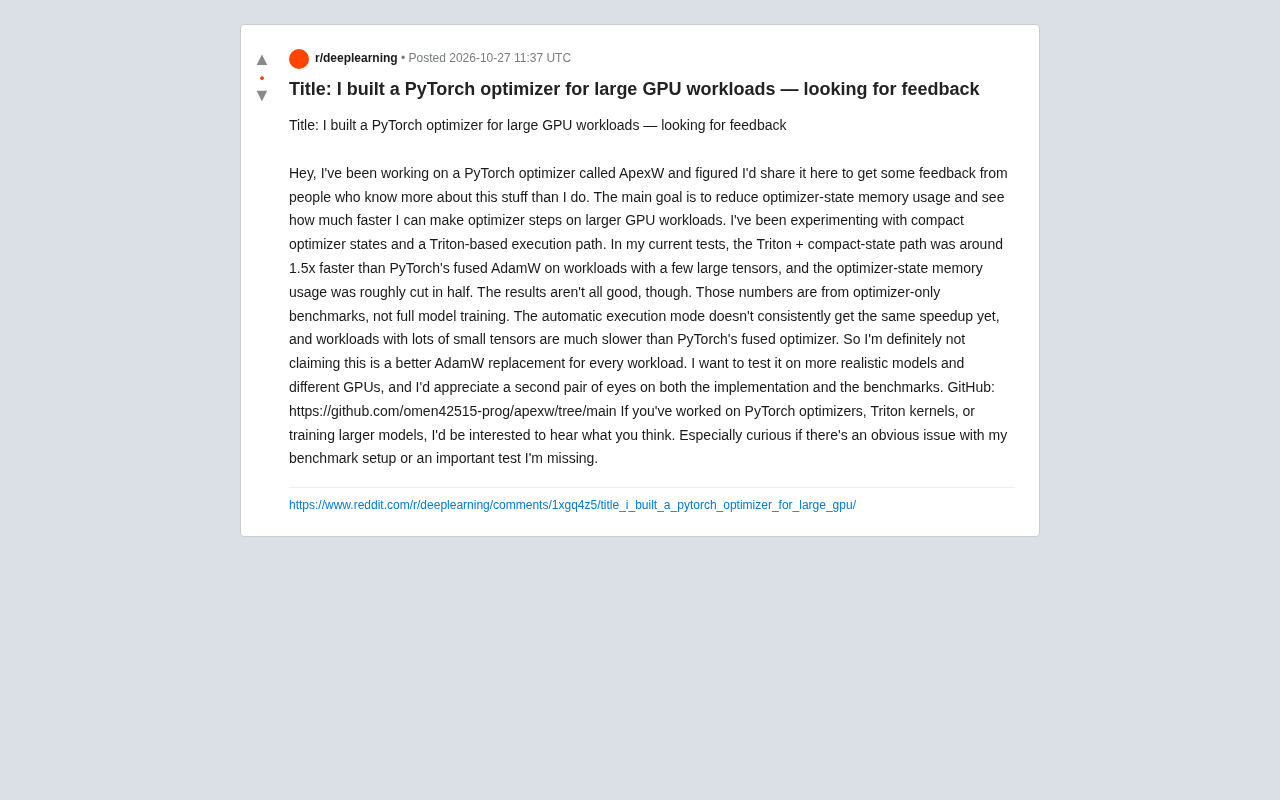
开发者开源的 PyTorch 优化器 ApexW 通过紧凑状态表示和 Triton 融合内核,在仅优化器的基准中比 PyTorch fused AdamW 快约 1.5 倍,状态显存占用约减半。但这些数字仅来自 optimizer-only 测试,端到端收益取决于优化器步骤在训练中的时间占比。作者坦言自动执行模式尚不能稳定复现加速,大量小张量负载下明显慢于 PyTorch fused 优化器。项目仍处实验阶段,作者公开征集实现与基准设置方面的反馈,尚未在多 GPU 架构和真实模型上验证,现阶段更适合跟踪而非生产替代。
一位开发者在社区分享了自己构建的PyTorch优化器ApexW,目标直指大GPU负载下的优化器状态显存占用和更新速度。按照作者的说法,在仅针对优化器本身的基准测试中,采用Triton执行路径加紧凑状态表示的ApexW,比PyTorch fused AdamW在"少量大张量"场景下快约1.5倍,优化器状态显存占用大致减半。但他同时坦言,自动执行模式目前还不能稳定复现这一加速,而"大量小张量"的工作负载反而明显慢于PyTorch fused优化器。
紧凑状态与Triton内核:ApexW的两个技术支点
ApexW的设计思路集中在两件事上:压缩优化器状态,以及用Triton重写执行路径。AdamW这类自适应优化器需要为每个参数维护一阶和二阶动量,参数量越大,这部分状态占用的显存就越可观。紧凑状态表示试图降低这部分开销,而Triton内核则把逐元素更新操作融合成更少的GPU launch,从而减少调度与访存开销。
这两个方向都不算新概念,但把它们组合成一个可直接替换的优化器实现,并公开基准结果,是这个项目值得关注的地方。作者没有停留在"我写了个更快的优化器"的口号上,而是主动列出了失败场景,这在同类分享中并不多见。
AdamW 与优化器状态:AdamW 是 Adam 优化器的解耦权重衰减变体,广泛用于训练 Transformer 等深度网络。它需要为每个可训练参数维护两组与参数同形状的滑动统计量——一阶矩(动量,梯度的指数移动平均)和二阶矩(梯度平方的指数移动平均),通常以 FP32 存储。对 70 亿参数模型而言,仅这两份状态就约需 56 GB 显存,远超模型参数本身(以 BF16 存储约 14 GB)。所谓“紧凑状态表示”,本质是降低这两份动量张量的精度或采用分块/量化方式压缩存储,从而削减这部分固定开销;代价是可能损失更新精度,因此需要验证在真实训练中是否影响收敛。
Triton 内核与 kernel launch 开销:Triton 是 OpenAI 开源的 GPU 编程语言与编译器,用 Python 编写类 CUDA 的内核,可跨 NVIDIA 与 AMD GPU 编译执行。优化器更新是逐元素运算,若每个张量都调用一次 PyTorch 原生算子,会产生大量独立的 kernel launch,每次都有调度与同步开销。fused 优化器的思路是把多个逐元素操作合并进单个内核,减少 launch 次数与显存往返。这也解释了“少量大张量”更快、“大量小张量”更慢的现象:融合带来的固定开销只有在大张量上才能被摊薄。
1.5倍加速的前提:只测了优化器,没测完整训练
需要强调的关键限制是,这些数字来自optimizer-only benchmarks,而非完整模型训练。优化器步骤在端到端训练中只占一部分时间,实际训练能获得多少收益,取决于前向、反向与优化器更新之间的时间比例。如果优化器本身占比较小,即使单步快1.5倍,整体训练加速也会被稀释。
另一方面,"少量大张量"是一个相对狭窄的甜点区。大型语言模型或大规模视觉模型中的参数矩阵确实符合这一特征,但真实网络的参数分布往往混杂着大量归一化层、偏置项等小张量,这正是ApexW当前的软肋。
optimizer-only 基准的含义:这类基准只循环执行优化器 step,不包含前向传播与反向传播,因此测到的是优化器步骤的纯耗时。在典型训练中,优化器更新通常只占单步总时间的 5%–15%(视模型与 batch 而定),前向与反向占据大头。若优化器本身快 1.5 倍,在优化器占比 10% 的情形下,端到端加速约为 1/(0.9+0.1/1.5)≈1.03,即仅 3% 左右。因此评估此类结果时,必须结合 profile 中优化器步骤的实际占比来折算,不能把 1.5 倍直接等同于训练加速。
PyTorch fused AdamW 基线:PyTorch 自 2.x 起提供了 fused=True 的 AdamW 实现,用单个 CUDA 内核完成参数更新,已是官方优化路径。任何新优化器若要与它比较,应在相同精度状态、相同编译选项(如 torch.compile)下进行,否则加速可能来自基线配置不当而非算法本身。
小张量场景与自动模式:两个尚未解决的短板
作者明确表示,自动执行模式(automatic execution mode)还不能稳定拿到同样的加速比。这意味着当前版本可能需要手动指定执行路径才能触发最佳性能,对普通用户来说多了一层调优成本。
更说个细节小张量场景的性能退化。大量小张量的工作负载下,ApexW明显慢于PyTorch fused优化器。一个可能的解释是每个张量都需要独立的kernel launch或状态处理,紧凑状态的固定开销在小张量上无法被摊薄。作者自己也承认,这不是一个可以无条件替代AdamW的方案。
自动执行模式与手动路径选择:所谓自动执行模式,指优化器根据参数形状、数量等启发式规则自动决定走 Triton 融合内核还是回退到常规实现。若启发式判断不准,可能在小张量上错误地启用融合路径,或在应融合时回退,导致性能不稳定。手动指定执行路径可绕过这一不确定性,但要求使用者了解自身负载特征,增加了调优门槛。这也提示:一个可替换优化器要真正可用,自动调度策略的鲁棒性与性能同等重要。
社区反馈的看点:基准设置与缺失测试
作者在帖子里主动征集两类反馈:实现层面的问题,以及基准测试设置层面的问题。他特别想知道benchmark setup是否有明显缺陷、是否遗漏了重要测试。
从外部视角看,几个值得追问的方向包括:基线是否使用了相同精度的状态表示、是否开启了torch.compile等同等优化、计时是否包含kernel launch与同步开销、以及显存统计的口径是峰值还是稳态。这些细节直接决定1.5倍和"减半"这两个数字能否复现。此外,在多种GPU架构上验证也尚未完成,作者表示希望在不同GPU和更真实模型上继续测试。
基准复现需核对的口径:显存统计应区分峰值(peak allocated/reserved)与稳态占用,PyTorch 可用 torch.cuda.max_memory_allocated 与 memory_reserved 分别度量;计时需在每次迭代后同步(torch.cuda.synchronize)并预热若干步,以排除 kernel launch 异步与首次编译的影响;基线状态精度须与 ApexW 的紧凑表示对齐,否则“减半”可能只是精度差异而非算法收益。此外,不同 GPU 架构(如 Hopper 与 Ampere)对内核融合与显存带宽的敏感度不同,单卡结果不足以代表普遍性能。
对实践者的意义
ApexW目前更适合被看作一个值得跟踪的实验性项目,而不是生产环境的AdamW替代品。如果你的训练负载以大张量为主、且优化器步骤在profile中占比较高,它提供了一个可能的优化方向;如果你的模型参数碎片化严重,现阶段的表现可能不如内置方案。作者公开征集反馈的态度,也让这个项目具备了继续迭代的基础。
项目代码已发布在GitHub上,仓库地址为github.com/omen42515-prog/apexw。
相关推荐
MCP 是什么?让 AI 接入所有工具的开放标准
MCP(Model Context Protocol)是让 AI 应用统一接入各类工具的开放标准。本文解析 MCP 的 Host、Server、Client 三角色,Tools、Resources、Prompts 三构建块,一次工具调用的完整链路,以及在 n8n 中的双向用法与安全风险。
MCP图解:AI Agent如何连接你的应用
MCP图解:AI Agent如何连接你的应用
从电商客服机器人场景出发,图解MCP(Model Context Protocol)如何解决AI应用与外部工具的M×N集成困境,对比REST API直连的缺陷,解析Tools/Resources/Prompts三大原语、Host-Client-Server三层架构、stdio与streamable HTTP传输,以及认证授权、凭证管理与prompt injection防护要点。
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。