Codex+Playwright打造测试Skill:告别手敲命令的UI自动化

将Playwright封装为Agent的Skill操作手册,让自然语言驱动UI自动化测试并输出可维护脚本。
本文介绍了一种将Playwright CLI封装为"测试Skill"的UI自动化方案。传统做法中,测试人员需逐条手写CLI命令、人工查找REF元素编号,AI Agent缺乏统一操作手册导致每步都需人工指挥。Skill的核心价值是把命令选择、快照读取等隐性知识固化为结构化手册,让Agent凭自然语言描述即可自动编排并执行测试流程。与Playwright MCP方案相比,Skill无需预先将20余个工具Schema灌入上下文,采用按需读取YAML的方式大幅节省Token,更适合多步骤的长流程回归测试。搭建仅需安装Skills、重启Codex确认加载、自然语言描述目标三步,最终可将测试结果沉淀为符合PO分层规范的可维护脚本资产。
为什么UI自动化总让人头大
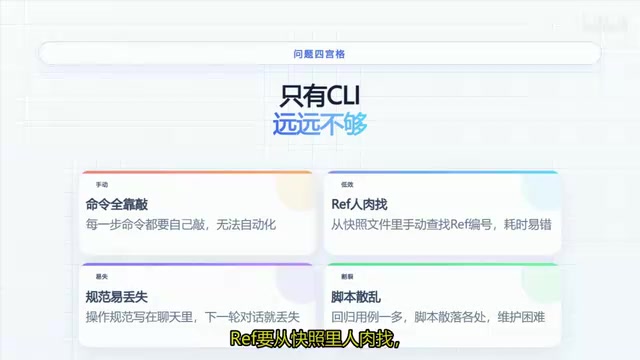
写过Playwright自动化脚本的测试同学,大概都经历过这样的流程:拿到一个测试场景,手写open、snapshot、click、fill,一行行敲命令;遇到页面元素还要翻快照文件找REF编号;回归用例一多,脚本散落各处,维护起来苦不堪言。
本质问题在于,每一条Playwright CLI命令都依赖人工输入。测试同学与其说在写用例,不如说是在敲命令。更棘手的是,AI Agent没有一份操作手册——它不知道什么时候该用open,什么时候该用snapshot,REF编号要从哪份快照文件里读,什么时候开有头模式,什么时候落盘截图。结果就是每一步都得你亲自指挥AI,才能推进一小步。
据B站UP主的实战演示,理想状态应该是:你只用自然语言描述测试目标,比如"登录SauceDemo,加购一件商品,完成结算",AI就自动帮你编排CLI命令、执行操作、产出脚本。这正是把Playwright封装成"测试Skill"想要解决的核心痛点。
CLI只是半成品,CLI+Skill才是完全体
很多测试同学觉得,能用Playwright CLI敲命令已经很不错了。但从这套方案的视角看,光有CLI只是半成品。
只有CLI的时候,每一步命令都要自己敲,REF要从快照里人肉查找,规范写在聊天里,下一轮对话就丢了。而加上Skill之后,你只需要用自然语言描述测试目标,Agent就会按照Skill里的说明自动选命令、读词盘YAML、输出脚本。
换句话说,Skill就是Agent的操作手册。它把"什么场景用什么命令"这套隐性知识固化下来,让AI不再需要你手把手指挥。这一转变的意义在于,测试的输入端从"命令语言"回到了"自然语言",把人从琐碎的命令编排中解放出来。
三步搭建Playwright测试Skill
整套搭建流程可以拆成三步,简洁到几乎没有门槛。
第一步:安装配套Skills
在项目目录或全局执行安装命令(playwright clean install skills),官方Skill会自动复制到Skill目录。如果没有放到扫描路径,手动拷贝到agents/skills/playwright目录即可。
第二步:确认加载
重启Codex,在插件技能里确认Playwright Skill已经加载。这里有个关键点:不需要配置MCP服务器,AI直接通过Shell执行Playwright CLI来操控浏览器。

第三步:用自然语言驱动测试
Skill就位后,执行链路是这样的:Agent先匹配Description、读手册,再通过Shell跑命令,按需读取快照,最后产出脚本。测试同学只要把目标说清楚,剩下的编排、执行、落盘全部由Agent自动完成。
Skill方案为什么比MCP更适合长流程
提到用Playwright做UI自动化,不少人第一反应是Playwright MCP。那么Skill和MCP到底差在哪?

MCP的问题在于,它要把20多个工具的Schema提前灌进上下文。做长流程回归测试时,上下文根本扛不住——工具定义占用了大量Token,链路一长就容易崩。
相比之下,Skill方案让Agent按需读取词盘上的YAML和快照文件,不用把全部工具定义塞进上下文。这带来两个直接好处:一是不烧Token,二是规范不会在多轮对话中丢失。对于动辄几十步的回归用例来说,这种"按需加载"的设计明显更抗压。
MCP(Model Context Protocol)是Anthropic提出的一种开放协议,旨在让AI模型通过标准化接口调用外部工具。在Playwright MCP的实现中,每个可调用的浏览器操作(如点击、输入、截图、导航等)都需要以JSON Schema的形式声明工具定义,并在对话开始前一次性注入上下文。Playwright官方MCP服务器目前暴露的工具数量超过20个,这些Schema本身就会消耗相当数量的Token。对于短流程的单次任务,这种开销尚在可接受范围内;但回归测试动辄需要数十轮操作,Token预算会被工具定义大量占用,可供模型推理和记录中间状态的空间随之压缩,长链路任务中断的概率显著上升。Skill方案绕过了这一协议层,直接让Agent通过Shell调用Playwright CLI可执行程序,工具描述只保存在本地YAML文件中,需要时才读入上下文,从根本上避免了"工具定义预占Token"的结构性问题。
从一次性脚本到可维护的测试资产
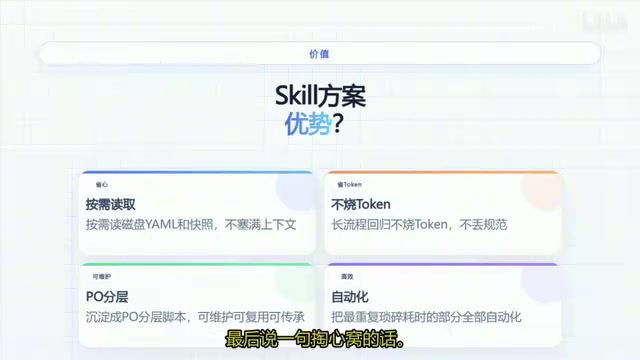
这套方案还有一个容易被忽略的价值:它可以把测试结果沉淀成PO(Page Object)分层脚本,而不是跑完就扔的一次性脚本。这意味着产出的是可维护、可复用、可传承的测试资产。
正如原作者所言,UI自动化最耗时的从来不是执行,而是写命令、找元素、维护脚本这些重复琐碎的环节。Skill把这些最耗时的部分自动化后,你不用再纠结"这条命令该用open还是goto""那个REF编号是多少",只需要"说人话",剩下的交给Agent。
PO(Page Object)是UI自动化领域的经典设计模式。其核心思想是将页面的元素定位与交互逻辑封装成独立的"页面对象"类,测试用例只调用这些对象提供的方法,而不直接操作DOM选择器。这样当页面结构发生变化时,只需修改对应的Page Object类,而不必逐一修改每一条测试用例。相比于将所有操作直接写进测试脚本的"平铺式"写法,PO分层结构的可维护性和可复用性都要高出一个量级。AI Agent在产出脚本时能够按照PO模式进行分层输出,意味着自动生成的代码不只是满足当次执行需求的临时产物,而是符合工程规范、可以纳入代码仓库长期维护的正式测试资产。
写在最后
从工程角度看,把Playwright封装成Skill的思路,代表了AI辅助测试的一个务实方向:不追求大而全的工具接入,而是用一份结构化的"操作手册"降低Agent的认知负担和Token开销。对于需要频繁跑长流程回归的团队而言,这种轻量、按需加载的模式,确实比重量级的MCP方案更接地气。
需要提醒的是,本文内容基于单一UP主的演示分享,实际落地时仍需结合自身项目环境验证安装路径、Skill加载和执行链路的稳定性。
相关推荐

Rysh Forge 实测:一份 OpenAPI 规范自动生成 Claude 可调用的 Agent 工具
Rysh Forge 用一条命令把 OpenAPI 规范自动转换成 Claude 可调用的 Agent 工具,同时生成 MCP server、Python SDK 和文档,并对写操作强制人工确认,实现全链路可观测。本文解析其工作流与价值。

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。