AI编程助手选择指南:Codex vs Grok深度对比
真实场景下的工具选择难题
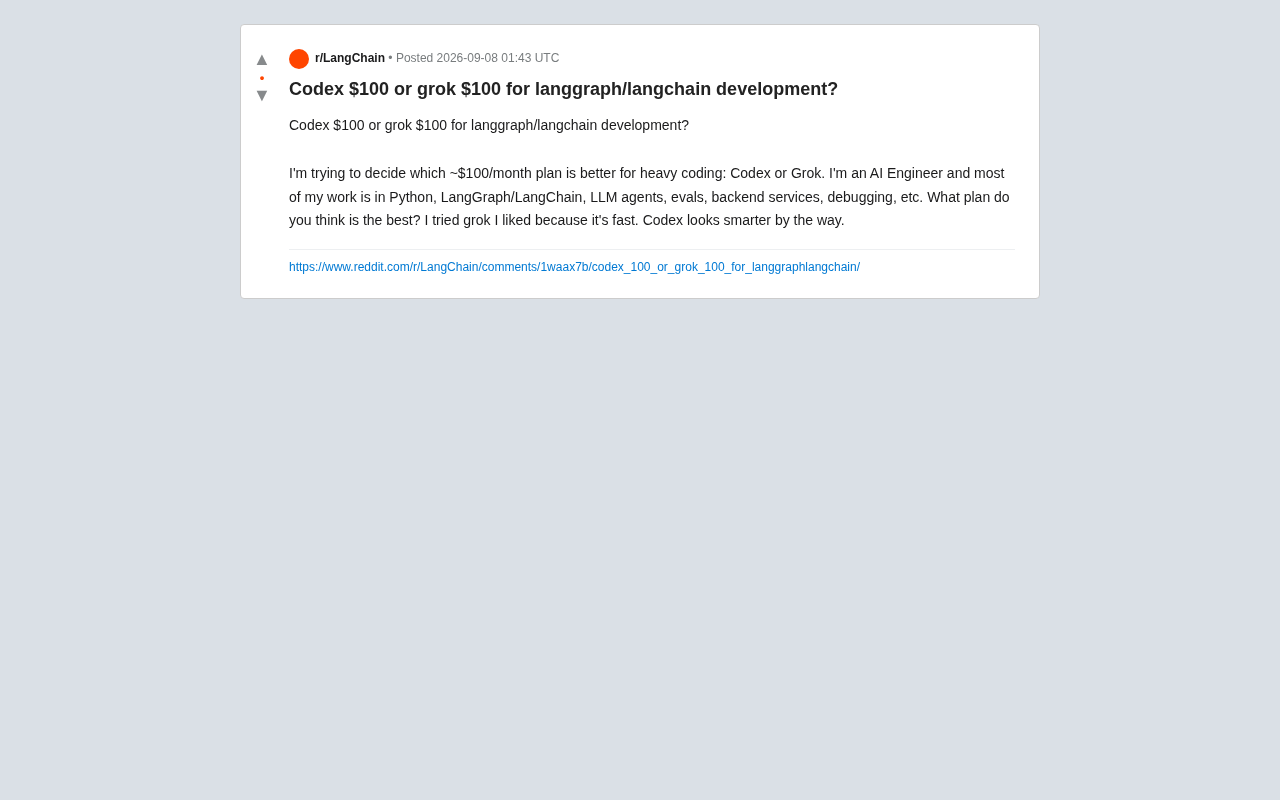
AI编程助手已从辅助工具演变为核心生产力组件。一位Reddit开发者提出的问题具有典型性:月预算100美元,在OpenAI Codex与xAI Grok之间如何抉择?特别是在LangGraph/LangChain这类复杂框架的开发场景下。
这位开发者的需求场景明确:Python开发为主,围绕LangGraph/LangChain构建LLM智能体,涉及评估测试、后端服务和调试工作。他的初步判断是——Grok响应更快,Codex推理更深。这个对比揭示了当前AI编程工具的核心权衡点:速度与深度的平衡。
速度与推理:不同的技术路线
Grok的速度优势
Grok在响应延迟上的表现源于xAI在推理架构上的优化。对于需要高频迭代的开发任务——调试LangGraph状态流转、快速生成样板代码——低延迟能显著提升开发节奏,减少思路中断。
但速度并非唯一标准。在复杂智能体架构设计中,一次高质量的深度回答,往往比多次快速但需修正的输出更高效。这正是开发者面临的真实矛盾。
Codex的深度推理能力
"Codex更聪明"的评价背后是OpenAI在代码理解上的技术积累。基于GPT架构优化的Codex在多文件上下文理解、复杂依赖分析、结构化代码生成方面表现突出。
对于LangGraph这类需要精确理解状态机、节点关系和条件路由的框架,模型的深度推理能力至关重要。LangChain生态更新频繁,一个能准确把握框架语义、减少幻觉的模型可以大幅降低调试成本。
LangGraph/LangChain开发的特殊需求
框架API的准确性
LangGraph/LangChain以快速迭代著称,文档往往滞后于代码更新。许多AI模型因训练数据时效性限制,容易生成已废弃的API或错误用法。选择工具时,需要关注其对最新框架版本的掌握能力和上下文学习能力。
智能体调试的认知负荷
LLM智能体调试需要追踪prompt演变、工具调用链路和状态图流转。这类高认知负荷任务对长上下文推理能力要求极高。Codex在整个调用链中定位问题根源的能力可能更有优势。
评估代码的质量要求
评估(Evals)代码涉及大量结构化逻辑和边界条件处理。生成可读性强、边界考虑全面的评估代码,直接影响智能体质量判断的准确性。
理性决策框架
与其纠结绝对优劣,不如从实际工作模式出发评估:
- 原型开发和样板代码生成为主:Grok的速度优势能提供更流畅的开发体验
- 复杂架构设计和深度调试为主:Codex的推理深度可能带来更高净生产力
更实用的建议是:用真实项目进行一周对比测试。选择代表性任务——实现多智能体LangGraph工作流、调试生产bug、编写评估脚本——分别在两款工具上完成,记录从提问到可用方案的实际耗时和返工次数。这比主观感受更可靠。
工具匹配工作流才是关键
月投入100美元本质上是在购买时间效率。对AI工程师而言,代码助手的价值不在于单一维度的性能,而在于能否融入工作流、降低认知摩擦。
速度与智能之间没有通用答案,只有与个人工作模式最契合的选择。开发者的直觉——Grok快、Codex深——已经抓住核心差异。剩下的工作是用实际数据验证哪个优势对你更重要。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。