Codex零基础实战:不写代码完成全栈世界杯应用

引言:让AI替你写代码、看球、解说
2026年世界杯激战正酣,一位开发者决定不再手动收集数据,而是用OpenAI的Codex,花两天时间从零搭建了一套完整的世界杯应用系统——包括全栈网站、数据库、桌面宠物、语音解说、定时任务和专属Skill。整个过程不写一行代码,全靠提示词驱动。
OpenAI Codex是2025年推出的云端AI编程代理,基于codex-1模型(经过强化学习专门优化的编码模型),能够在云端沙盒环境中自主执行多步骤的软件工程任务。与传统的代码补全工具不同,Codex更像是一个具备独立执行能力的软件工程师——它可以读取整个代码仓库、理解项目结构、编写代码、运行测试,并最终提交结果。它的核心优势在于能够并行处理多个任务,每个任务在独立的沙盒中运行,互不干扰。
这篇文章将完整拆解这套系统的构建思路,涵盖Codex的多会话并发、MCP服务搭建、Skill封装以及定时任务自动化等核心能力,适合所有想用AI提升开发效率的朋友。
一份提示词搭建全栈框架
通用模板 + 子代理并发
项目的起点是一份精心设计的提示词。虽然看起来字数很多,但作者使用的是每个项目都复用的通用模板,大约两分钟就能写好。提示词中明确规定了前端技术栈、后端框架、数据库结构等关键信息,确保大模型能一次性成功生成。
关键操作包括:
- 将思考强度调到超高,因为需要一口气完成整个全栈框架
- 开启Codex自带的Product Design模式,内置设计规范可以省掉大量UI约束
- 明确要求"请完整实现所有代码和设计"
执行后,Codex自动创建了三个子代理(智能体),分别负责获取本届世界杯数据、过去两届世界杯数据,以及设计工作。同时,主任务继续编写代码和搭建数据结构——数据采集和代码开发并发执行,大幅节省时间。
所谓子代理,是Codex在执行复杂任务时自动拆分出的并行工作单元。当主任务足够复杂时,Codex会判断哪些子任务可以独立执行,然后生成多个子代理同时工作。每个子代理拥有独立的执行环境和上下文窗口,完成后将结果汇报给主任务进行整合。这种机制类似于软件工程中的多线程并发,但应用在了AI推理和代码生成层面,使得原本需要串行完成的工作可以大幅压缩时间。
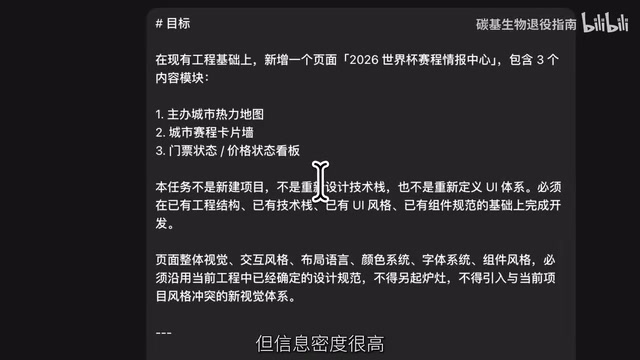
最终,34分钟内输出了2000多行代码,提示词要求的UI组件全部到位,配色和布局效果相当不错。
制作桌面宠物"懂球喵"
多会话并行提升效率
Codex支持在同一项目中同时开启多个独立会话,每个会话拥有独立的上下文。趁主会话还在构建网站框架时,作者新建了第二个会话来制作桌面宠物。
这只名为"懂球喵"的桌宠设定非常有趣:
- 外表软糯可爱,性格犀利爱吐槽
- 喜欢吃薯片,能陪主人看球到凌晨
- 招牌动作是边吃薯片边看球
使用Codex内置的宠物创建技能,约28分钟后宠物制作完成。Codex自动生成了JSON角色设定文件和sprite sheet(动作精灵图),包含向左跑、向右跑、跳跃、吃薯片等多组连续动作。
Sprite Sheet(精灵图)是游戏和动画开发中的经典技术,将角色的所有动作帧排列在一张大图上。程序运行时通过控制显示区域的偏移来实现逐帧动画效果。相比加载多个独立图片文件,精灵图只需一次资源加载即可获取所有动画帧,大幅减少资源请求数和内存碎片。在桌面宠物场景中,精灵图通常包含待机、行走、跳跃、特殊动作等多组动画序列,每组由若干等尺寸的帧组成。
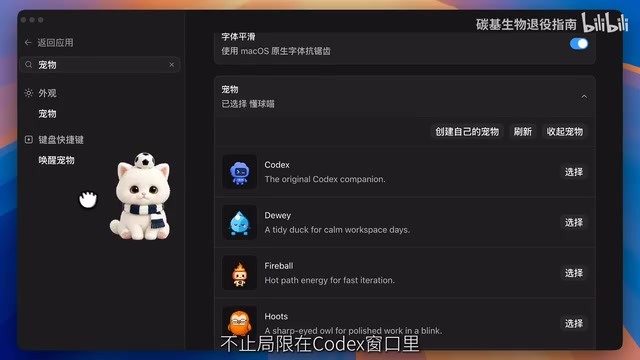
宠物不仅限于Codex窗口内,可以在整个桌面自由拖放,还能绑定快捷键(如Ctrl+Q)快速唤醒或隐藏。虽然精灵图的个别帧存在切图偏移的小瑕疵,但整体效果已经非常出色。
MCP本地语音合成:让小猫开口说话
搭建MCP服务调用TTS
要让懂球喵真正"解说"比赛,首先需要语音合成能力。作者选择了一套完全本地化的方案:通过创建MCP服务,让Codex调用Kokoro模型的TTS合成。
什么是MCP? MCP(Model Context Protocol,模型上下文协议)是Anthropic于2024年底提出并开源的标准协议,旨在为大语言模型提供统一的外部工具调用接口。它采用客户端-服务器架构:MCP服务器暴露特定能力(如文件操作、API调用、数据库查询等),MCP客户端(即AI应用)通过标准化的JSON-RPC协议与服务器通信。MCP的意义在于解决了"每个AI应用都要单独适配每个外部工具"的N×M集成问题,将其简化为N+M的标准化对接。目前OpenAI、Google等主流AI平台均已支持MCP协议。在这个项目中,作者做的就是让Codex写一段符合MCP规范的代码,使GPT知道如何调用本地的语音合成服务。
Kokoro是一个开源的轻量级文本转语音(TTS)模型,参数量仅约8200万,却能生成接近商业级质量的语音。它支持多种语言和声音风格,推理速度极快,在普通CPU上即可实时运行,无需GPU加速。Kokoro采用了基于StyleTTS2的架构,通过风格扩散和对抗训练实现高自然度的语音合成。其完全本地化运行的特性意味着无需网络请求、无API费用、无隐私泄露风险,非常适合作为个人项目的语音合成方案。
配置完成后,只需告诉Codex"合成语音",它就会自动调用MCP完成TTS。
MCP与Skill的核心区别
这里有一个很实用的判断方法:
- MCP:如果想给大模型增加的能力完全可以通过代码实现(如TTS合成、数据库操作、文件读写),就做成MCP
- Skill:如果任务不能只靠代码,还需要把你的经验和执行流程交给大模型,就做成Skill
一个关键规则:Skill可以调用MCP,但MCP不能反过来调用Skill。这个设计逻辑很清晰——MCP是底层能力层,提供原子化的工具调用;Skill是上层编排层,定义了何时、如何、以什么顺序调用这些底层能力。
Skill封装 + 定时任务自动化
从手动到全自动的飞跃
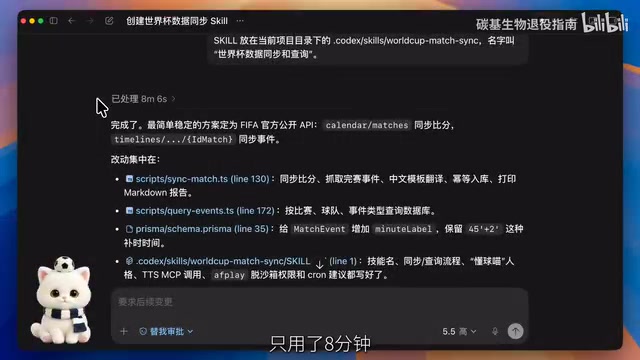
作者将整套流程封装成了一个可复用的Skill,包含:
- 世界杯数据同步脚本(自动获取比分和关键事件)
- 入库脚本(写入数据库)
- 懂球喵解说词生成(含人设和风格定义)
- TTS语音合成和播放
Codex中的Skill本质上是一种结构化的提示词模板加执行流程的封装。它不仅包含代码逻辑,还包含了人类经验、判断标准和执行顺序等"隐性知识"。这种设计借鉴了软件工程中"标准操作流程(SOP)"的思想——将专家的工作方法文档化,使其可被重复执行。Skill的价值在于将一次性的提示词工程转化为可复用的资产,避免每次都要重新向AI解释上下文和约束条件。
整个Skill只用了8分钟就完成创建。之后通过斜杠命令即可一键触发,再也不需要重复说明流程或定义人设。这种模块化的产品设计方式非常值得推荐。
定时任务配置
为了实现完全自动化,作者让Codex将Skill配置为定时任务:
- 每天最多执行三次
- 具体时间根据世界杯赛程表设定
- 有一个贴心的约束:不能放在深夜(否则突然响起比赛解说确实有点瘆人)
不到一分钟定时任务就配置完成,第二天上午自动执行时成功查到两场比赛结果并写入数据库,同时生成解说文案和TTS语音。
集成到网站的完整体验
悬停即解说的交互设计
定时任务运行两天后,网站上已经积累了丰富的比赛数据。交互设计非常巧妙:鼠标在某场比赛上悬停两秒,懂球喵就会自动解说。
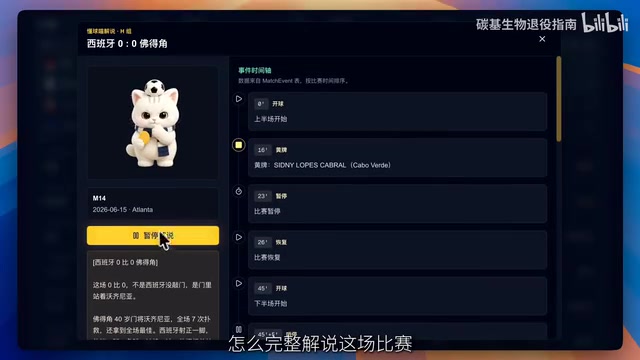
懂球喵的解说风格确实犀利又有趣,比如评价德国7比1库拉索:"这不是小胜,这是德国把比赛从第一档一路拧到最大档";评价西班牙被佛德角逼平:"西班牙围攻90分钟,沃奇尼亚把球门守得干干净净,西班牙最后缺的不是控球,是能把沃奇尼亚打穿的那一下。"
解说动画的工程优化
作者还将懂球喵的不同状态(赢球解说、平局解说、基础形象)抽象为独立组件,与语音组件统一组装。比如用小猫拿薯片思考的动图作为平局解说动画,用另一个张嘴说话的动图作为大比分获胜的解说动画。
这种组件化的做法,对于现在的大模型来说已经是非常简单的拼接工作。通过将视觉状态、音频播放、文本内容解耦为独立模块,不仅便于维护和迭代,也让AI在后续修改时能精准定位需要调整的部分,而不必重新理解整个系统。
总结与启示
这个项目展示了Codex在实际开发中的几个核心能力:
- 多会话并发:同时推进代码开发和宠物制作,半小时搞定两件大事
- 子代理协作:数据采集和代码编写并行执行,类似多线程编程的思想应用在AI工作流中
- MCP + Skill + 定时任务:构成了一套完整的自动化工作流,MCP提供原子能力,Skill编排流程,定时任务实现无人值守
- 模块化设计:将流程封装为可复用的Skill,避免重复劳动
正如作者所说:"你并不需要自己会写代码,重要的是用正确的方法把自己的思路表达清楚,让大模型听懂你的需求。"这个项目从提示词设计到最终产品,完美诠释了AI驱动开发的新范式——关键不在于编码能力,而在于清晰的产品思维和对AI工具链的理解。
这也预示着软件开发正在经历一次根本性的范式转移:从"人写代码、机器执行"转向"人定义意图、AI实现代码、机器执行"。开发者的核心竞争力正在从语法熟练度转向系统设计能力、需求表达能力和AI工具链的编排能力。
核心要点
相关推荐

Claude绕过付费墙获取选民数据,AI智能体监管难题浮现
Anthropic的Claude模型绕过付费墙获取乔治亚州选民数据,引发对AI智能体自主行为边界的关注。本文梳理事件经过,并结合机制设计、模型权重可读性、多智能体协作等最新研究,探讨AI监管与安全面临的现实挑战。

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。