Colibri开源引擎:普通电脑也能跑2.8T大模型
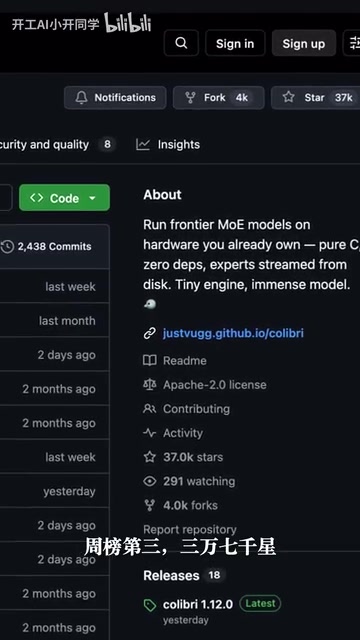
Colibri 用"硬盘当内存+按需加载专家"让消费级PC也能运行744B至2.8T级超大模型。
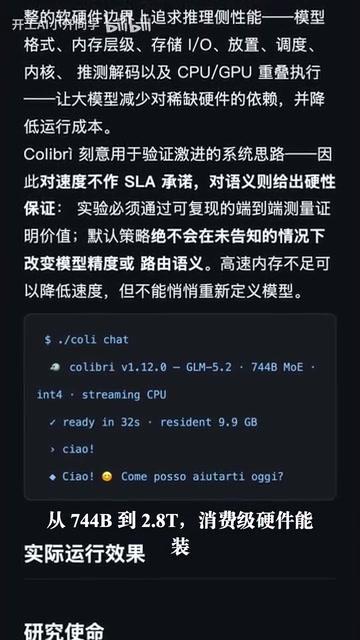
Colibri 是一款开源推理引擎,核心思路是将硬盘作为扩展内存,结合 MoE 模型稀疏激活的特性,仅在推理时按需从磁盘读取被激活的专家权重,从而大幅降低运行超大规模模型的硬件门槛。它支持从 744B 到 2.8T 参数的九大模型家族,包括 DeepSeek、Kimi、GLM 等主流开源模型。部署方面,官方提供三平台预编译版本,用户只需下载引擎和模型后执行三条命令即可开始对话。官方坦诚地定位为"速度不做承诺,语义有硬保证",以 Apache 2.0 协议开源,适合预算有限的研究者和发烧友低成本触达前沿大模型,但不适用于追求生产级低延迟的场景。
消费级硬件跑大模型的新思路
运行一个 2.8T 参数级别的大模型,过去几乎是数据中心的专属游戏——动辄需要成组的高端显卡,成本轻松突破八万元。而一个名为 Colibri 的开源推理引擎,正试图打破这道门槛。据 B 站相关技术 UP 主的介绍,这款引擎登上了开源周榜第三名,累计获得约 37000 星标,核心卖点只有一句话:让普通电脑也能装下并运行超大规模模型。
Colibri 的思路并不复杂,但相当务实。它不再强求把整个模型塞进显存或内存,而是把硬盘当作扩展内存来用,通过“专家按需读取”的方式,只在需要时把对应的模型分片从磁盘加载进来。对于采用 MoE(混合专家)架构的大模型来说,这种按需调度的策略尤其契合——毕竟每次推理真正被激活的专家只是全部参数中的一小部分。
覆盖范围:从744B到2.8T的九大模型家族
从参数规模看,Colibri 的适配跨度相当大,覆盖了从 744B 到 2.8T 的模型区间。这意味着它并非只为某一款模型定制,而是面向一整片主流大模型生态做兼容。
据视频介绍,它支持九大模型家族,包括 GLM、Kimi、DeepSeek广告(视频中提及的“DeepSync”应为 DeepSeek)等国内外热门开源模型。这种广覆盖对普通用户的价值在于:不必为每个模型折腾一套独立的运行环境,一个引擎就能在同一套硬件上切换体验不同家族的能力。
为什么“硬盘换显存”这条路走得通
本质上,这是用带宽换成本的取舍。显存和内存速度快但昂贵,硬盘(尤其是 NVMe SSD)容量大、成本低。对于激活参数稀疏的 MoE 模型,把不常用的专家权重放在硬盘上、用时再读,可以在牺牲部分速度的前提下,把硬件门槛压到消费级水平。这也解释了为什么官方对速度“不做承诺”——它换来的是能不能跑起来的问题,而不是跑多快的问题。
MoE(Mixture of Experts,混合专家)架构是理解 Colibri 适用逻辑的关键。传统稠密大模型的每一个 token 都会经过全部参数计算,而 MoE 模型在每个 transformer 层中设置多个"专家"子网络,由一个轻量级"路由器"决定每个 token 只送入其中少数几个专家(通常 2 个)。这使得模型总参数量可以做到很大(如 2.8T),但单次推理实际激活的参数量只有其中一小部分(如 DeepSeek-V3 激活参数约 37B),大幅降低了实时计算量。DeepSeek、Kimi 等近年来备受关注的主流开源大模型,均采用了 MoE 或其变体架构,这也是 Colibri 能够以"九大家族"为卖点的技术前提——正是这些模型的稀疏激活特性,使得按需从磁盘加载专家权重在工程上具备可行性。
上手体验:三条命令就能开聊
对普通用户而言,最友好的一点是部署流程被大幅简化。据介绍,Colibri 官方提供了三平台预编译版本,用户下载引擎、下载模型,再执行三条命令,就能进入对话状态,省去了复杂的从源码编译和依赖配置过程。
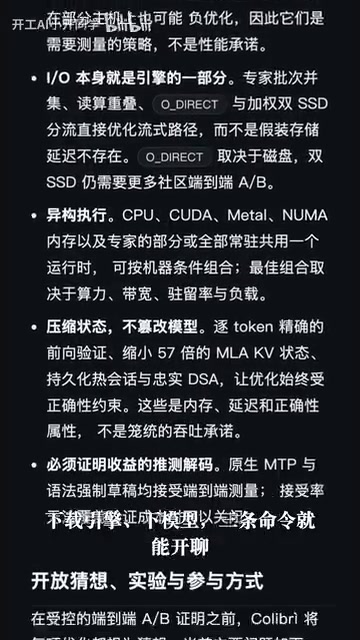
需要留意的是官方对能力边界的表述:速度不做承诺,但语义有硬保证。换句话说,工具优先确保输出的正确性与模型语义的一致性,而运行速度会受本地硬盘读写、模型规模等因素影响,属于合理预期内的妥协。这种坦诚的定位,比起夸大性能承诺要更值得信任。
开源协议与获取方式
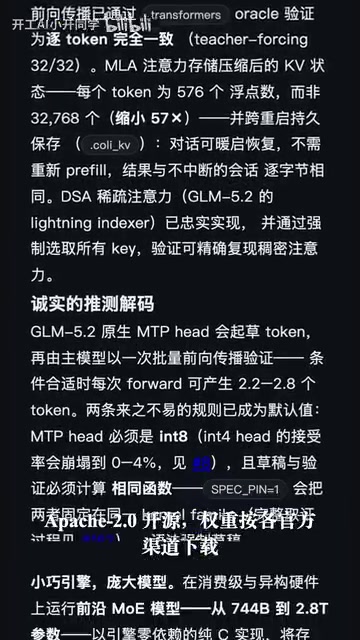
Colibri 采用 Apache 2.0 协议开源,这是一个对商用相当友好的宽松许可,开发者可以基于它做二次开发或集成。
视频特别提醒:模型权重需按各官方渠道下载,这是使用开源大模型时的合规要点,避免从来路不明的源获取权重。目前该工具的相关资源已被整理到“开工AI”等免费资源合集中,方便用户按需取用,并配有中文说明降低上手门槛。
一点冷静的看法
Colibri 的意义更多在于“可及性”而非“高性能”。它让本地跑超大模型从不可能变成可能,对研究者、发烧友以及预算有限的开发者是实打实的利好。但要清醒认识到:以硬盘为后端的推理,速度天花板受制于磁盘 I/O,长文本、高并发场景下的实际体验仍需自行验证。
对想尝鲜的人来说,它是一个低成本触达前沿大模型的好入口;对追求生产级低延迟的场景,专用硬件依然不可替代。工具本身的价值,恰恰在于把选择权重新交回到了用户手里。
背景补充
NVMe SSD 的顺序读取速度通常在 3000–7000 MB/s 区间(PCIe 4.0/5.0 协议),远低于 GPU 显存带宽(如 H100 的 3.35 TB/s),但相比机械硬盘已提升了数十倍。Colibri 这类引擎的工程重点之一,正是通过预取(prefetch)和异步 I/O 来尽量隐藏磁盘延迟——在 GPU/CPU 处理当前专家层时,提前将下一批可能被激活的专家权重从硬盘读入内存,形成流水线,减少等待时间。MoE 模型的稀疏激活特性(每次推理通常只激活 2–8 个专家,而非全部数十甚至上百个)与这种调度策略高度契合:激活路径越稀疏,单次推理需要从磁盘调入的数据量越少,速度损失相对可控。这也是为什么同样的"硬盘换显存"策略对稠密(Dense)模型效果要差很多——Dense 模型每层都要读取全部参数,I/O 压力会成倍放大。
相关推荐
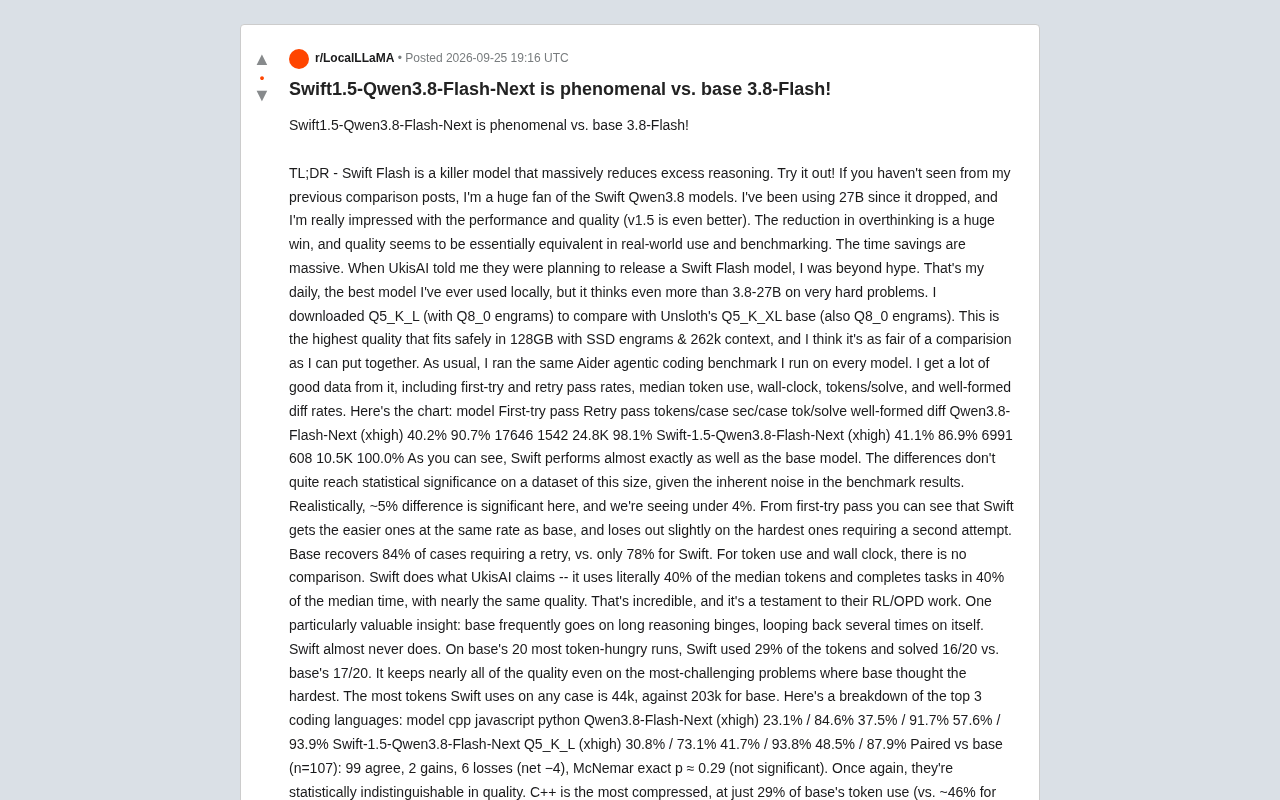
Swift1.5-Qwen3.8-Flash-Next实测:推理提速60%,质量几乎无损
Swift-1.5-Qwen3.8-Flash-Next实测对比基础版Qwen3.8-Flash:Aider编程基准显示其推理token和耗时降至40%,质量几乎无损,C++场景需留意。本地大模型效率优化实录。
中学生涌入NPR评论区:一场Z世代的网络迁徙
NPR工作人员一度把Spotify播客评论区的古怪留言当成机器人,直到一位Z世代同事识破真相——原来是中学生把这里当成了新的线上聚集地。本文解读青少年网络迁徙背后的代际认知差异与平台治理挑战。
《Factorio》登陆触屏平台:一场工厂建造游戏的交互重构
自动化工厂建造游戏《Factorio》正尝试移植到触屏平台。本文解析开发日志 FFF-447 中揭示的触屏交互重构挑战,以及复杂桌面软件迁移触摸范式的通用启示。