从点修到量化提升:ai_extract与MLflow优化文档抽取
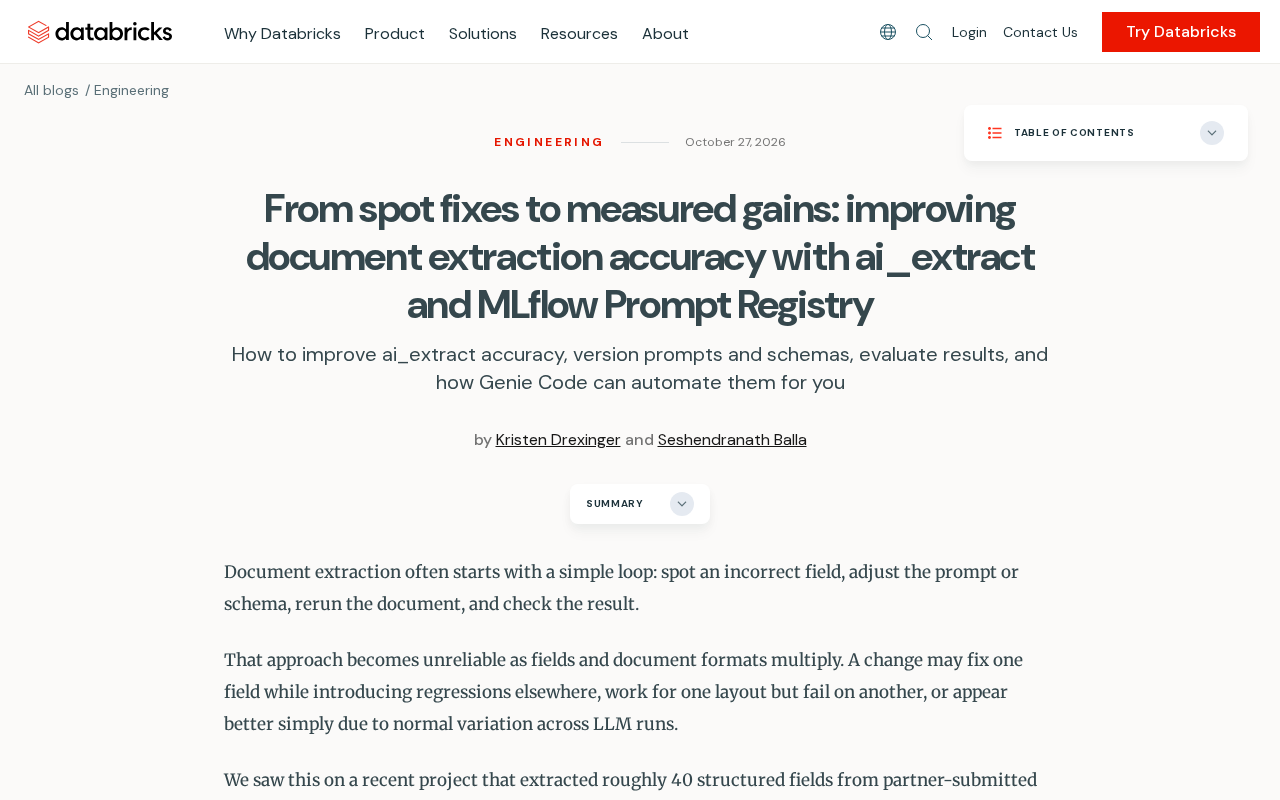
用ai_extract与MLflow Prompt Registry将文档抽取从点修转为可度量、可复现的工程闭环。
文章指出文档抽取优化常陷入“点修”陷阱:发现字段错误就调提示词,却无法回答准确率是否真正提升。点修模式存在缺乏基准、知识散落、回归风险不可见三个结构性缺陷,根源是缺少度量环节。为此,作者提出结合ai_extract与MLflow Prompt Registry的工程化路径:ai_extract通过声明式schema将抽取定义与执行解耦,使配置可版本化管理;Prompt Registry将提示词视为一等工程制品,记录版本、变更和评估结果,支持回滚与对比。在此基础上,团队应建立可度量的评估闭环,包括固化黄金标准评估集、定义字段级指标、每次变更跑全量评估、用版本对比替代主观判断。最终,优化从被动救火转变为主动实验,每次修复都成为可度量的实验,结论沉淀为可追溯的版本,形成持续积累的复利。
文档抽取是众多AI应用落地的第一道关卡,但它的优化过程往往充满挫败感:发现一个字段抽取错了,就去调整提示词或规则,然后祈祷下一个文档不会出现新的问题。这种“点修”(spot fixes)模式看似敏捷,实则让团队陷入无尽的救火循环,无法回答一个根本问题——我们的抽取准确率到底提升了多少?
本文结合ai_extract与MLflow Prompt Registry的实践思路,探讨如何将文档抽取的优化从零散的经验驱动,转变为可度量、可复现的工程化流程。
点修模式的三个结构性缺陷
点修之所以流行,是因为它反馈即时、心理成本低。但它的代价在项目规模化后才显现出来。
缺乏基准,无法归因。 修改提示词后,你凭感觉认为“好像更准了”,但无法排除是测试样本恰好变简单了。没有固定的评估集,每一次改动都是盲目的。
知识散落,难以复用。 修复某个发票字段的经验,可能只存在于某个工程师的聊天记录里。下一个类似项目从零开始,重复踩坑。
回归风险不可见。 修好A字段的提示词,可能悄悄破坏了B字段的抽取。没有自动化评估,这种退化要等到线上用户投诉才被发现。
这些缺陷的根源不是模型能力不足,而是工程流程缺少“度量”这一环。
黄金标准数据集(Gold Standard Dataset) 是指由人工标注、作为评估基准的文档集合。在文档抽取场景中,它需要覆盖真实业务中可能出现的版式多样性、字段变体和边界情况(如模糊扫描件、手写批注、多语言混排)。黄金标准的质量直接决定评估结论的可信度:如果标注本身存在歧义或错误,后续所有指标都会失真。因此,构建时应制定明确的标注规范,对争议样本进行双人复核,并记录标注者间一致性(如Cohen's Kappa)。数据集一旦固化,就应冻结版本,仅在发现覆盖盲区时按既定流程扩充,避免“为了提升指标而换测试集”的自欺行为。
ai_extract:把抽取逻辑从代码中解耦
ai_extract的核心价值在于将文档抽取的“定义”与“执行”分离。开发者通过声明式的schema描述需要抽取的字段及其类型,抽取逻辑本身不再硬编码在业务代码里。
这种解耦带来两个直接好处。其一,字段定义的变更不需要改动应用代码,降低了引入bug的概率。其二,抽取配置可以像代码一样被版本化管理,为后续的度量与对比奠定基础。
当抽取逻辑成为可独立管理的资产,下一步自然是把它纳入可追踪的实验体系——这正是MLflow Prompt Registry发挥作用的地方。
MLflow Prompt Registry:让每次提示词变更可追溯
Prompt Registry将提示词视为一等公民的工程制品,记录其版本、变更内容和关联的评估结果。在文档抽取场景中,这意味着:
- 每一次针对特定字段的提示词调整都会生成新版本,而非覆盖旧版本;
- 每个版本可以绑定对应的评估指标,准确率的波动有据可查;
- 团队可以回滚到任意历史版本,而不必依赖“上次那个能用的提示词”的口头记忆。
将ai_extract的schema定义与Prompt Registry的版本管理结合,抽取流程从“改代码—肉眼检查—上线”变成了“改配置—自动评估—对比指标—决定是否上线”的闭环。
提示词版本管理(Prompt Versioning) 与代码版本管理遵循相似原则,但针对的是自然语言指令这一特殊制品。一个提示词版本不仅包含文本本身,还应记录其模板变量、使用的模型标识、温度等推理参数,以及创建时间和作者。在MLflow Prompt Registry中,每次注册都会生成不可变的版本号,并支持别名(alias)机制——例如将经过评估验证的版本标记为production,实验中的版本标记为staging。这样,线上服务通过别名引用提示词,切换版本时无需改动代码。结合评估指标,团队可以像对比代码提交一样对比提示词版本的表现差异,从而将“哪个提示词更好”转化为可复现的实验结论。
建立可度量的评估闭环
从点修转向量化提升,关键在于构建一个稳定的评估流程。以下是可落地的步骤:
1. 固化评估数据集。 收集一批具有代表性的文档,覆盖常见版式与边界情况,人工标注正确结果作为黄金标准。这个数据集应当保持稳定,偶尔扩充但不随意替换。
2. 定义字段级指标。 整体准确率会掩盖局部问题,字段级准确率才能定位到具体薄弱环节。对关键字段设置更高的通过门槛。
3. 每次变更跑全量评估。 无论是调整提示词、更换模型还是修改schema,都先在评估集上跑一遍,记录指标后再决定是否合并。
4. 用版本对比替代主观判断。 Prompt Registry中的版本历史配合评估指标,让“这次改动是否有效”成为一个数据问题,而非会议上的争论。
字段级准确率(Field-level Accuracy) 是指针对schema中每个独立字段分别计算的抽取正确率,而非将所有字段合并统计的整体准确率。例如,一份发票可能包含发票号、金额、日期、税号等字段,整体准确率90%可能掩盖“税号字段仅60%正确”的严重问题。字段级指标通常需要区分精确匹配、模糊匹配(如日期格式差异)和语义等价(如金额单位换算),并根据业务重要性设置不同的通过阈值。关键字段(如金额、合同编号)应设置更严格的阈值,并可引入加权评分。字段级指标还能帮助定位错误模式:是某一类版式导致多个字段同时失败,还是特定字段的提示词描述不够清晰,从而指导更有针对性的优化。
从单点优化到系统化改进
当上述闭环运转起来,团队的行为模式会发生微妙变化。工程师不再问“这个字段怎么又错了”,而是问“上一个版本在这个字段上的准确率是多少,这次改动影响了哪些字段”。优化从被动响应变成了主动实验。
文档抽取的准确性提升没有银弹,但有一条清晰的路径:把每一次修复都变成一次可度量的实验,把每一次实验的结论都沉淀为可追溯的版本。ai_extract负责让抽取定义清晰可管理,MLflow Prompt Registry负责让变更历史透明可对比,两者结合,点修的泥潭才可能变成持续积累的复利。
相关推荐
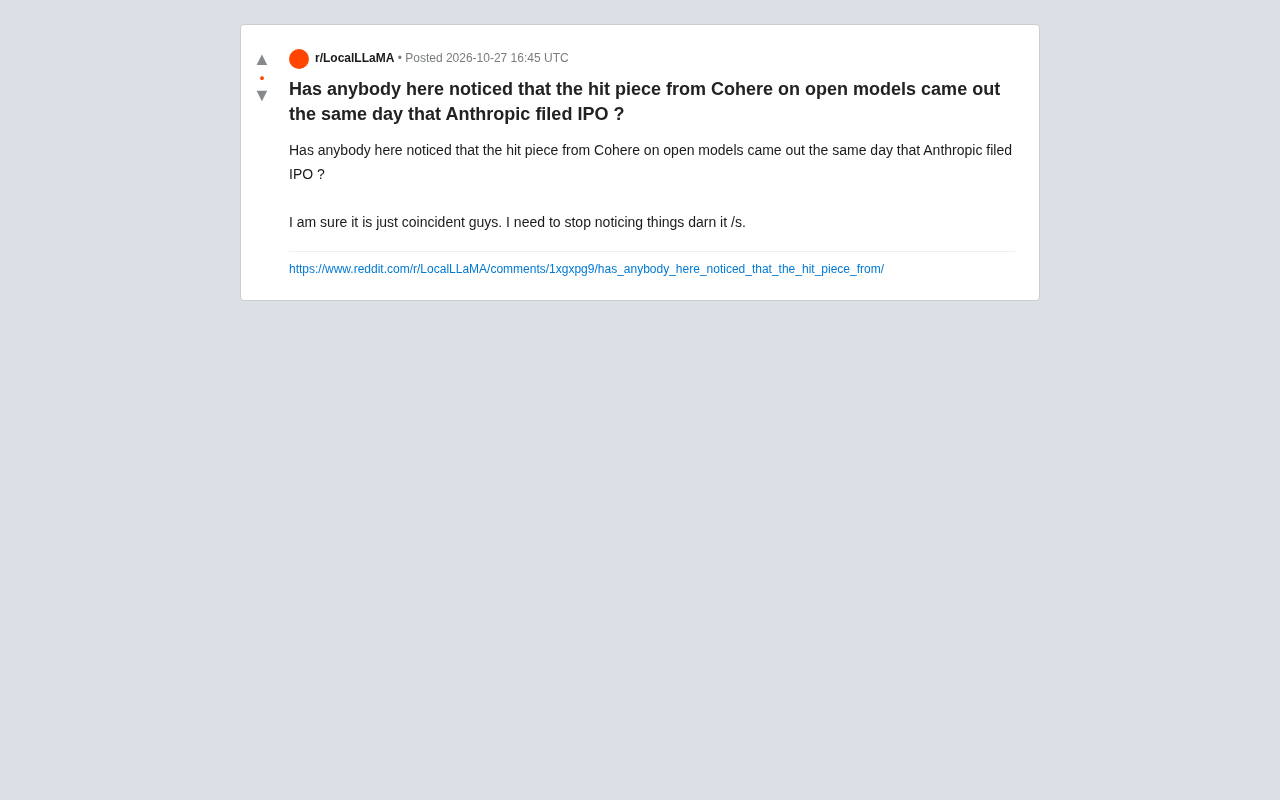
Cohere质疑开源模型与Anthropic IPO同日:巧合还是策略?
Reddit用户发现Cohere批评开源模型的文章与Anthropic提交IPO在同一天发布,引发社区对闭源厂商公共言论商业动机的讨论。本文分析这一时间巧合背后的开源与闭源之争,以及社区反应揭示的信任问题。
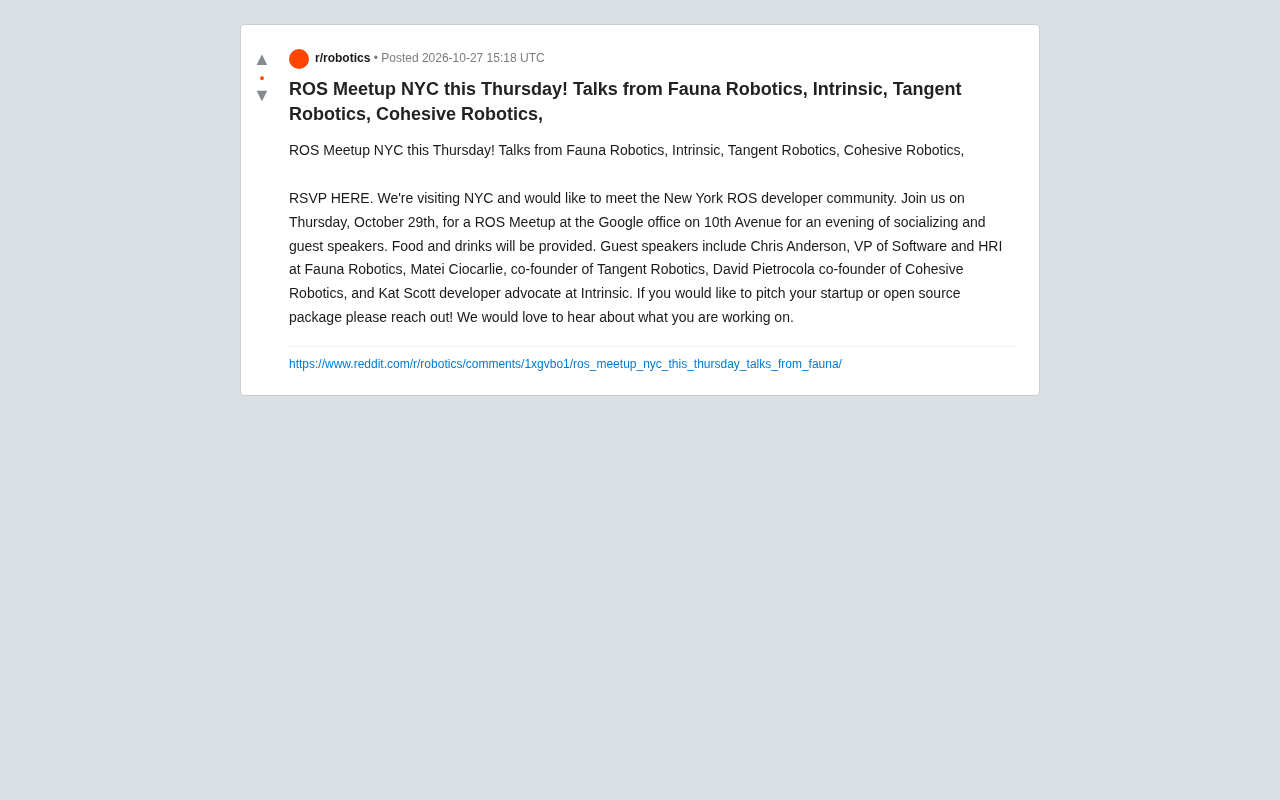
纽约ROS开发者聚会:四家机器人公司演讲
纽约ROS开发者聚会将于周四在谷歌办公室举行,Fauna Robotics、Intrinsic、Tangent Robotics、Cohesive Robotics等公司代表将发表演讲,活动免费并提供餐饮,开放报名与演讲征集。
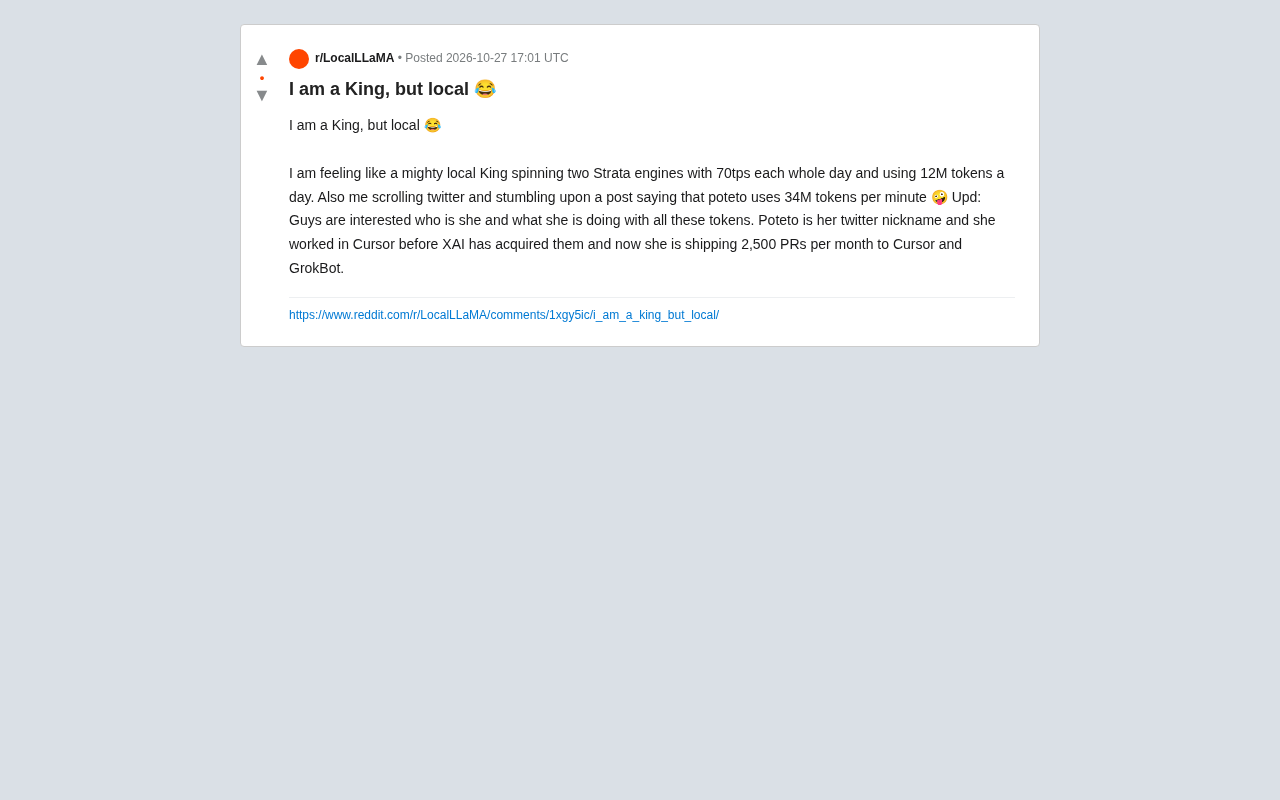
本地AI王者:日耗12M token背后的算力差距与竞争焦虑
Reddit开发者自嘲本地AI王者:日耗12M token,却被每分钟34M token的云端玩家降维打击。文章探讨本地部署与云端自动化的算力差距、token消耗量背后的行业焦虑,以及开发者如何在两种模式间找到平衡。