从零理解Agent:工具调用到工程底座的三次技术跃迁

从局限到跃迁:用"四类角色+三代演进"框架拆解企业级Agent的本质与选型逻辑
本文系统梳理了企业级智能体(Agent)的核心概念与技术演进路径。原生大模型存在无记忆、知识截止、无法调用外部工具三大先天缺陷,Agent作为中间层应运而生,承担翻译官、工具达人、记忆管家、任务管家四类角色。技术层面经历了三次跃迁:第一代Function Calling赋予模型"手脚",实现单步工具调用;第二代引入自主任务拆解与多步编排,代表架构为ReAct;第三代工程底座则聚焦于可控性与可扩展性的平衡。文章用"四辆车"比喻(封闭卡车、轿车、传统开源Agent、工程底座)直观区分了不同技术形态在企业场景下的适用边界,为初学者提供了清晰的选型参考框架。
从零理解Agent:工具调用到工程底座的三次技术跃迁
围绕企业级智能体开发,一个核心问题始终绕不开:为什么原生大模型不够用,我们到底需要什么样的 Agent?这篇文章基于一场面向零基础学员的直播分享内容,梳理出 Agent 的本质定义、要解决的四类核心问题,以及从工具调用到工程底座的三代技术演进逻辑。抛开营销话术,其中关于技术分层的比喻和分析确实值得初学者收藏理解。
为什么原生大模型不够用
原生大模型(无论 ChatGPT 还是 DeepSeek广告)都是大公司投入千万级成本训练出来的,但它们有几个几乎无法回避的先天缺陷。
第一是没有记忆。你和模型聊到第十几轮对话时,它往往已经忘了前面的上下文,每次交互都像重新开始。第二是知识截止,模型只学到了训练数据截止时间之前的知识,你问它之后发生的事,它会一本正经地胡说八道。第三是无法联网与调用外部工具,你问它明天的天气、最新的股票政策,它给不出真实答案,也读不到你本地电脑或企业数据库里的数据。
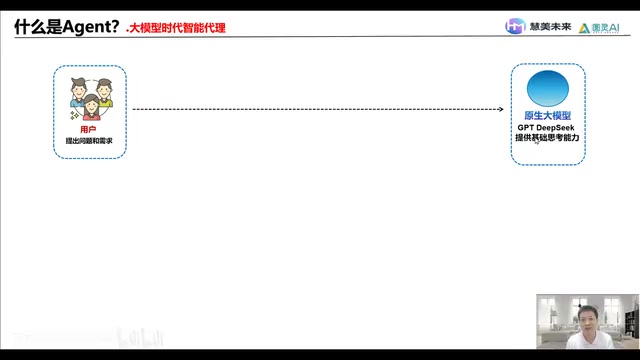
更现实的问题是,普通用户想直接调用原生大模型,要么写代码,要么调 API,门槛并不低。正是这些局限,催生了 Agent 这一层的存在。
Agent 到底是什么
分享中用了一个很直观的比喻:Agent 就像一个翻译官。中国人和美国人沟通需要翻译居中传话,用户和大模型之间也需要一个中间层——它理解用户的真实需求,调用各种工具去执行,再把结果整理后返回给用户。用一句话概括:Agent 就是大模型时代的代理。
从工程角度看,Agent 在整个大模型体系中承担了四类角色:
- 翻译官:把用户模糊的需求翻译成大模型能理解的指令,再把模型输出转换成用户能看懂的结果。
- 工具达人:帮模型调用 API、执行联网操作、查询数据,让模型从「会说话」变成「能干活」。
- 记忆管家:记住上下文、用户偏好和多轮对话历史,让交互具备连贯性,避免模型「失忆」。
- 任务管家:把一个复杂问题拆解成多个小步骤,规划执行流程,遇到问题主动尝试不同方案。
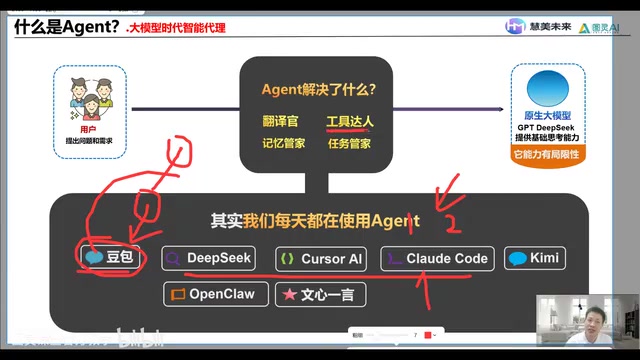
我们日常用的豆包、DeepSeek 客户端,其实都是 Agent。你发的问题并不是直接进大模型,而是先经过 Agent,由它调度模型反复加工,最后返回最准确的结果。写代码用的 Claude Code、Cursor 这类工具同样如此——它们能记住项目结构、调用工具、对代码调试并反复校验结果,本质上就是 Agent 的「工具达人」和「任务管家」能力在起作用。
Agent 的三次技术跃迁
分享把 Agent 的演进分成三代,逻辑是从「被动执行」逐步走向「自主规划」再到「工程化底座」。
第一代:工具调用时代(Function Calling)
这一代的专业术语是 Function Calling。可以把它理解成给大模型装上了「手和脚」——人有了手脚才能做事,模型有了工具调用能力才能真正干活。
举例来说,用户问「帮我查询今年的销售额」,原生模型答不上来,但通过 Function Calling,它可以调用对应工具:问天气就调天气接口,问销售就查企业内部数据库。这一代的特点像一个实习生——你催一下它动一下,不催就停在原地,非常死板,只能单步执行。
Function Calling 是 OpenAI 于 2023 年在 GPT-3.5/4 中率先推出的能力,随后成为业界标准接口范式。其核心机制是:开发者在调用大模型 API 时,预先声明一组可用函数(包括函数名、参数格式和功能描述),模型在生成回复时,如果判断需要调用某个函数,就会在输出中返回一个结构化的 JSON 调用指令,而非直接给出文字答案。开发者的代码捕获这一指令后,在本地或服务器上真正执行函数,再把结果以消息形式反馈给模型,由模型整合为最终回答。整个过程中,模型本身并不直接"运行"任何代码,它只是在决策"该调用什么"。这一机制将大模型从纯粹的文本生成器,变成了可以驱动外部系统的决策中枢,是后续所有 Agent 能力的基石。
第二代:自主拆解任务时代(编排流程)
第二代实现了从单步执行到多步规划的跨越,让模型能自主拆解任务、主动思考。
以「生成一份销售报告」为例:模型先做意图识别,然后分两路并行——一路提取企业内部销售数据,一路制定分析框架(因为每家公司的数据指标和维度都不同);再由模型介入生成汇总表和深层报表,最后交由人工审核确认,才把结果返回用户。
市面上主流的 Agent 架构(如 ReAct)以及扣子(Coze)等低代码工具,背后大多基于这一代的编排思路实现。但在真正做企业级项目时,第二代会暴露出大量问题,这才推动了第三代的出现。
ReAct(Reasoning + Acting)是第二代 Agent 最具代表性的架构范式,由普林斯顿大学与谷歌研究院于 2022 年联合提出。其核心思路是让模型交替执行"思考(Thought)→行动(Action)→观察(Observation)"三个步骤,形成循环直到任务完成。与纯粹的 Function Calling 相比,ReAct 要求模型在每次行动前先输出显式的推理链条,使得执行过程可解释、可调试。实践中,ReAct 还衍生出 Plan-and-Execute(先整体规划再逐步执行)等变体,以应对需要长程依赖的复杂任务。扣子(Coze)、Dify 等低代码平台的工作流引擎,本质上就是将这类多步推理逻辑固化为可视化节点,降低了开发门槛,但也因此牺牲了部分动态规划能力。
第三代:工程底座时代(DeepSeek Harness)
第三代被称为「工程底座」时代。分享用了一个「四辆车」的比喻来区分不同技术形态,这也是全文最有价值的部分。
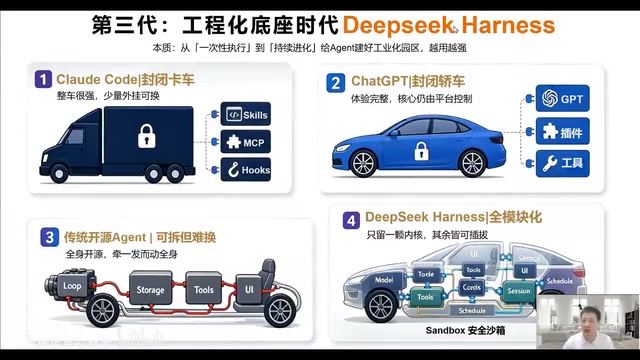
第一辆车——封闭式卡车:代表是闭源的 AI 编程工具(如某些商业 Code 工具)。它拉货能力强、开箱即用、注册就能用,也支持通过 Skill、MCP 接入外部工具跑得更快,但车厢和底盘无法改动。可控性和扩展性在企业场景下有明显局限,通常只适合特定用途(如 AI 编程),换个场景就受限。
第二辆车——轿车:代表是 ChatGPT 这类闭源付费产品。整车体验完整美观,但核心由平台控制。你可以通过官方插件改改「板金和油漆」,但整车架构和「发动机」是动不了的。
第三辆车——传统开源 Agent:GitHub 上大量博主开源的 Agent 项目。好处是可替换、可改造——懂技术的人可以接入自己的 UI、调整框架、改「发动机」。但弊端也很突出:牵一发而动全身,改一个 UI 界面可能要连带改动大量代码,迭代成本高、对技术能力要求苛刻。而且这些开源项目 98% 都只是 Demo,很难直接拿去支撑要赚钱的企业级项目。
工程底座(DeepSeek Harness)的定位,正是要在开箱即用与深度可控之间找到平衡,为企业级智能体开发提供一个更工程化、更可迭代的基础框架。
"Harness" 一词在工程领域原指线束或装具——即将多根线缆或工具有序捆扎、统一管理的框架结构。用在 Agent 开发语境中,DeepSeek Harness 的命名暗示其定位是"把模型能力、工具调用、记忆管理、任务编排等组件系统地束在一起的工程框架",而非单一功能模块。这与 LangChain、LlamaIndex 等西方主流框架的设计哲学有相似之处,但后者因抽象层过多、学习曲线陡峭,在中文企业级场景中落地时常遭遇适配成本过高的问题。工程底座的核心价值在于:提供标准化的模块边界,使 UI 层、模型层、工具层之间的替换不会引发连锁改动,从而真正支撑可持续迭代的商业项目,而不仅仅是演示用的 Demo。
写在最后
这套内容对零基础学员最大的价值,在于把抽象的 Agent 概念拆成了「四类角色 + 三代演进」的清晰框架。真正需要重点吸收的是思路而非代码:理解了原生模型的局限、Agent 的四大职能,以及不同技术形态在可控性和扩展性上的取舍,才能在实际项目中判断该选哪种方案。至于 DeepSeek Harness 相较传统 Agent 的具体工程优势,仍需结合真实项目源码进一步验证。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。