从纳维-斯托克斯之谜看:为何我依然看空大语言模型
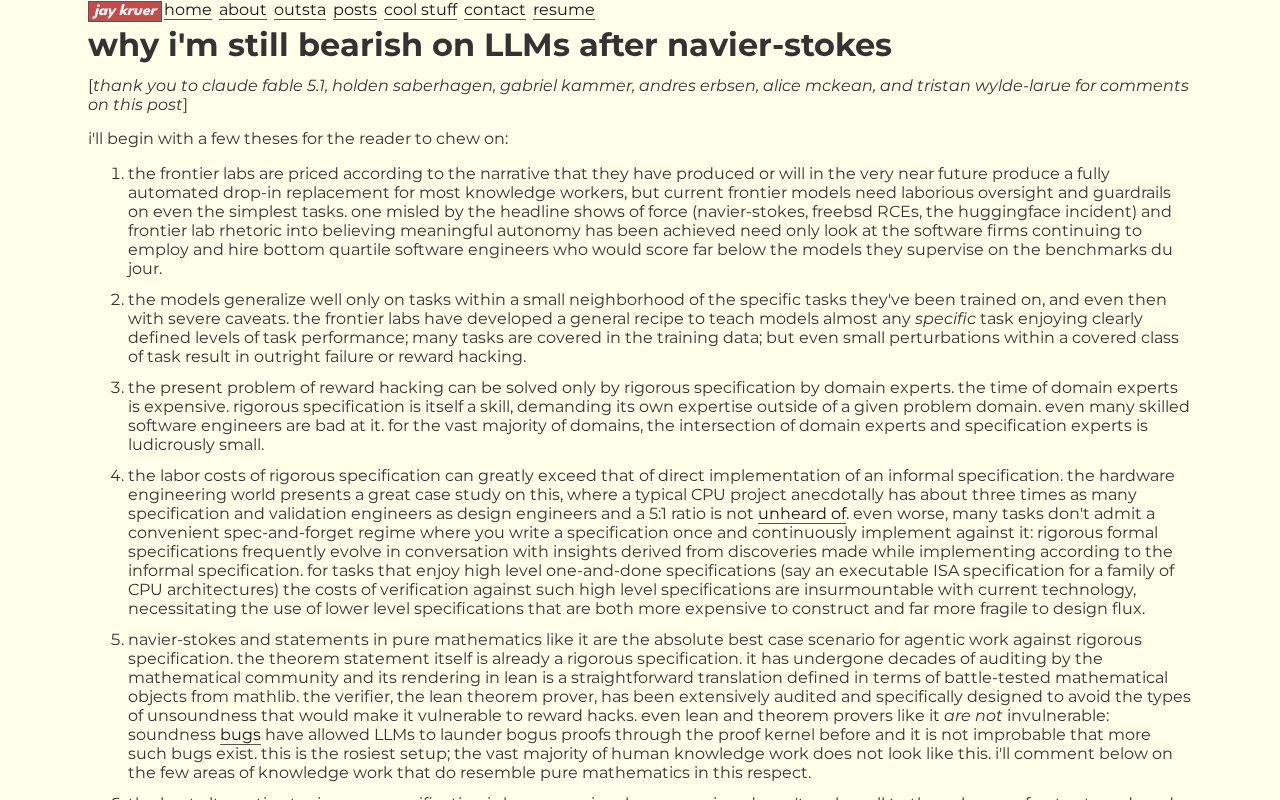
以纳维-斯托克斯难题为镜,审视LLM在严格数学推理上的真实能力边界与看空逻辑。
Hacker News上一篇帖子以纳维-斯托克斯方程——数学界七大千禧年难题之一——为切入点,探讨为何即便LLM在高难度数学问题上有局部进展,作者仍对其长期推理能力持谨慎态度。文章将看空论据拆解为三层:泛化能力受限于训练分布,难以真正外推至人类知识边界;前沿难题缺乏可验证的标准答案,任何"突破"都难以确认;单纯扩大规模的收益正在递减,跨越到真正抽象推理可能需要架构层面的根本革新。技术社区对此存在分歧,乐观派寄望于LLM与形式化验证系统结合,谨慎派则认为当前推理本质上仍是精巧模仿。文章的核心启示是:承认局部进步与对通用推理保持质疑可以并存,从业者应以人机协同替代盲信模型输出。
一个数学难题引发的AI能力之辩
近期在Hacker News上,一篇题为《Why I'm still bearish on LLMs after Navier-Stokes》的帖子引发讨论。文章的核心命题看似矛盾:即便在纳维-斯托克斯(Navier-Stokes)这类高难度数学问题上,大语言模型(LLM)展现出了某些进展,作者依然对其长期能力持谨慎乃至悲观的态度。
纳维-斯托克斯方程是流体力学的核心方程,其解的存在性与光滑性问题至今仍是数学界七大千禧年难题之一。当LLM被拿来与这类问题相提并论时,本质上是在追问一个更深层的命题:这些模型究竟是在"真正推理",还是在高维空间里进行复杂的模式匹配?
纳维-斯托克斯方程由19世纪数学家克劳德-路易·纳维与乔治·斯托克斯分别推导,用于描述粘性流体(如水、空气)的运动规律,是航空航天、气象预报、海洋模拟等领域的理论基础。千禧年难题中的具体挑战是:在三维空间中,从任意光滑初始条件出发,方程的解是否始终存在且保持光滑(即不会在有限时间内"爆炸"为无穷大)?克雷数学研究所为此悬赏百万美元,自2000年至今无人摘得。这一问题之所以极难,在于它涉及非线性偏微分方程的全局行为分析,数学工具至今不足以完全驾驭。将LLM与之放在同一语境,实质上是在追问:一个基于统计学习的系统,能否触及人类理性认知尚未企及的数学前沿?
为什么数学难题成了试金石
数学证明之所以成为衡量AI智能的关键标尺,在于它几乎不给"蒙对"留空间。一个证明要么在逻辑上闭合,要么存在漏洞,中间地带极小。这与自然语言生成有着本质区别——语言允许模糊、允许近似,而严格的数学推导要求每一步都可验证。
作者的"看空"立场,可能建立在这样一种观察之上:LLM在面对需要长链条、多步骤严密推理的问题时,容易在中间环节出现难以察觉的逻辑跳跃。即便最终答案看起来合理,推理过程却可能经不起逐行审查。这种"结果对、过程错"的现象,恰恰暴露了当前模型与真正的形式化推理之间的鸿沟。
"看空"背后的三种可能论据
结合帖子标题与技术社区的普遍讨论脉络,作者的悲观判断大致可以拆解为几个层面。
泛化能力的边界
LLM的强项在于对训练数据分布内问题的插值,而纳维-斯托克斯这类前沿数学问题恰恰处于人类知识的边缘地带,训练语料中几乎不存在现成答案。模型在此类问题上若有"表现",需要谨慎区分是真正的创造性推导,还是对已有文献片段的重组。
机器学习中的"插值"与"外推"之分对理解LLM局限至关重要。插值指模型在训练数据覆盖的分布范围内处理新输入,本质上是对已见模式的泛化;外推则要求模型在训练分布之外的区域作出有效判断,这对统计模型而言是根本性挑战。大量研究(如Chollet的ARC基准测试)表明,当前LLM在需要真正外推的任务上表现断崖式下滑。纳维-斯托克斯问题的特殊性在于,人类数学家解决此类问题依赖的是对数学结构的深层洞察与创造性构造,而非对已有解法的检索与拼接。区分LLM的输出究竟属于"高质量插值"还是"真实外推",是评估其在前沿数学任务上表现时不可绕过的核心问题。
可验证性的缺失
对于一个尚未被人类解决的难题,我们没有标准答案去核对模型输出。这意味着即便LLM给出了看似惊艳的结果,也难以判断其正确性。缺乏可靠的验证机制,任何"突破"都只是概率意义上的猜测。
规模化的收益递减
看空派的一个常见论点是:单纯堆叠参数量和数据量,边际收益正在递减。要跨越到真正的抽象推理,可能需要架构层面的根本性革新,而非现有范式的线性延伸。
技术社区的分歧
这篇帖子获得了39个点赞和8条评论,讨论热度虽不算爆炸,却触及了AI领域最核心的争论之一。乐观派认为,LLM结合工具调用、形式化验证系统(如证明助手)后,能够在数学领域取得实质突破;而谨慎派则强调,当前模型的"推理"更像是精巧的模仿,距离人类数学家的洞察力仍有质的差距。
值得关注的是,这场辩论并非非黑即白。承认LLM在特定数学任务上有进展,与对其通用推理能力保持怀疑,二者可以并存。作者标题中的"still bearish"(依然看空)正体现了这种立场——不否认局部进步,但对宏大叙事保持清醒。
形式化验证系统(如Lean、Coq、Isabelle)是这场争论中乐观派常援引的关键工具。这类"证明助手"要求用严格的形式语言逐步构建数学证明,每一步推导都由计算机内核机械验证,从根本上消除了人类审阅时可能遗漏的逻辑漏洞。近年来DeepMind的AlphaProof项目与多个学术团队尝试将LLM与Lean结合:由LLM生成证明步骤的候选,由形式化系统负责验证,二者形成互补。这一路径的潜力在于,它将LLM的"创造性猜测"与机械验证的严格性解耦,有望绕开"模型输出难以核验"的瓶颈。然而批评者指出,当问题本身连人类都无法给出参考证明时,LLM生成的形式化步骤仍缺乏引导,系统整体仍难以突破知识边界。
对从业者的启示
对于AI开发者和研究者而言,这类讨论提供了重要的现实校准。在产品宣传中,"AI能解决数学难题"往往被过度包装;而真正落地时,可验证性、可解释性、以及推理的鲁棒性才是关键考量。
将LLM应用于需要严格逻辑的场景时,人机协同、外部验证工具的引入,比盲目信任模型输出更为务实。数学难题作为压力测试,恰好帮助我们看清当前技术的能力边界所在。
结语
这篇简短却引人深思的帖子,用一个数学难题作为切入点,重新点燃了关于LLM本质的讨论。看空也好,看多也罢,其价值不在于给出定论,而在于提醒整个行业:在惊人的演示效果之外,我们仍需对模型的真实推理能力保持批判性审视。纳维-斯托克斯不会轻易被攻克,而对AI能力边界的探索,同样是一场没有终点的长跑。
相关推荐
Claude Code与Codex企业级实战:AI工程化编程如何搞定复杂项目
从氛围编程到AI工程化编程,本文解析Claude Code与Codex企业级项目实战:三种开发模式递进、国产大模型选型、SuperPower插件流程,以及Open Router聚合平台背后的AI行业盈利逻辑。
开源桌面端CC-HAHA上手:让AI自动操作你的电脑
开源桌面客户端 CC-HAHA 新增 computer use 电脑操控功能,让 AI 通过虚拟鼠标自动操作电脑。本文详解三步配置流程、实际效果演示,并分析不同模型在操作电脑能力上的差异与局限。
Claude Code桌面版实操:中文汉化+免登录+接入DeepSeek全攻略
手把手教你安装 Claude Code 桌面版,实现免账号使用、中文汉化,并通过 CC Switch 接入国产模型 DeepSeek,还包含自定义 Skill 导入的完整实操步骤,帮你低成本跑通 Claude Code 工作流。