#大语言模型
共 296 篇相关文章

人类 vs LLM模拟来访者:在线咨询训练对话模式对比
一项研究对比人类角色扮演者与Mixtral 8x7b模拟来访者在在线咨询训练中的对话模式,在句子层面分析LLM能否复现真实对话动态,以及咨询师面对人与AI时沟通行为的差异,探讨LLM角色扮演训练的潜力与局限。

H²R:用分层提示奖励提升数学推理
论文提出 H²R 框架,利用数学题固有的子问题结构作为分层提示奖励,为 RLVR 训练提供中间监督,并发布 HiMath 分层数学基准。实验显示分层提示可一致提升多种大模型的数学推理表现,集成到 RL 训练后增益进一步放大。

大模型如何破解医学试题难度密码?
一项研究利用USMLE和PANCE真题的经验难度标签,引导大语言模型归纳医学试题难度规则。研究发现难度并非来自题干长度等表面特征,而线索汇聚、误导性线索和选项竞争才是关键模式;规则引导能改善粗粒度判断,却未稳定提升排序准确性。

用有监督LLM在语言空间融合异构超声心动图AI输出
一项研究提出用有监督大语言模型在语言空间做晚期融合,直接聚合超声心动图多视图AI模型的预测发现与测量值,省去模型特定的输出转换与医学特征工程,并在646名患者的859次检查交叉验证中表现与最佳参考策略相当。
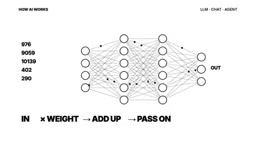
ChatGPT与AI Agent工作原理:无数学拆解核心机制
用无数学的方式拆解ChatGPT与AI Agent的工作原理:从token化、神经网络权重、注意力机制到逐词生成,再到Agent的工具循环。附职场使用AI的三条实用原则,帮你理解模型为何会出错、长对话为何失效、Agent为何需要严格授权。

从DQI到C-DQI:LLM自动生成编码手册评估议会话语质量
研究提出从DQI到C-DQI的完整协议,利用大语言模型自动生成并评估议会话语质量编码手册,对比理论驱动与数据驱动方案,实验显示数据驱动编码在模型间一致性上更优。

FisherEdit:用Fisher信息几何实现LLM知识编辑新突破
FisherEdit提出基于Fisher信息几何的知识编辑方法,用参数空间重要性正则化替代零空间投影,在Llama-3、Qwen2.5等模型上实现SOTA编辑性能并保持模型稳定性。

LLM如何预测下一个Token?拆解大模型生成机制
大语言模型如何预测下一个token?本文拆解LLM的token定义、下一token概率预测流程、Transformer训练来源、temperature采样策略,并用Python词频示例说明生成机制的本质与边界。

如何让System 1大模型展现System 2能力?
探讨如何让System 1大语言模型展现System 2推理能力,分析思维链、推理时计算、自洽性采样等主流路径,并讨论能力能否被诱导这一核心分歧。
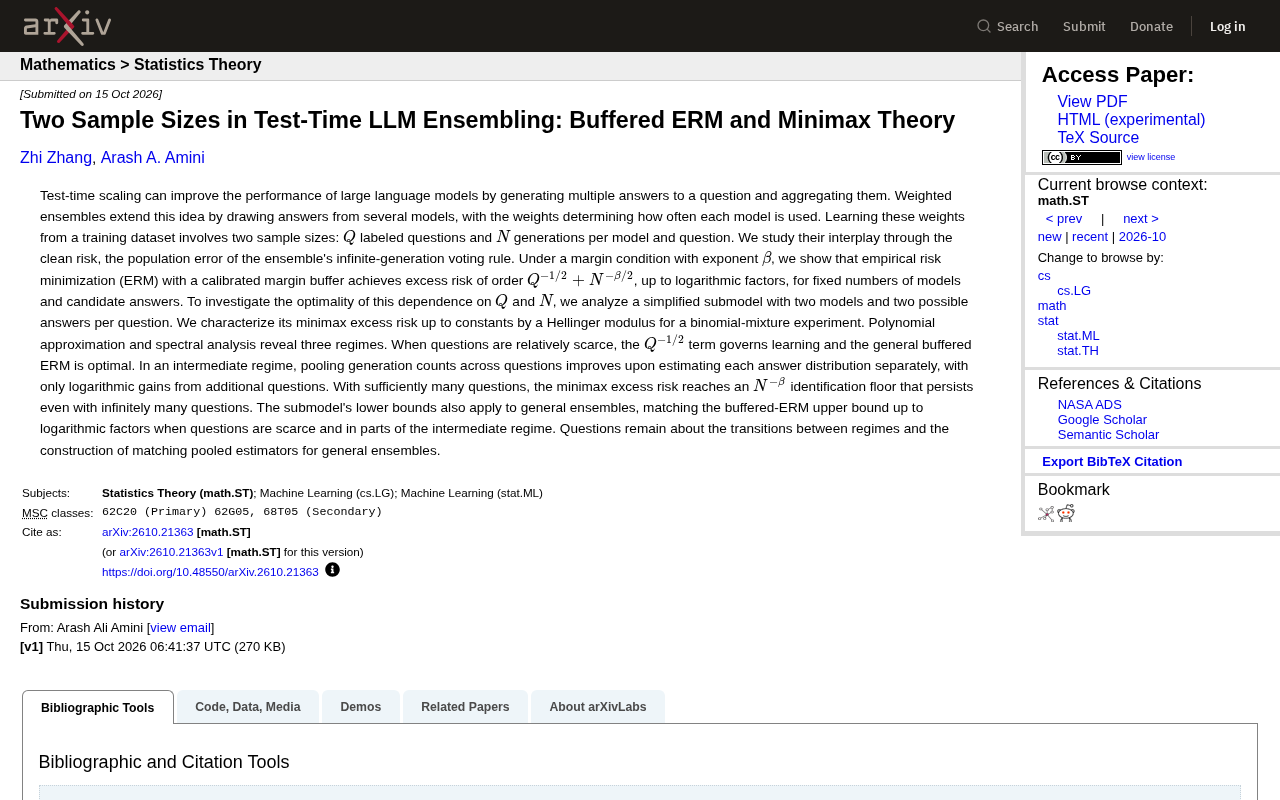
LLM测试时集成:双样本量与加权集成理论新解
研究揭示LLM测试时加权集成中标注问题数Q与生成次数N的双样本量权衡,证明缓冲ERM达到Q^{-1/2}+N^{-β/2}超额风险,并发现三类学习机制与N^{-β}识别极限,为集成权重学习提供理论保证。
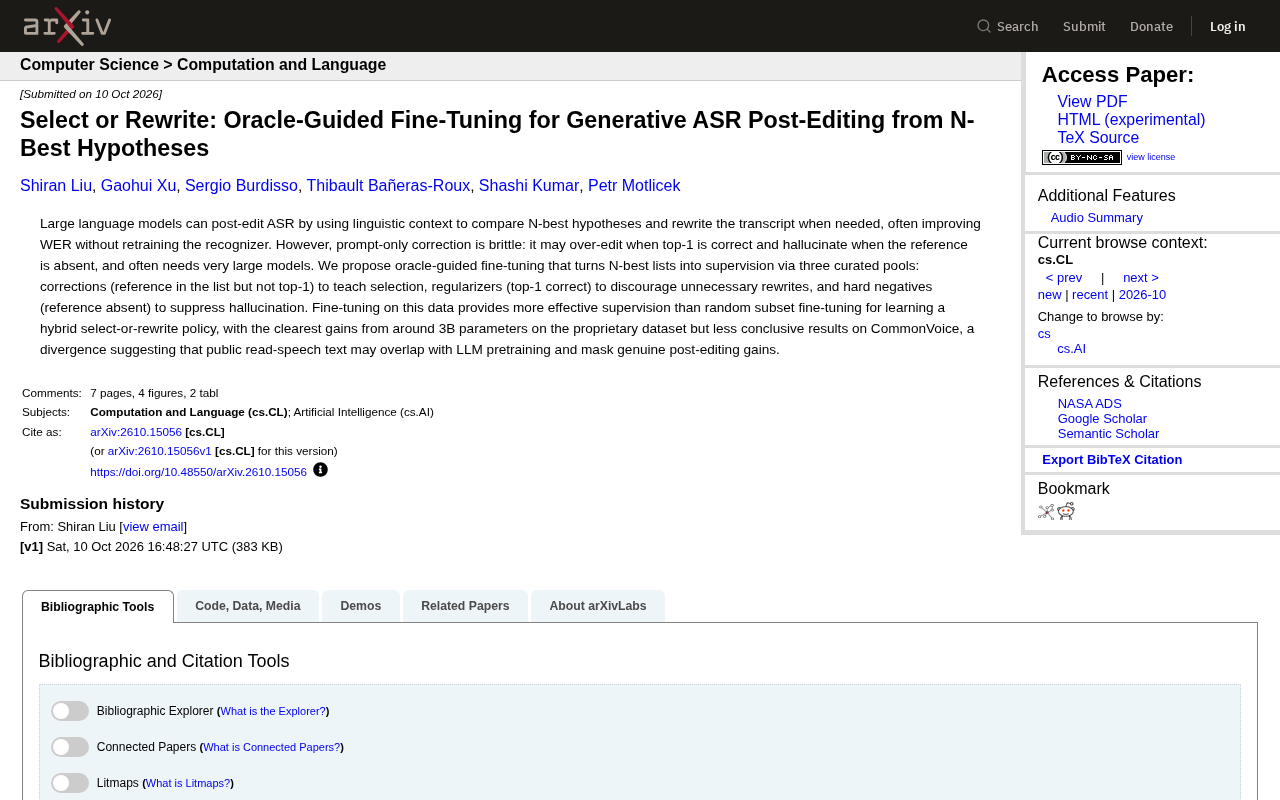
Oracle引导微调:让生成式ASR后编辑学会选择与重写
研究提出Oracle引导微调方法,通过修正池、正则化池和难负样本池将N-best列表转化为监督信号,训练生成式ASR后编辑模型学习选择或重写策略,减少过度编辑与幻觉,并揭示公共数据集预训练重叠问题。

别急着生成:让你的模型先学会"读空气"
LLM温度选择长期依赖固定值或启发式校准,缺少可解释的场景表示。新研究提出Scenario-Actor框架,从Transformer隐藏状态提取场景嵌入来动态决定采样温度,在Llama-3.1-8B-Instruct的社交互动、开放指令跟随与多轮对话任务上取得提升。

下一token预测+强化学习能通向通用智能吗?
下一token预测加强化学习能否产生通用人工智能?本文梳理Reddit讨论与计算学习理论,解析NTP+RL通向AGI的最强机制论证及其在目标生成、具身交互、持续学习三方面的缺口。

美国核电全面拥抱AI:94座反应堆如何用大模型管文档
美国94座核反应堆几乎全部引入AI,Atomic Canyon的NIVA与Nuclearn等方案从文档检索切入。本文解析核电AI落地的双重动因、数据孤岛难题,以及为何人类仍牢牢掌控运营决策权。

本地部署大模型选型指南:别再盯着参数和排行榜
如何为自己的硬件选择本地大语言模型?本文提供一套六步法:从任务需求出发、合理预算内存、权衡量化、理解可用上下文、核查许可证与安全性,并通过可复现测试做最终决策,告别盲目看参数和排行榜。

模型级RSI:当AI开始改进自身权重意味着什么
模型级RSI(递归自我改进)指的是模型在没有人类标注的情况下改进自身权重。本文梳理自我改进的五个阶段、避免自欺的三条规则,以及如何正确解读公开排行榜成绩,区分真实进步与数据泄漏。
4GB显卡从零训练语言模型:失败比成功更有价值
一位开发者用4GB显存的GTX 1650从零训练了2200万参数的语言模型,经历CUDA崩溃、生成死循环与斐波那契失败。本文解析在极限硬件约束下训练LLM的完整工作流、评估方法与教训。

LLM招聘筛选大测评:谁在左右你的简历命运?
FairScreen用10个大语言模型测试AI招聘筛选,发现模型配置、事实提取与输出处理远比模型名气更能左右决策。关闭思考的Qwen3得分39%,开启后飙升至98%,代码重放平均提升20.5个百分点。

