PhysMent:用交互式物理仿真评测大模型的物理推理能力

PhysMent基准测试揭示大模型物理推理的真正瓶颈:不是缺知识,而是不会做实验。
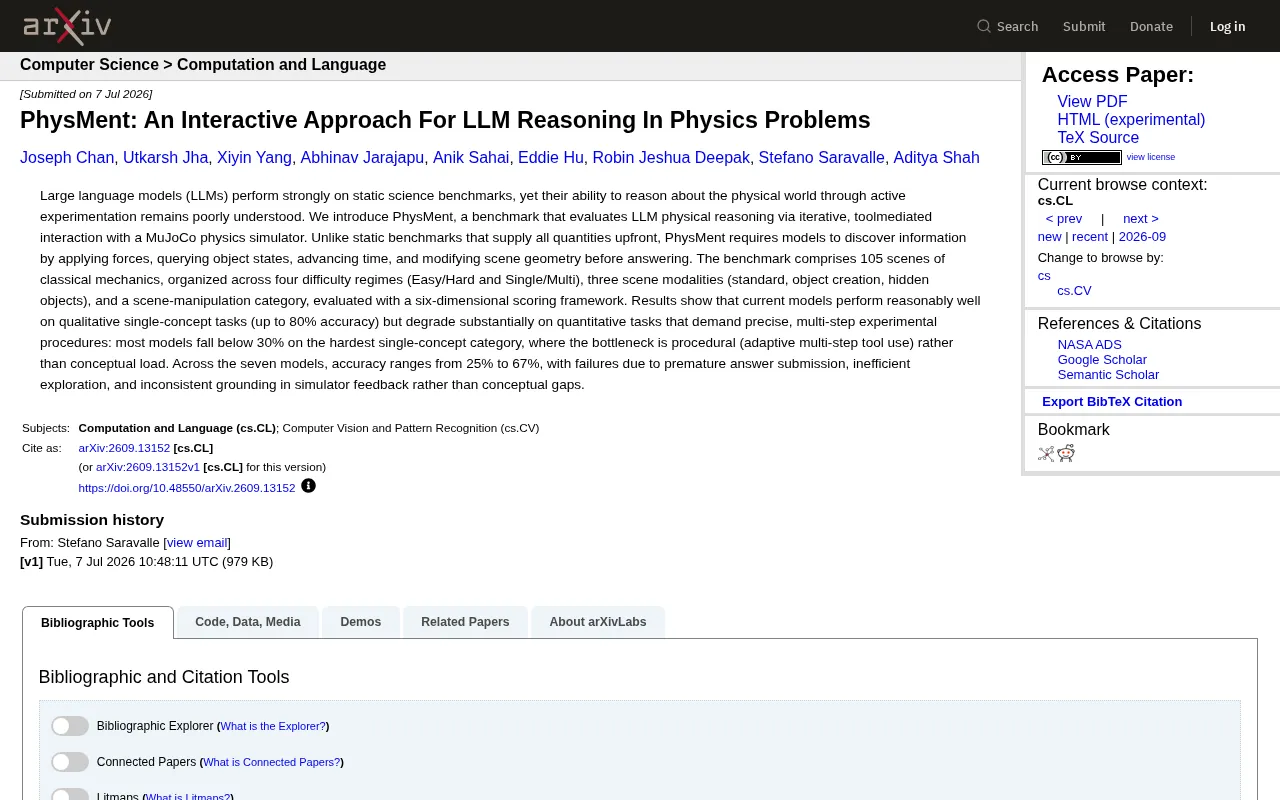
PhysMent 是一个基于 MuJoCo 物理仿真器的交互式基准测试,要求大语言模型通过主动施力、观测、推进时间等工具调用来"做实验",而非从预设题目中直接作答。测试覆盖 105 个经典力学场景,采用六维评分框架。结果显示,模型在定性单概念任务中表现尚可(最高 80%),但遇到需要精确数值和多步实验的定量任务时,大多数模型准确率跌破 30%,七个参测模型整体跨度为 25%-67%。研究的核心发现是:失败的根源并非物理概念缺失,而是流程性能力不足——模型会过早提交答案、低效使用工具、以及无法稳定地将实验反馈纳入后续推理。这将 LLM 物理推理的短板从"知识层面"重新定位到"行为层面",为具身智能和科学发现类 agent 的开发指明了优化方向。
大语言模型在静态科学测试中屡屡拿到高分,但当问题从"读题作答"变成"动手实验"时,它们真的懂物理吗?一项名为 PhysMent 的新基准测试,把 LLM 扔进了一个需要主动施力、观测、推进时间的物理仿真环境,结果揭示了模型在物理推理上的真实短板。
从静态答题到主动实验
现有的科学类基准测试有一个共同特点:题目会把所有已知量一次性摆在模型面前,模型只需完成一次性的符号推理即可给出答案。这种设定回避了物理世界最核心的一环——信息需要通过实验去获取。
PhysMent 的设计思路正好相反。它基于 MuJoCo 物理仿真器构建,模型无法直接获得所有物理量,而是要通过一系列工具调用来"发现"信息:施加外力、查询物体状态、推进仿真时间、修改场景几何结构。换句话说,模型必须像真正的实验者一样,先设计实验、观察反馈、再迭代推进,最后才能作答。
这种交互式、工具中介(tool-mediated)的评测框架,触及了当前 LLM 能力评估的一个盲区:它们的物理直觉究竟是建立在真实的因果理解之上,还是只是在静态题库里记住了套路。
105 个场景与六维评分
PhysMent 覆盖了经典力学领域的 105 个场景,测试维度设计得相当细致:
- 难度分层:分为 Easy/Hard 和 Single/Multi 两个正交维度,既考察单一概念,也考察多概念组合。
- 三种场景模态:标准场景(standard)、物体创建(object creation)、隐藏物体(hidden objects)。隐藏物体这一类尤其考验模型主动探索的能力——它必须通过实验手段去揭示看不见的信息。
- 场景操控类别:单独设置了修改场景本身的任务,检验模型对物理环境的干预能力。
评测采用六维评分框架,而非简单的对错判定。这意味着一个模型即便答错,其探索过程、工具使用效率、对反馈的响应等表现也会被拆分评估,从而定位失败的真正来源。
定性能行,定量就崩
实验结果呈现出一条清晰的分界线。在定性、单概念的任务上,当前模型表现尚可,准确率最高可达 80%。这说明模型对基础物理概念的"感觉"是有的。
但一旦进入需要精确数值、多步实验流程的定量任务,性能急剧下滑。在最难的单概念类别中,大多数模型准确率跌破 30%。研究者特别指出,这里的瓶颈不是概念负荷(conceptual load),而是流程性的——即自适应的多步骤工具使用能力。模型知道物理原理,却不知道该如何有条不紊地设计和执行一连串实验去逼近答案。
横向来看,参与测试的七个模型准确率跨度从 25% 到 67%,差距明显。
失败的根源:不是不懂,而是不会做实验
PhysMent 最有价值的发现,在于对失败模式的归因。研究团队指出,模型的错误主要来自三类行为,而非概念上的缺陷:
- 过早提交答案(premature answer submission):还没充分实验就急于给结论。
- 低效探索(inefficient exploration):工具调用缺乏策略,做了很多无用功。
- 对仿真反馈的接地不一致(inconsistent grounding):拿到了实验反馈,却没能稳定地把它纳入后续推理。
这一结论颇具启发性。它把大模型物理推理的短板从"知识层面"重新框定到了"行为层面"——问题不在于模型缺乏物理知识,而在于它们缺乏一个可靠的、迭代式的实验决策能力。这与当前对 agent(智能体)能力研究的关注点高度吻合:真正的挑战往往在于长程规划、工具编排和对环境反馈的持续对齐,而不是单点的知识调用。
对 AI 研究的意义
PhysMent 的价值不止于给出一个新的排行榜,它提供了一种诊断工具。当我们讨论 LLM 是否具备"世界模型"或"物理直觉"时,静态基准很难给出有说服力的答案,因为模型可能只是在复述训练语料里的物理知识。而在需要主动实验的封闭环境中,模型的推理链条会被完整暴露出来。
对于开发具身智能、机器人控制或科学发现类 agent 的团队来说,这项研究提示了一个明确的优化方向:与其继续堆叠物理知识,不如着重提升模型的实验流程能力——何时探索、如何高效探索、以及如何把每一步反馈稳定地纳入决策。这或许才是让大模型从"会答题"走向"会做科学"的关键一步。
相关推荐

SimpliSafe新款可视门铃:AI+真人保安主动盯防你的家门
SimpliSafe推出售价199.99美元的Video Doorbell Series 2可视门铃,搭配Active Guard主动安防服务,结合AI分析与真人监控坐席,实现家门口的主动威胁侦测与干预。本文解析其技术分工、订阅模式与隐私问题。
富士 Instax Pal 2 迷你相机:补齐屏幕短板的升级之作
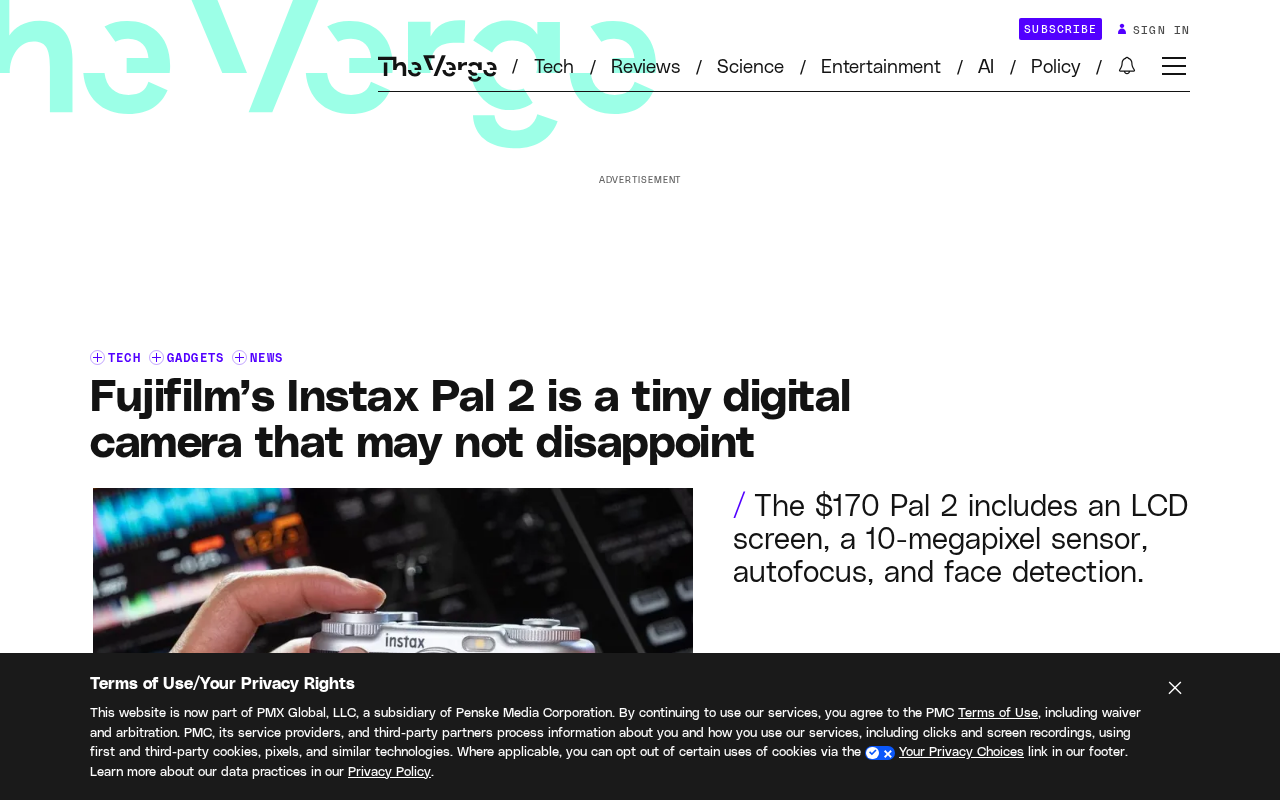
富士发布 Instax Pal 2 迷你数码相机,相比初代新增屏幕与取景器,采用微缩化相机造型,补齐了初代盲拍的核心短板,成为一款更实用的便携即时成像设备。
Linux from Scratch:从零手工构建你的Linux系统
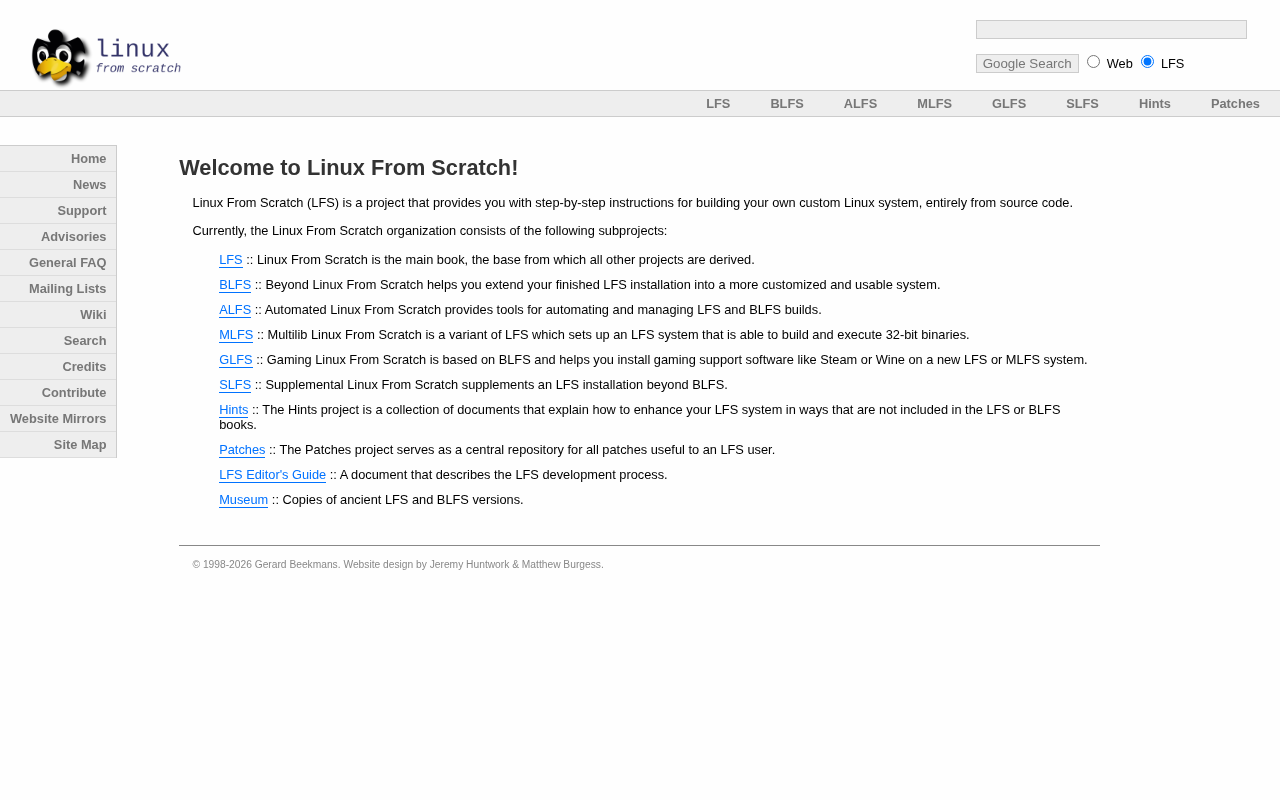
Linux from Scratch(LFS)是一个教你从源代码手工构建 Linux 系统的开源项目。本文介绍 LFS 的核心价值、BLFS/ALFS 项目生态及适用人群,帮助你理解 Linux 底层机制。