弱监督+LLM标注精炼:从人道主义文档中提取数据集引用

弱监督框架结合LLM审校,低成本实现人道主义领域数据集引用自动提取
这篇 arXiv 论文针对强迫流离失所与脆弱冲突暴力领域文档中数据集引用难以追踪的问题,提出了一套无需大规模人工标注的弱监督提取框架。方法核心是"大模型造数据、小模型跑推理"的分工:先以轻量模型广撒网生成候选提及,再由前沿 LLM 结合上下文进行审校与修正,辅以合成样本和对比样本扩充训练集,最终微调轻量模型用于大规模实际部署。在包含 1706 个段落的黄金基准测试中,段落级别准确率达 88.2%,含引用段落精确率达 89.5%,表明该框架在粗粒度判断上已具备实用价值。这一路径为标注资源匮乏的专业领域提供了可复制的低成本监督信号构造方案,并为人道主义数据治理中的引用追踪与数据缺口分析奠定技术基础。
开发与人道主义组织每年产出大量调查、行政登记和其他数据资源,用以支撑研究、政策制定与实际运营。但一个长期存在的难题是:这些数据集究竟被哪些文献引用了?相关引用散落在研究论文、项目文档、人道主义报告等大量非结构化文本中,既难以追踪数据的实际使用情况,也难以发现数据可得性或传播上的缺口。
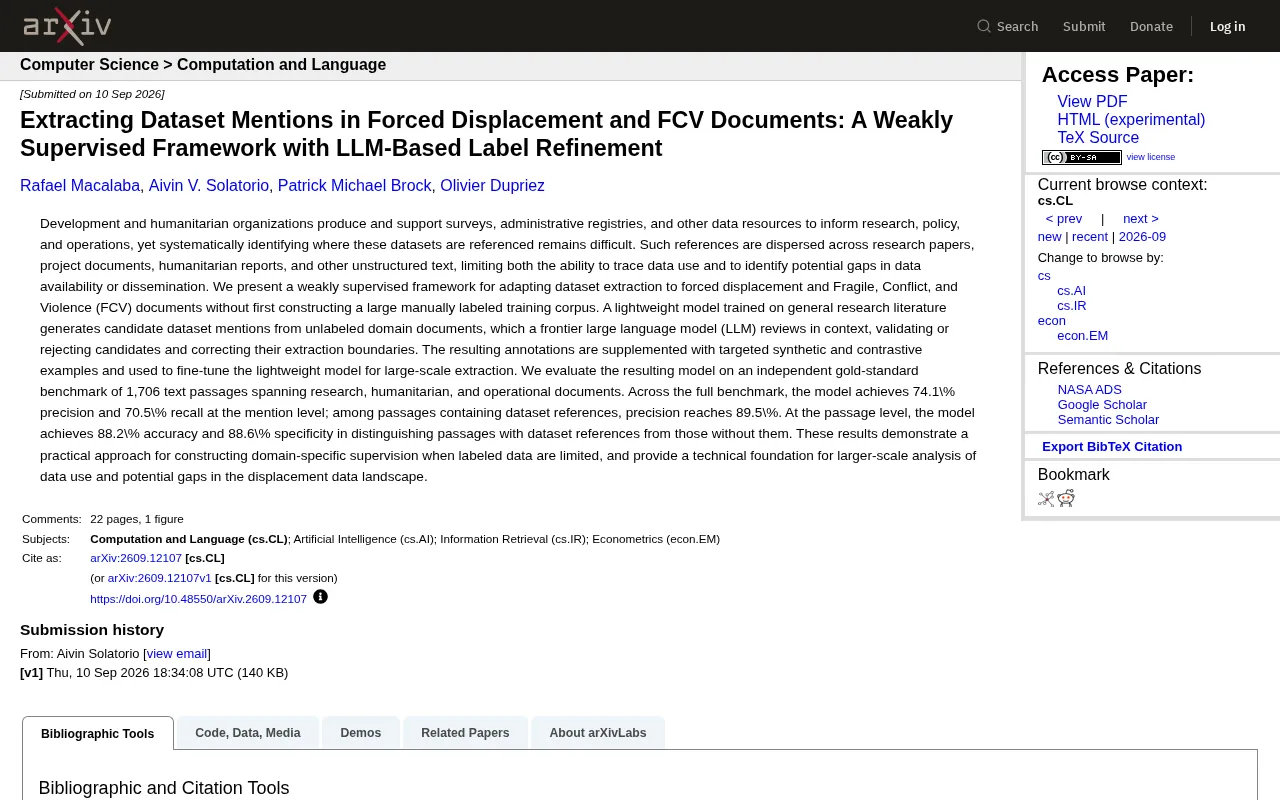
一篇新发布的 arXiv 论文(arXiv:2609.12107)针对强迫流离失所(Forced Displacement)与脆弱、冲突和暴力(FCV, Fragile, Conflict, and Violence)领域的文档,提出了一套弱监督框架,尝试在无需构建大规模人工标注语料的前提下,实现数据集引用的自动提取。
核心问题:标注数据稀缺下的领域适配
数据集提取(dataset extraction)本质上是一个信息抽取任务——从文本中识别出对某个具体数据集的提及。通用研究文献上已有相对成熟的方法,但一旦迁移到人道主义与冲突这类专业领域,标注数据的匮乏就成了主要瓶颈。人工构建一个足够大的领域训练集成本高昂,且需要领域专家参与。
研究团队的思路是绕开这一步:不预先做大规模人工标注,而是用一种"弱监督 + LLM 精炼"的方式,自动构造出可用的训练信号。这在标注资源受限的实际场景中,具有很强的现实意义。
方法拆解:轻量模型出候选,前沿LLM做裁判
整个流程可以理解为几个环节的协同:
轻量模型生成候选
先用一个在通用研究文献上训练的轻量模型,对未标注的领域文档进行处理,生成候选的数据集提及。这一步的作用是"广撒网",快速从大量文本中筛出可能的引用位置,但准确性有限。
前沿LLM在上下文中审校
候选结果交由一个前沿大语言模型(LLM)结合上下文进行复核:验证或拒绝候选项,并修正提取边界。相比轻量模型,LLM 的语义理解能力使它能够判断某段文字是否真的在引用一个数据集,以及准确圈定提及的范围。这一步是提升标注质量的关键。
合成与对比样本补充
在 LLM 审校得到的标注基础上,研究团队还补充了有针对性的合成样本(synthetic examples)与对比样本(contrastive examples)。对比样本有助于模型学会区分"看起来像但其实不是"数据集引用的情况,从而降低误报。
微调轻量模型用于大规模提取
最终,这些经过精炼的标注被用来微调那个轻量模型。这样做的好处在于:真正部署时使用的是低成本的轻量模型,可以支撑大规模提取,而昂贵的 LLM 只在训练数据构造阶段介入一次。这种"用大模型造数据、用小模型跑推理"的分工,是当前弱监督实践中一种务实的成本控制策略。
评测结果:黄金基准上的表现
研究在一个独立的黄金标准基准上评估模型,该基准包含 1706 个文本段落,覆盖研究、人道主义与运营三类文档。主要结果包括:
- 提及级别(mention level):整体精确率 74.1%,召回率 70.5%;
- 在确实包含数据集引用的段落中,精确率提升到 89.5%;
- 段落级别(passage level):区分"含引用"与"不含引用"段落的准确率达 88.2%,特异度(specificity)达 88.6%。
这些数字表明,模型在判断"某段文字是否涉及数据集引用"这一较粗粒度任务上表现相当稳健,而在细粒度的具体提及提取上仍有提升空间。提及级别与段落级别之间的差距,也反映出精确定位提及边界比判断段落主题更具挑战性。
意义与局限
这项工作的价值不只在于一个具体模型,更在于它示范了一条可复制的路径:当领域标注数据有限时,如何低成本地构造领域特定监督信号。 对于人道主义数据治理而言,能够系统追踪数据集的引用,意味着可以更好地了解数据被如何使用、在哪些环节存在传播断层,从而为后续的数据缺口分析打下技术基础。
从局限来看,提及级别 70% 上下的精确率与召回率意味着在真实大规模应用中仍会产生相当比例的漏检与误检,人工复核环节短期内难以完全省去。此外,该框架高度依赖前沿 LLM 的审校质量,LLM 本身的偏差可能被传递进最终的训练数据中。
对关注信息抽取、弱监督学习以及 AI 在社会公益领域应用的读者来说,这篇论文提供了一个兼具方法论价值与落地场景的参考案例。
相关推荐

Claude Code实战指南:从零搭建专属AI编程助理
基于实战教程梳理Claude Code从环境搭建、国产模型切换到Git工作流与命令体系的完整路径,帮助开发者快速搭建专属AI编程助理,少走弯路。

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。