#大语言模型
共 302 篇相关文章

用大语言模型突破ISM解释结构建模的扩展瓶颈
arXiv最新研究探索用大语言模型(LLM)突破解释结构建模(ISM)的扩展瓶颈,对比逐对、k元、逐行与全图四种因果图发现方法,结果显示逐行(F1=0.77)与全图方法表现最佳。
THPL框架:用视觉-语言模型驱动虹鳟鱼精准投喂决策
arXiv新研究提出THPL框架,将虹鳟鱼运动轨迹转化为视觉-语言token,通过LoRA微调与反事实mDPO驱动大语言模型做出可解释的精准投喂决策,准确率从33%提升至96.67%。

DeReAct:解耦推理与执行,让AI智能体更可靠
DeReAct提出模块化AI智能体架构,通过外部Critic和Context Manager解耦ReAct的推理与执行。实验显示其对弱模型Pass@1提升达7个百分点,并为强模型带来更可靠的任务轨迹。

CITA框架:让AI工具调用学会"三思而后行"
CITA框架提出"选择先于行动"理念,通过比较推理模型(CIM)融合观测行为、贝叶斯工具图模拟器与LLM语义判断三路信号,解决长程工具调用中的价值评估难题,在多个基准测试中提升Tool F1与任务成功率。
CUE框架:让AI用户模拟器真正贴近真实用户失败模式
arXiv 新论文提出 CUE(校准用户嵌入)框架,解决 AI 用户模拟器缺乏结果校准的问题。无需训练即可让模拟器更忠实复现真实用户导致的智能体失败模式,并在 τ²-Bench 及多场景中展现泛化能力。

反例生成新突破:符号验证器揭示模仿学习陷阱与强化学习修复之道
arXiv 新论文 SymCE 通过每定理符号验证器揭示大模型反例生成中的模仿陷阱:监督微调会让真定理识别能力崩溃,而强化学习不仅修复还超越基线。4B 模型表现超越 7B 专用模型并可泛化到主流数学基准。
FinDialogLens:用事件抽取从金融聊天室中找回漏单交易
arXiv 论文 FinDialogLens 提出混合 LLM 流水线,将金融聊天室漏单识别建模为多方对话事件抽取,GPT-4o 下价格与成交准确率达 92.1%/94.3%,并通过难度感知路由削减 85% 调用、日省 300 美元。

XiangqiBench:中国象棋揭示LLM智能体的闭环短板
arXiv 新研究 XiangqiBench 以中国象棋残局为载体,提出 LLM 智能体的闭环评估基准,揭示转化差距、一致性差距与模拟差距三大短板,指出找到好棋不等于赢得整盘棋。

机器人监狱里"折磨"大语言模型:AI意识之争为何站不住脚
一个"机器人监狱"实验让大语言模型置身受压环境,引发关于AI是否会"受苦"的激烈辩论。本文剖析为何这场争论站不住脚,以及拟人化陷阱背后值得认真对待的AI伦理问题。

本地跑AI模型该买什么硬件?显存与带宽决定一切
本地跑AI大模型该选Mac还是PC?本文用真实跑分解析决定性能的两大参数——内存容量与带宽,给出速度预测公式,并提供从300美元到数万美元的全预算硬件选购指南。

当LLM说"很可能":语言不确定性与人类的鸿沟
arXiv新论文揭示大语言模型在语言不确定性表达上与人类存在系统性错位:模型说的"很可能"并非人类理解的概率。文章解读LLM不确定性量化的新方法METHODNAME及其对AI可靠性的意义。
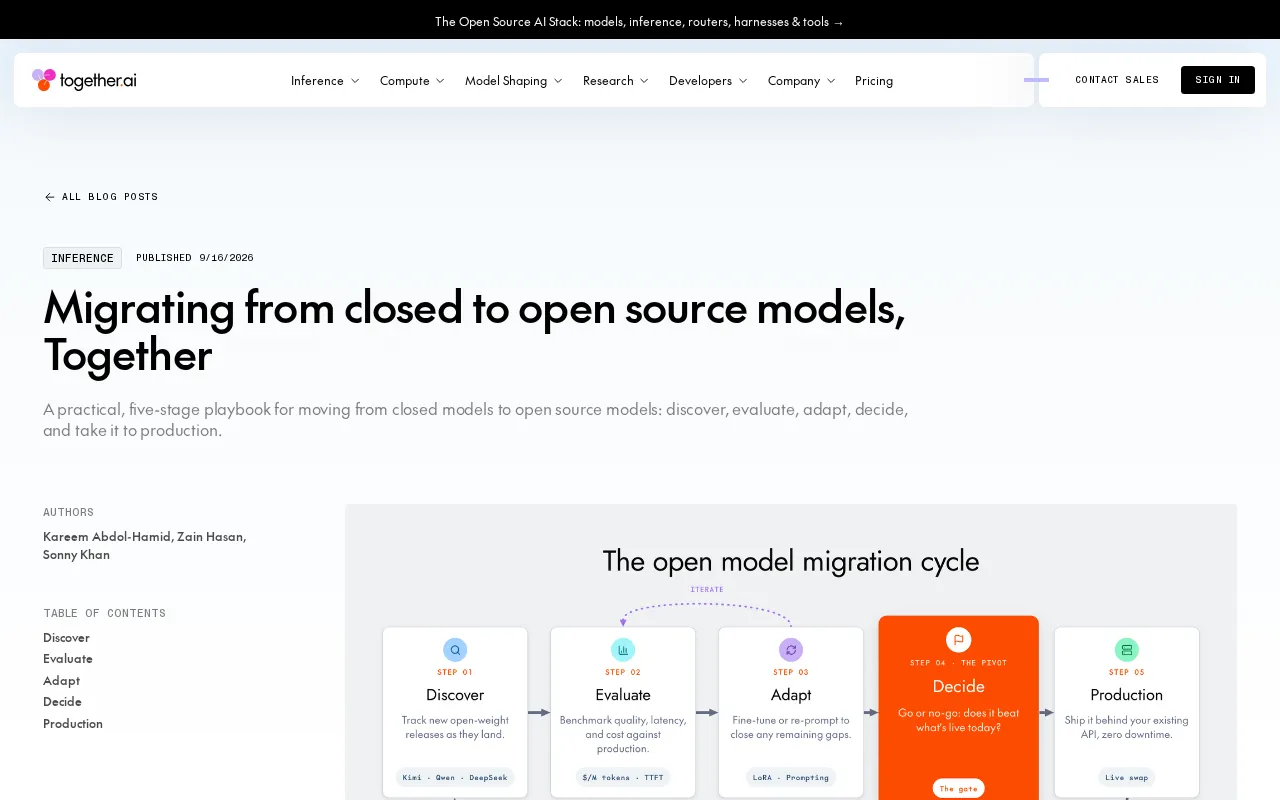
从闭源到开源模型迁移:五阶段实战手册
从闭源到开源大模型迁移未必耗时数年。本文拆解发现、评估、适配、决策与生产五阶段实战手册,帮助企业在数周内完成模型切换,平衡成本、性能与数据自主权。
Aleph Alpha开源Kolibri-1:78B参数仅激活3.46B,支持百万Token上下文
Aleph Alpha开源新模型Kolibri-1,采用MoE架构,总参数78B仅激活3.46B,支持最高100万Token上下文,并以Apache 2.0许可证发布,商用友好。本文解析其技术特点与应用价值。
当AI推理速度达到每秒百万Token,会发生什么?
如果AI推理速度达到每秒百万Token会怎样?本文探讨超高速推理对交互范式、并行探索和AI应用形态的深远影响,以及背后的技术现实与成本约束。

如何用逻辑思维测试AI聊天机器人的真实性
一位Reddit用户提出用情绪化争论测试AI聊天机器人的真实性。本文解析这类逻辑思维测试的原理、破绽点、局限性,并给出更有效的AI逻辑能力测试方法。

GPT-6.1 Sol Max 在 FrontierMath 4 拿满分意味着什么
Reddit 盛传模型 GPT-6.1 Sol (max) 在 FrontierMath Tier 4 基准测试取得 100% 满分。本文梳理该消息来源、解析 FrontierMath 的难度与评测口径,并说明为何对这一成绩应保持审慎。

哈佛物理学家3个月实测:AI 20分钟重现数周研究成果
哈佛物理学家3个月实测AI科研工具:声称20分钟重现数周工作、完成15项物理计算、贡献36篇论文。本文解析这组数据的真实价值与应保持的审慎态度。

用AI挖掘历史:Opus模型发现渡渡鸟新目击记录
研究者利用Anthropic Opus模型在历史文献中发现一条此前被忽略的渡渡鸟目击记录。本文解析大语言模型如何助力历史档案考据,探讨AI在人文研究中的价值、幻觉风险与人机协作范式。

