反例生成新突破:符号验证器揭示模仿学习陷阱与强化学习修复之道

SymCE揭示大模型"证伪缺口",SFT会摧毁真假判断能力,稀疏奖励强化学习可有效修复并超越更大模型。
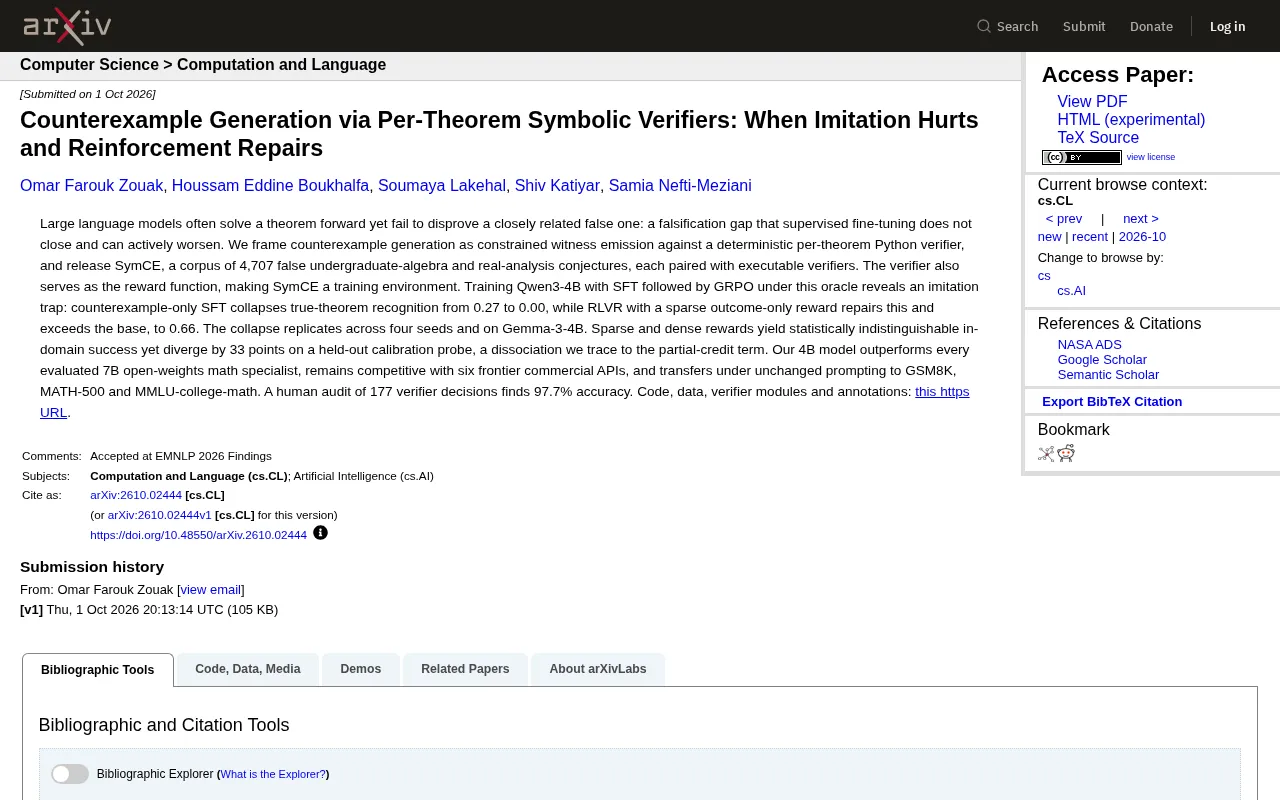
大语言模型在数学推理中存在一个系统性短板:能证明正确定理,却难以对相似的错误命题给出具体反例。arXiv论文SymCE通过构建含4,707条错误猜想、每条配有可执行Python验证器的语料库,深入研究了这一"证伪缺口"。研究最重要的发现是"模仿陷阱":仅用反例数据做监督微调(SFT),会让模型对真定理的识别率从0.27崩溃到0.00,在多个模型和随机种子上均可复现。相比之下,基于可验证奖励的强化学习(RLVR)不仅修复了这一崩溃,还将识别率提升至0.66。此外,稀疏奖励与密集奖励在域内成功率上无差异,但在校准探针上相差33个百分点,揭示了奖励塑形的隐性风险。最终训练出的4B模型超越所有参评7B开源数学模型,并能泛化到GSM8K等主流基准。
大语言模型有个鲜为人知的短板:它能正向证明一个定理,却往往无法反驳一个与之高度相似的错误命题。这种"证伪缺口"(falsification gap)不仅监督微调无法弥合,反而可能让情况恶化。一篇新发布的 arXiv 论文(SymCE)通过构建每定理专属的符号验证器,系统性地揭示了这一现象背后的机制,并给出了用强化学习修复的有效路径。
什么是反例生成任务
反例生成(counterexample generation)本质上是对一个错误猜想给出具体的证伪例子。论文将这一任务重新建模为"面向确定性验证器的约束见证发射"(constrained witness emission)——模型需要针对每个错误命题,产出一个能被 Python 验证器判定为有效的反例。
研究团队发布了 SymCE 语料库,包含 4,707 条本科水平的代数与实分析领域的错误猜想,每条都配有可执行的验证器。这个设计的巧妙之处在于:验证器不仅用于评测,同时直接充当强化学习的奖励函数。换句话说,SymCE 本身就是一个完整的训练环境,而非单纯的静态数据集。
验证器的可靠性经过了人工审计验证——对 177 个验证器判定结果的人工审查显示准确率达到 97.7%,这为后续的训练与评测提供了坚实的真值基础。
GRPO(Group Relative Policy Optimization)是 DeepSeek广告 团队提出的一种强化学习算法,属于 PPO(近端策略优化)的变体。其核心思想是:对同一输入采样一组输出,以组内相对得分代替传统的价值函数估计,从而省去单独训练一个 Critic 网络的开销。在数学推理场景中,GRPO 通常与可验证的最终结果奖励(如答案正确与否)配合使用,让模型通过对比"哪些推理路径最终成功"来自我改进。SymCE 中使用 Python 验证器直接判定反例有效性,天然契合 GRPO 对二元或稀疏奖励信号的偏好,使验证器既是评测工具又能无缝对接训练循环。
模仿陷阱:监督微调为何会"帮倒忙"
论文最引人注目的发现是所谓的"模仿陷阱"(imitation trap)。研究者以 Qwen3-4B 为基础模型,先做监督微调(SFT),再接入 GRPO(一种强化学习方法)进行训练。
结果令人警醒:仅用反例数据做 SFT,会让模型对"真定理"的识别能力从 0.27 直接崩溃到 0.00。也就是说,模型为了学会生成反例,彻底丧失了判断一个命题是否为真的能力——它开始对所有命题都试图构造反例,哪怕命题本身是正确的。
这种崩溃并非偶然。研究者在四个随机种子上重复实验均观察到同样现象,并在 Gemma-3-4B 上得到复现,说明这是监督微调范式本身的系统性缺陷,而非特定模型或训练配置的偶然结果。
监督微调(SFT)的本质是最大化示范数据的对数似然,模型被训练为尽量复现人类(或合成)标注的输出分布。当训练集中的样本几乎全部是"给出反例"的操作时,模型会将"生成反例"这一行为模式与任意数学命题输入绑定,而非学习"先判断真假、再决定是否证伪"的条件逻辑。这种分布偏差在 NLP 中被称为"捷径学习"(shortcut learning):模型利用数据中的表面统计规律而非深层推理来最小化训练损失。SymCE 实验中 Qwen3-4B 在 SFT 后对真定理识别率归零,正是这一机制的极端体现——新学到的输出倾向彻底覆盖了预训练阶段形成的真假判断能力。
强化学习如何修复能力崩溃
与 SFT 形成鲜明对比的是基于可验证奖励的强化学习(RLVR)。当使用稀疏的、仅基于最终结果的奖励信号时,模型不仅修复了被 SFT 破坏的真定理识别能力,还超越了基础模型,将识别率提升到 0.66。
这个对比揭示了一个重要的训练哲学差异:模仿式学习(SFT)让模型机械复制反例生成行为,却因数据分布偏差破坏了原有能力;而强化学习通过与确定性验证器的交互,让模型在探索中自主建立起"何时该证伪、何时该承认为真"的判断边界。
稀疏奖励与密集奖励的微妙分歧
研究还深入对比了稀疏奖励与密集奖励(dense reward)的效果。在域内成功率上,两者的表现在统计意义上无法区分;然而在一个留出的校准探针(held-out calibration probe)测试中,两者的差距高达 33 个百分点。
研究者将这一差异追溯到密集奖励中的"部分得分"(partial-credit)项。这提示我们:看似无害的奖励塑形,可能在泛化与校准层面悄然引入偏差——域内指标相同,不代表模型真正学到了同样可靠的推理能力。
稀疏奖励(sparse reward)与密集奖励(dense reward)的根本区别在于反馈粒度。稀疏奖励只在任务最终完成时给出 0/1 信号,模型必须自行摸索出成功路径;密集奖励则在过程中的每一步或每个子目标给出连续分值,以期加速学习。"部分得分"(partial-credit)是密集奖励的典型实现:即便最终反例无效,只要模型的中间输出满足某些结构条件(如格式正确、数值范围合理)也能获得部分奖励。SymCE 的实验表明,这种中间激励会在域内任务上产生与稀疏奖励相近的成功率,但却悄然扭曲了模型对"何时命题为真"的内在校准——模型可能在追求部分分数的过程中习得了局部捷径,而非真正理解证伪的边界条件,最终导致在分布外的校准探针上出现显著下降。
小模型的惊人表现与泛化能力
这项工作的实用价值同样突出。经过训练的 4B 参数模型,在反例生成任务上超越了所有参与评测的 7B 开源数学专用模型,并且能与六个前沿商用 API 保持竞争力。
更关键的是泛化能力:在提示词完全不变的情况下,该模型的能力可以迁移到 GSM8K、MATH-500 和 MMLU-college-math 等主流数学推理基准上。这说明通过符号验证器训练出的证伪能力,并非针对特定任务的过拟合,而是提升了模型更底层的数学推理素养。
团队已将代码、数据、验证器模块与标注全部开源(github.com/ce-rlvr/SymCE),为后续研究提供了可复现的完整工具链。
对 AI 训练方法论的启示
SymCE 的价值不止于一个反例生成数据集。它用严谨的实验证据给出了几条可推广的结论:
- 监督微调并非总是安全的——在特定任务上,单纯模仿示范数据可能破坏模型已有的核心能力;
- 可验证奖励的强化学习在需要精确判断的场景下,比模仿学习更能建立稳健的能力边界;
- 奖励设计需要警惕"部分得分"等塑形手段带来的隐性校准偏差,域内指标不足以说明问题。
对于正在构建推理模型的团队而言,这些发现提供了关于"何时该用 SFT、何时该转向 RL"的具体决策依据。
相关推荐

私钥设为4?CA机构低级错误致TLS体系裸奔
CA机构eMudra将私钥设为数字4等极小值,导致TLS证书可被暴力破解。Computerphile视频演示了从提取公钥到伪造证书的完整过程,并探讨了PKI信任链的脆弱性。

Gen如何用ChatGPT Work把数据变决策
OpenAI用户案例中,企业领导者Gen分享用ChatGPT Work将数据转化为决策的实践:产品上线几小时内即可判断集成与引导流程是否有效,决策迭代从上百次试错变为快速反馈闭环。

ChatGPT与Claude深度对比:编程强但研究弱,如何弥补?
用户考虑从ChatGPT转向Claude,发现Claude编程更强但研究较浅。本文分析两者差异,并提供让Claude研究更深入的实用技巧,帮助您做出明智选择。