打假Token压缩神话:RTK真能省钱吗?1500美元实测揭穿

烧了1500美元实测证明:RTK等Token压缩工具不仅没省钱,DeepSeek任务成本反涨17%。
一篇耗资逾1500美元、覆盖1744次任务尝试的严格AB测试,彻底戳穿了"压缩Token就能省钱"的流行叙事。以GitHub上拥有79K star的RTK为代表的Token压缩工具,声称可削减90%工具输出、降低60%成本,但实测数据显示:DeepSeek单任务成本不降反涨17%,Claude仅降约5%且几乎全靠单个任务的统计偶然性支撑。根本原因在于,AI Agent的真实成本大头是上下文缓存(占总Token的94%-98%),以及工具信息不足引发的额外对话轮次,而这两者都是压缩插件无法触及的。RTK宣传的"RTK gain"指标统计的是不计费的工具输出字符,与账单毫无直接关联——官方Readme本身也早已写明这一免责声明。降本的正确路径是优化缓存命中率和提示词质量,以任务通过成本而非Token数量为核心指标。
Token压缩=省钱?这个逻辑链正在被打脸
随着按量计费和订阅制成为AI编程工具的主流收费模式,Token消耗成了每个开发者都关心的成本痛点。市场上随之涌现出一批号称能"压缩Token省钱"的项目和插件,其中最火的当属RTK(Rust Token Killer),此外还有Qman、Headroom等同类工具。它们的宣传口径出奇一致:在Claude Code上直接砍掉一半Token,钱包立省50%。
这套叙事听起来天衣无缝——更少的工具输出等于更少的Token,等于更便宜。RTK在GitHub上已经收获79K star,稳坐AI编码降成本头部项目的位置,Twitter上"帮你降60%成本"的推文观看量达31.3万次。但一篇真金白银烧了1500多美元、跑了1700多次任务的实测博文,把这个逻辑链彻底击穿了。
硬核实测:174条任务、1744次尝试的AB对比
这次测试的严谨程度值得一提。测试者选用Terminal Bench 2.1作为终端交互任务集,跑了两条模型线:一条是Claude Code接入的顶尖模型,一条是通过OpenRouter接入Open Code的DeepSeek广告(目前最省钱的模型之一)。
每条任务分别在"不装RTK"和"装RTK"两种条件下各跑五次,采用同路由、同平台、同时段的方式尽量排除干扰因素。剔除因外部原因失败的任务后,最终形成174条任务、1744次尝试的样本量。
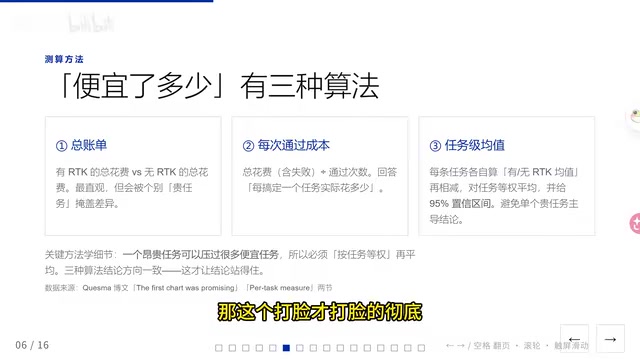
测试还设计了三种成本算法:总账单、每次通过成本、任务级成本,并附带95%置信区间。之所以用三种算法交叉验证,就是为了让"打脸"打得彻底——只有当三种算法都指向"没省钱"时,结论才立得住。
数据说话:不减反增的账单
结果相当难看。先看总账单:Claude线上,无RTK花了731美元,有RTK花了698美元,确实降了约5%,但基本可以忽略。DeepSeek线上,无RTK是51美元,装了RTK反而涨到54美元,成本上升5%。
每次通过成本方面,Claude便宜3%,DeepSeek反而贵7%。最狠的数据出现在任务级成本核算上:Claude成本增加1%(统计上不显著),而DeepSeek的单任务成本暴涨17%,即便只看全通过的36个任务,成本依然提升18%。
质量层面同样没有惊喜。装了RTK之后,Claude的任务通过率掉了1个百分点,DeepSeek掉了2%。也就是说,RTK既没省钱,又拉低了质量,用了跟没用一样,甚至更糟。
RTK gain:一个被精心包装的空指标
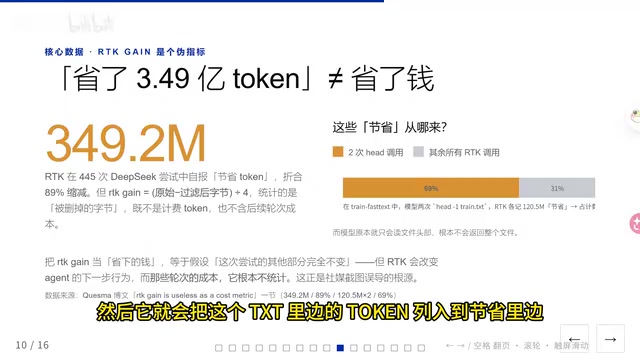
RTK一直宣传的核心卖点是"RTK gain"——在445次DeepSeek尝试里,它自曝节省了349.2M Token,折合约89%的缩减。数字看着吓人,但算法藏着猫腻。
所谓gain的计算方式是"原始输出减去过滤后输出再除以4",统计的是那些被删掉的、根本不计费的Token,也不算后续轮次成本。举个例子:你把一个内容庞大的TXT文档扔给模型,RTK会把整个文档的Token量都算进"节省"里,但实际上模型可能只读了文件名或头部,根本没读全部内容。这就是文字游戏的来源。
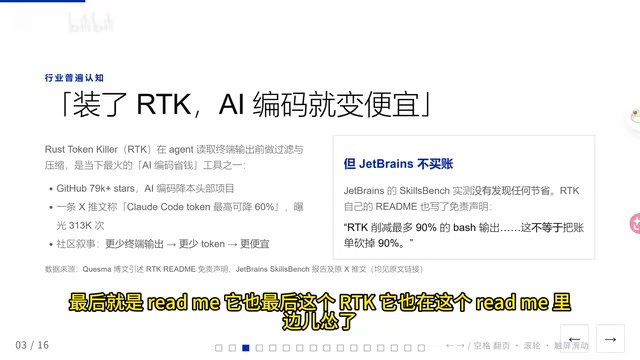
更关键的是,RTK自己也在Readme里写了免责声明:最多减少90%的工具输出,但不等于账单降90%。换句话说,官方早已承认"少读输出"和"少花钱"是两码事。
理解这个问题需要区分AI Agent工作流中几种不同类型的Token。输入Token是每轮对话中发送给模型的所有内容,包括系统提示、历史消息和工具返回结果;输出Token是模型生成的回复;工具输出Token则特指文件读取、命令行执行等工具调用返回给模型的内容,RTK压缩的正是这一类。在大多数API定价体系中(如Claude的Anthropic API),缓存读取Token的单价仅为标准输入Token的1/10到1/30,而一旦上下文被缓存,后续每轮对话的大部分内容都走缓存通道。RTK针对的工具输出Token在整体成本结构中占比极小,即便全部清零,对账单的影响也微乎其微。这正是"Token数量减少"与"账单金额减少"之间产生巨大落差的定价机制根源。
为什么压缩Token省不了钱?三个真相
第一,工具输出的Token占比本就很小。 在无RTK的情况下,工具输出只占非模型输出的7%,加上其他约11%的占比。真正的大头是缓存——上下文每轮都会被缓存,缓存读取占了Token总量的94%到98%。而缓存Token的成本仅相当于普通输入或输出的十分之一甚至三十分之一,命中缓存能大幅拉低账单。问题是,缓存Token压不了。RTK能压的那点输出,相当于挠痒痒。
第二,压单轮反而增总轮。 RTK把工具字符压了9%,但提示Token反而涨了9%;平均单轮输入少了7%,可总轮次却多了18%。多出来的这几轮Agent对话,花的钱远超压缩省下的那点。
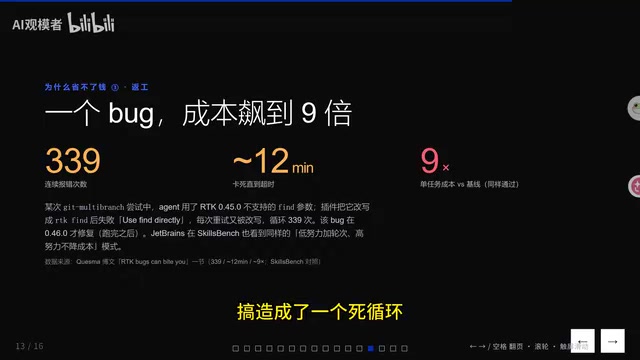
第三,反噬成本。 实测中RTK在压缩时触发了一个Bug,导致死循环——339次连续报错,卡了12分钟才超时,单任务成本直接飙到基线的9倍。虽然任务最终通过了,代价却高得离谱。
还有个反直觉的细节:Claude线上那点1%到3%的"节省",几乎全靠单个任务(Core Wars)撑着。剔除这个任务后,其余任务的节省不到1%,纯属统计误差。
AI Agent的多轮对话特性使得"单轮Token压缩"的收益会被轮次增加所抵消。在Agent工作流中,每次工具调用、代码执行或文件读写都会产生一轮新的上下文追加,整个任务的总成本是所有轮次Token之和,而非某一轮的快照。当RTK压缩了工具返回的内容后,模型可能因信息不足而需要追加提问或重新调用工具,这类"信息补偿行为"直接增加了总轮次。更重要的是,每增加一轮对话,当前的全部上下文就会再次作为输入Token被计费(即便是缓存命中,也会产生缓存读取费用)。因此,在Agent场景下评估任何优化手段,都必须以任务完成为终点、统计全链路成本,而非只看单轮的Token削减量。
给工程团队的四条务实建议
如果你真的想降本,与其迷信压缩插件,不如关注以下几点:
- 盯任务通过成本,别盯Token数量。 RTK gain这类删Token指标,跟最终花的钱毫无关系。
- 优先优化缓存和提示词。 提升缓存命中率、精简提示词,比装任何压缩插件都划算。
- 在自己的工作负载上实测。 收益高度任务相关,有的任务RTK起点作用,有的则起反作用。
- 把RTK定位成微小的优化项,而非省钱神器。 对绝大多数用户来说,这类插件并不适用。
今天打假的其实不止RTK这个插件本身,而是那个被偷换的概念:少读输出 ≠ 少花钱。Token压缩削减的是被读到的字符,但AI Agent的真正成本藏在上下文缓存、额外轮次和任务质量波动引发的误发反噬里——这些,任何压缩工具都压不动。
所以别再幻想装个插件就能省90%的钱了,这个不要信。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。